
自动化测试 / 系统课时
分析偶发失败
分析偶发失败
偶发失败最危险的地方不是“偶尔红一次”,而是它会让真实回归被噪声掩盖。本篇用可重复的定位顺序,把问题拆成等待条件、共享状态、数据竞争和环境波动四类,并用重复执行、单 Worker 对照和 Trace 证据逐步缩小范围。
学习目标
- 用重复执行确认失败概率和触发条件
- 区分等待问题、共享状态、并发竞争与环境波动
- 用 Worker 对照、重试与 Trace 收集可复现证据
先把偶发失败变成证据
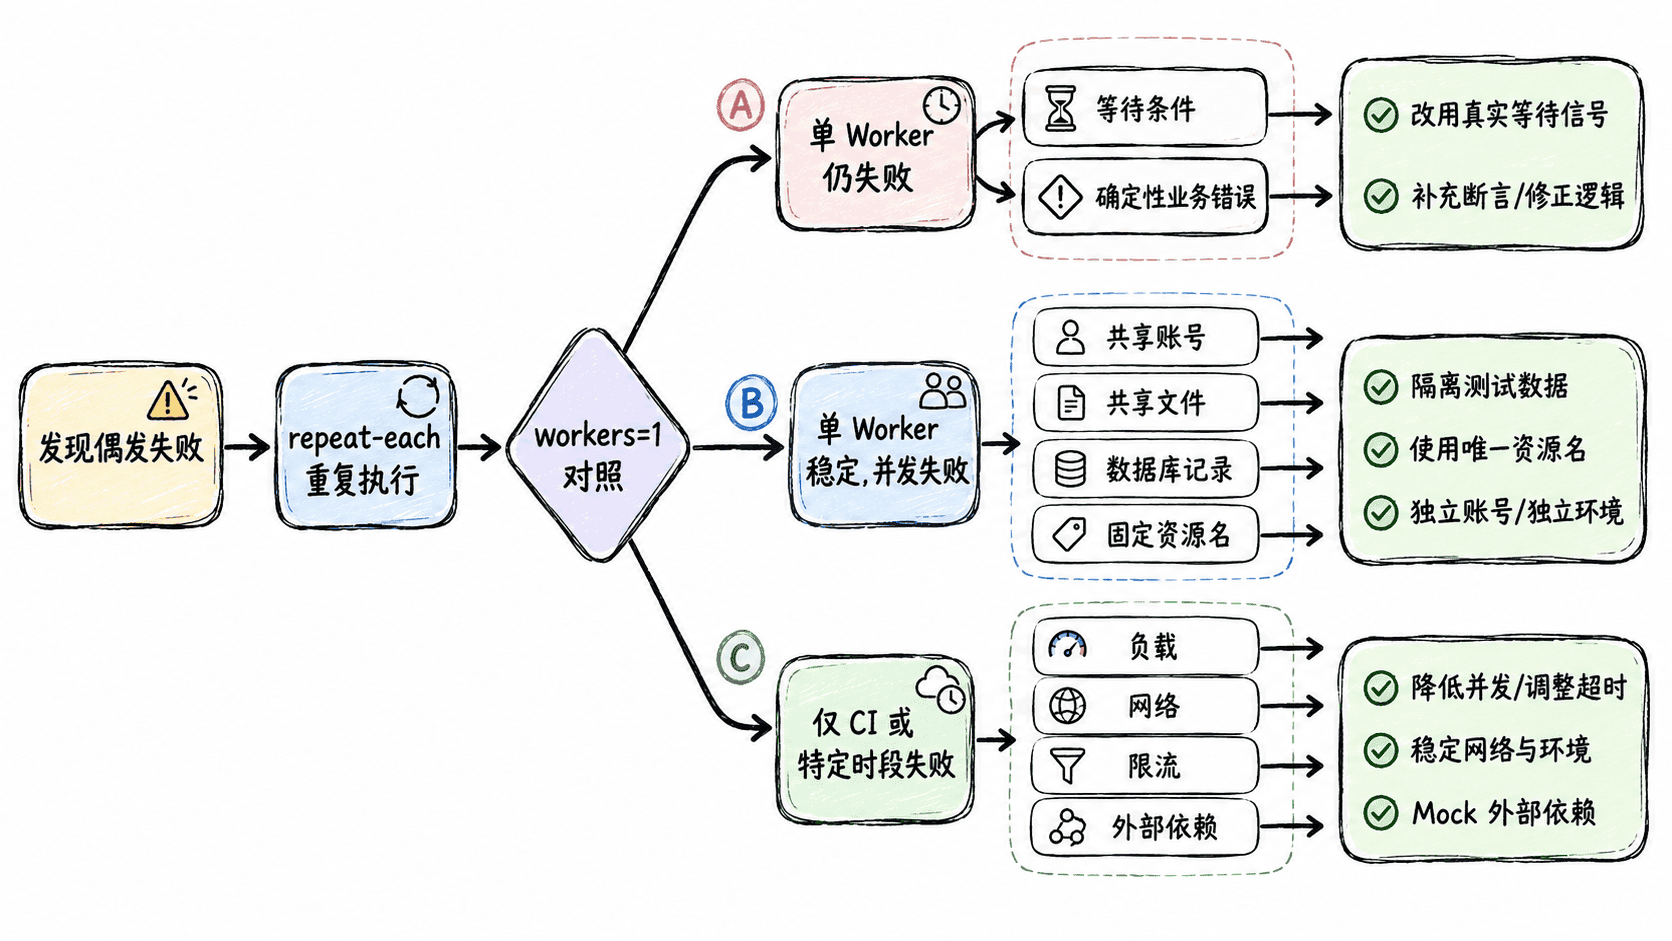
不要一看到失败就增加超时或重试次数。先在同一环境中重复执行测试,再把 Worker 限制为 1 做对照;两次运行的差异,比单次失败堆栈更能说明问题来自测试本身还是并发环境。
npx playwright test --repeat-each=20
npx playwright test --repeat-each=20 --workers=1
预期结果:
第一轮用于观察重复执行时是否出现不稳定结果。
第二轮用于比较单 Worker 下失败是否消失或显著减少。
实际通过数、失败数和耗时取决于当前测试集。
如果单 Worker 仍稳定复现同一失败,优先检查等待条件或确定性的业务错误;如果并发时失败、单 Worker 时稳定,优先检查共享账号、共享文件、数据库记录、固定资源名和其他跨测试资源。
按四类根因定位
等待问题通常表现为元素、接口状态或后台任务尚未达到断言条件。应优先使用 Locator 的 Web-first 断言或针对业务状态的轮询,而不是固定 waitForTimeout,因为固定睡眠既会拖慢测试,也无法保证慢环境一定完成。
共享状态与数据竞争发生在浏览器上下文之外。Playwright 会为测试提供隔离的浏览器上下文,但后端账号、数据库记录、对象存储键、临时文件或第三方沙箱仍可能被多个测试同时修改。让每个测试生成唯一数据,通常比强制串行更可靠。
环境波动则往往和 CI 负载、外部依赖、网络抖动或服务限流同时出现。此时要比较本地与 CI、低并发与高并发,以及失败发生的时间窗口;如果失败只集中在特定环境,应先验证基础设施和依赖健康度,再修改测试逻辑。
用重试收集 Trace
重试可以帮助捕获第二次执行的现场,但不应该被当作修复。可以临时启用一次重试,并在第一次重试时记录 Trace,这样“首次失败、重试通过”的用例会留下可回放的动作、网络和页面状态证据。
import { defineConfig } from '@playwright/test';

export default defineConfig({
  retries: 1,
  use: {
    trace: 'on-first-retry',
  },
});
生效行为是:首次失败后最多再执行一次,第一次重试会保留 Trace。验证时重新运行测试并查看失败或 flaky 用例的附件;如果 Trace 仍无法解释问题,再补充服务端日志或测试数据标识,不要继续无上限增加重试。
用现象决定修复方式
定位时可以用一个简单判断:等待问题修同步条件,共享状态修隔离,数据竞争修唯一性或并发控制,环境波动修依赖稳定性与资源容量。例如并发测试共同编辑同一账号时,正确修复通常是为每个测试准备独立账号或独立数据,而不是把整个测试套件改成串行。
修复后要再次用原来的 --repeat-each 和正常 Worker 数验证。如果只有单 Worker 能通过,问题仍然存在;只有在原并发条件下连续稳定运行,才能说明偶发失败的根因已经真正消除。