
自动化测试 / 系统课时
配置失败重试
配置失败重试
失败重试能让 Playwright 自动再次执行失败用例,但它的价值不是把红灯刷成绿灯,而是区分稳定失败与偶发失败。本课会配置重试次数,观察失败后 Worker 的重新启动,并利用 flaky 分类和首次重试 Trace 保留诊断证据。
学习目标
- 正确理解
retries表示“额外重试次数”而不是总执行次数 - 识别
passed、flaky和failed三种最终结果 - 把重试用于发现偶发问题,而不是掩盖不稳定测试
重试实际改变了什么
Playwright 默认不重试失败测试,即 retries 为 0。配置 retries: 1 后,一条测试最多执行两次:首次执行一次,失败后再额外尝试一次;只要某次重试通过,就停止继续重试。
测试失败时,Playwright 会丢弃当前 Worker 进程及其浏览器,并启动新的 Worker。启用重试后,新 Worker 会先重新执行失败测试;因此 beforeAll 等初始化逻辑也可能再次运行。测试之间越独立,重试结果越可信。
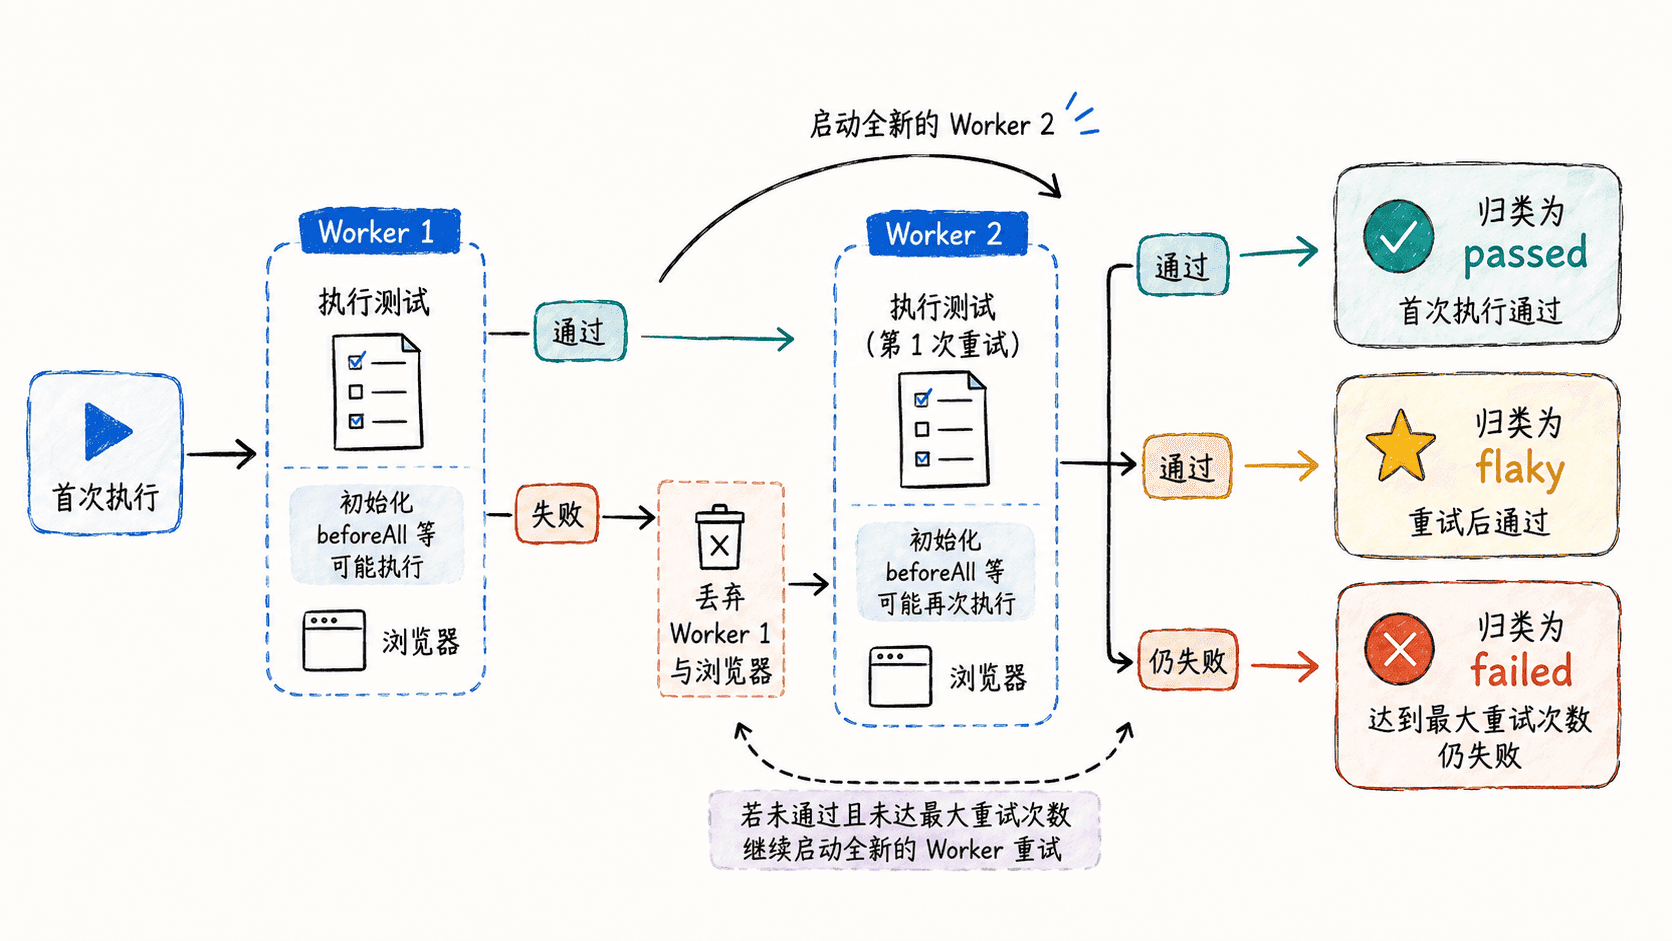
配置一次重试并观察结果
下面用一个受控示例演示分类规则。配置同时启用 trace: 'on-first-retry',这样首次重试会保存 Trace,便于事后查看失败前后的页面、网络和操作记录。
import { defineConfig } from '@playwright/test';

export default defineConfig({
  // retries=1 表示首次失败后最多再执行一次。
  retries: 1,
  reporter: 'line',
  use: {
    // 首次重试时采集证据,避免所有正常用例都产生 Trace 成本。
    trace: 'on-first-retry',
  },
});
测试文件故意让第一次执行失败,并在重试时通过。这个分支只用于教学,生产测试不应通过 testInfo.retry 改写业务预期来制造“成功”。
import { test, expect } from '@playwright/test';

test('演示失败后的第一次重试', async ({ page }, testInfo) => {
  // 固定页面状态,确保失败来自教学分支而不是网络抖动。
  await page.setContent('<p id="state">ready</p>');
  console.log(`retry=${testInfo.retry}`);

  // retry=0 是首次执行;这里故意制造一次确定失败。
  if (testInfo.retry === 0) {
    await expect(page.locator('#state')).toHaveText('done', { timeout: 100 });
  }

  await expect(page.locator('#state')).toHaveText('ready');
});
预期结果:首次执行在 100 毫秒后确定失败,第 1 次重试跳过教学用失败分支并通过,所以 Playwright 最终把该用例分类为 flaky。使用下方命令验证:
npx playwright test tests/retry.spec.ts --workers=1 --reporter=line预期结果的关键部分如下;文件路径、行号和耗时会随环境变化:
retry=0
retry=1
1 flaky
首次失败、重试通过,因此最终不是普通 passed,而是 flaky。如果首次就通过,结果是 passed;如果首次和全部重试都失败,结果才是 failed。
用重试结果定位偶发失败
flaky 是诊断信号,不应被当成“已经修好”。重试通过通常意味着测试或环境存在时序、共享状态、外部服务抖动、选择器不稳定等问题。此时应结合首次失败的错误信息和 Trace 找根因,而不是继续增加重试次数。
testInfo.retry 可以用于记录当前尝试编号,或在重试前执行必要且安全的清理,但不要让断言标准随着重试次数降低。否则测试会把真实缺陷包装成偶发成功,报告也失去可信度。
选择合理的重试策略
本地开发通常保留 0 次重试更容易立即暴露问题;CI 若确实存在不可完全消除的基础设施波动,可以从较小的重试次数开始,并持续统计 flaky 用例。重试次数越高,失败反馈越慢,也越可能掩盖稳定性退化。
如果只有某一组测试需要不同策略,可以用 test.describe.configure({ retries: 1 }) 缩小作用范围。无论采用全局还是局部配置,都应把“重试后通过”保留为可观察事件,并把持续出现的 flaky 测试纳入修复,而不是把重试当作最终解决方案。