
P2P 与分布式存储 / 系统课时
测出 UDP 映射的空闲超时
测出 UDP 映射的空闲超时
通过逐步延长 UDP 发包间隔,可以估算 NAT 网关在没有流量时保留 UDP 映射的时间,并观察映射过期后外部端口是否改变。实验将记录最后一次成功间隔、失效边界和重新建映射后的端口,为选择保活周期提供实测依据。
学习目标
- 区分 UDP 应用无数据、NAT 映射过期和网络路径不可达这三种现象。
- 使用递增的空闲间隔测量映射存活边界,并记录公网映射端口变化。
- 根据重复实验结果选择带安全余量的保活间隔。
实验原理与测量条件
UDP 本身不建立连接状态,但 NAT 设备通常会为经过它的 UDP 流量维护映射或过滤状态。设备在一段时间内没有观察到匹配流量时,可能删除状态;之后再次发送数据,设备可能创建新映射,也可能分配不同的外部端口。
需要区分两个时间:应用两次发送数据之间的空闲时间,以及 NAT 状态实际被回收的时间。一次探测失败只能说明当前探测路径没有收到预期响应,不能单独证明映射已过期。防火墙规则、对端离线、路由变化和丢包都可能造成类似现象。
准备一台位于 NAT 后的客户端、一台具有公网可达地址的 UDP 服务端,以及可查看映射端点的服务端日志。客户端每次都向同一服务端 IP 和 UDP 端口发送带序号的数据报;服务端记录收到的数据报来源地址和端口,并将序号原样回复。固定协议、目标地址和目标端口,避免把不同流产生的映射混在一起。
先验证基线,再逐步延长间隔
开始测量前,先以 2 秒间隔连续发送 10 次数据报。确认服务端均能收到请求、客户端能够收到对应响应,并记录服务端观测到的公网 IP 与 UDP 源端口。如果基线本身不稳定,应先排查网络和防火墙,而不是开始计时。
随后每轮都重新建立可确认的映射,并在收到基线响应后停止发包。建议第一轮空闲 5 秒,再逐轮尝试 10、15、20、30、45、60、90、120 秒。每轮只改变空闲时间,空闲期间不发送应用探测包;否则探测本身可能刷新映射,导致测量结果偏小。
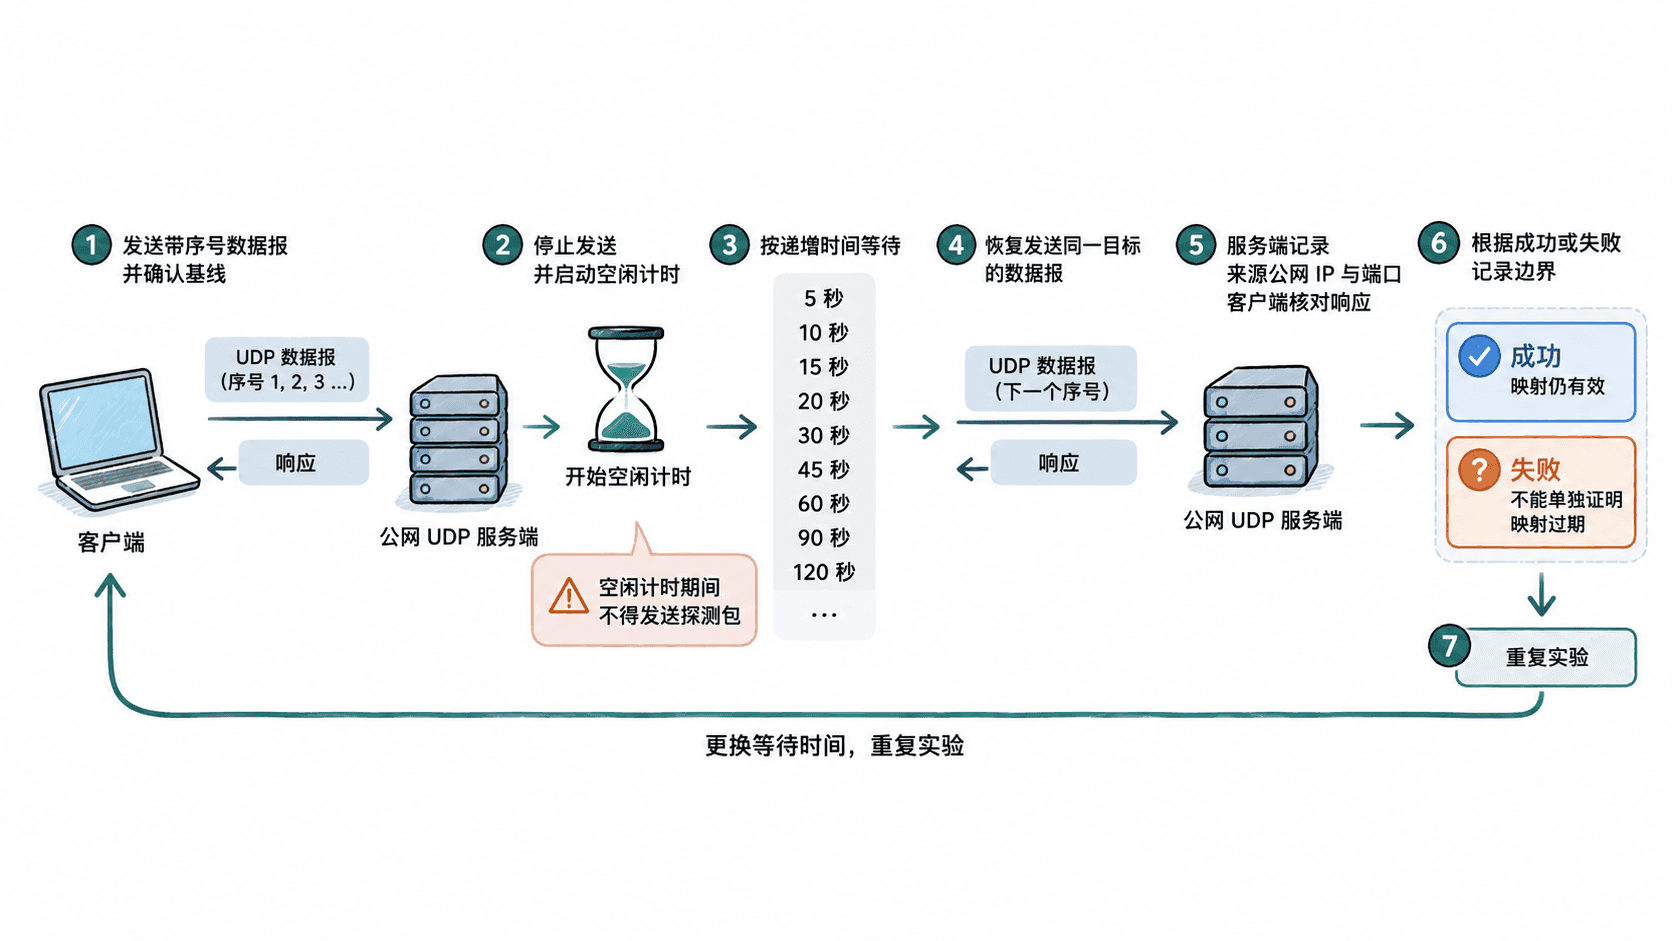
每轮空闲时间结束后,客户端发送一个新的带序号数据报。记录服务端是否收到、客户端是否收到回复,以及服务端看到的公网源端口。建议每个间隔重复至少 5 次,并交错测试较短间隔,确认失败不是暂时性丢包。所有时间均以客户端单调时钟测量,避免系统时间校准影响间隔计算。
用脚本控制空闲间隔并记录端点
下面的 Python 示例运行在 NAT 后的客户端,要求公网 UDP 服务端监听指定端口,并在收到数据报后将数据内容原样发回。服务端日志应记录每次请求的来源 IP 和端口;该客户端会记录每轮发送与回复情况。将目标地址替换为自己控制的服务端地址,服务端必须允许相应 UDP 流量通过防火墙。
import socket
import time

SERVER = ("<SERVER_IP>", 40000)
INTERVALS = [5, 10, 15, 20, 30, 45, 60, 90, 120]
REPEAT = 5

with socket.socket(socket.AF_INET, socket.SOCK_DGRAM) as sock:
    sock.settimeout(3.0)
    for idle_seconds in INTERVALS:
        for trial in range(1, REPEAT + 1):
            payload = f"probe:{idle_seconds}:{trial}".encode()
            sock.sendto(payload, SERVER)
            try:
                reply, peer = sock.recvfrom(2048)
                baseline_ok = reply == payload
            except socket.timeout:
                baseline_ok = False
            if not baseline_ok:
                print(f"baseline_or_reply_failed interval={idle_seconds}s trial={trial}")
                continue

            time.sleep(idle_seconds)
            sock.sendto(payload, SERVER)
            try:
                reply, peer = sock.recvfrom(2048)
                if reply == payload:
                    print(f"reply_ok interval={idle_seconds}s trial={trial} peer={peer}")
                else:
                    print(f"reply_mismatch interval={idle_seconds}s trial={trial}")
            except socket.timeout:
                print(f"timeout interval={idle_seconds}s trial={trial}")
预期输出(实际结果取决于网络、NAT 设备和服务端配置):
reply_ok interval=5s trial=1 peer=('203.0.113.10', 40000)
reply_ok interval=10s trial=1 peer=('203.0.113.10', 40000)
timeout interval=120s trial=1
上述地址仅为示例格式,不代表真实测量结果。脚本复用同一个 UDP 套接字,便于观察同一本地端点与同一目标之间的映射行为。它会先发送基线数据报,再等待指定间隔;因此实际被测空闲时间从基线响应后开始。注意,若基线或返回报文超时,该轮不会形成有效的空闲超时结论,应修复基线问题后重测。
判断失效边界与端口变化
把每轮结果写入实验表,至少包含试验编号、空闲间隔、请求是否到达服务端、响应是否返回客户端、服务端观测到的公网 IP 和端口,以及是否重建了本地套接字。服务端收到请求但客户端收不到回复,与服务端根本没收到请求,是两种不同的故障证据。
例如,30 秒间隔 5 次全部成功,45 秒间隔 5 次中有 2 次失败,60 秒间隔 5 次全部失败,说明转折区域可能在 30 至 60 秒之间,但不能直接把 45 秒认定为设备的固定超时。应针对 35、40、45、50 秒增加测点,每个测点重复多次,并交错复测 10 秒间隔作为网络稳定性对照。
如果服务端观察到的来源端口从 51000 变为 53124,这表明观察到的公网端点发生了变化;它可能由映射重建、端口分配策略或路径变化引起。若套接字仍在、目标端点不变而端口变化,应保留完整日志并增加重复测试,不要仅凭一次变化断定 NAT 超时。若服务端完全未收到第二个数据报,则还需要排查客户端出口、防火墙和路由。
从测量结果选择保活周期
保活周期应短于实测中较保守的映射失效时间,并留出网络抖动和调度延迟余量。假设多轮实验显示 35 秒及以下基本稳定,而 45 秒附近开始出现失效,可先将候选保活间隔设为 20 秒,再在真实运行环境进行长时间验证。这个数值只是基于该假设结果的起始值,不是所有 NAT 都适用的标准。
保活报文应使用真实连接所依赖的协议、目标端点和套接字;额外创建一个不同目标的 UDP 套接字,未必能刷新原有映射。还需考虑移动网络切换、路由器重启和运营商级 NAT:即使定期保活,也不能保证外部端点永久不变。实际应用应将映射变化视为可能事件,并在检测到不可达时重新进行连接协商。
完成实验后,保留原始时间戳、请求序号、服务端来源端点及每轮结果。只有当基线稳定、重复结果一致且失败分支有服务端证据支持时,才将测得的区间用于配置保活策略。