
P2P 与分布式存储 / 系统课时
超时后如何安排探测重试
超时后如何安排探测重试
UDP 打洞探测没有及时收到响应时,不能无限重发,也不能一直等待直连成功。本课设计一个带重试上限和绝对截止时间的探测状态机,并为后续 ICE 连通性检查或 TURN 中继预留时间,避免连接流程因单一路径超时而卡住。
学习目标
- 根据探测间隔、最大次数和截止时间计算重试计划。
- 实现有界重试,并区分单次超时与整个连接尝试超时。
- 为 ICE 检查和 TURN 回退保留明确的时间预算。
先定义每种超时的含义
探测重试需要区分三个时间边界。单次响应超时表示等待当前探测响应多久;重试间隔表示两次发送之间至少等待多久;连接截止时间则规定整个直连阶段最晚何时结束。三者不能互相替代。
例如,首次探测在第 0 秒发出,等待 500 毫秒后仍未收到响应,可安排下一次探测;但如果直连阶段将在第 3 秒截止,即使还没用完最大重试次数,也必须停止继续发送。
| 参数 | 示例值 | 用途 |
|---|---|---|
responseTimeoutMs |
500 | 单次探测的等待上限 |
retryDelayMs |
300 | 超时后额外等待时间 |
maxAttempts |
4 | 包含首次发送在内的总发送次数 |
directDeadlineMs |
3000 | 直连阶段相对开始时刻的截止时间 |
iceReserveMs |
5000 | 为后续 ICE 检查保留的预算 |
turnReserveMs |
4000 | 为 TURN 分配与中继建连保留的预算 |
这些值是演示配置,不是所有网络环境都适用的固定标准。实际参数应根据实测 RTT、丢包率、NAT 映射空闲时间,以及应用允许的总连接时延调整。
使用带上限的退避策略
固定间隔便于预测,但在多个客户端同时启动时,可能让大量数据报集中到达。可以采用逐步增加的退避间隔,例如 300、600、1200 毫秒,并设置最大间隔。每次发送都要检查截止时间,避免最后一次等待越过预算。
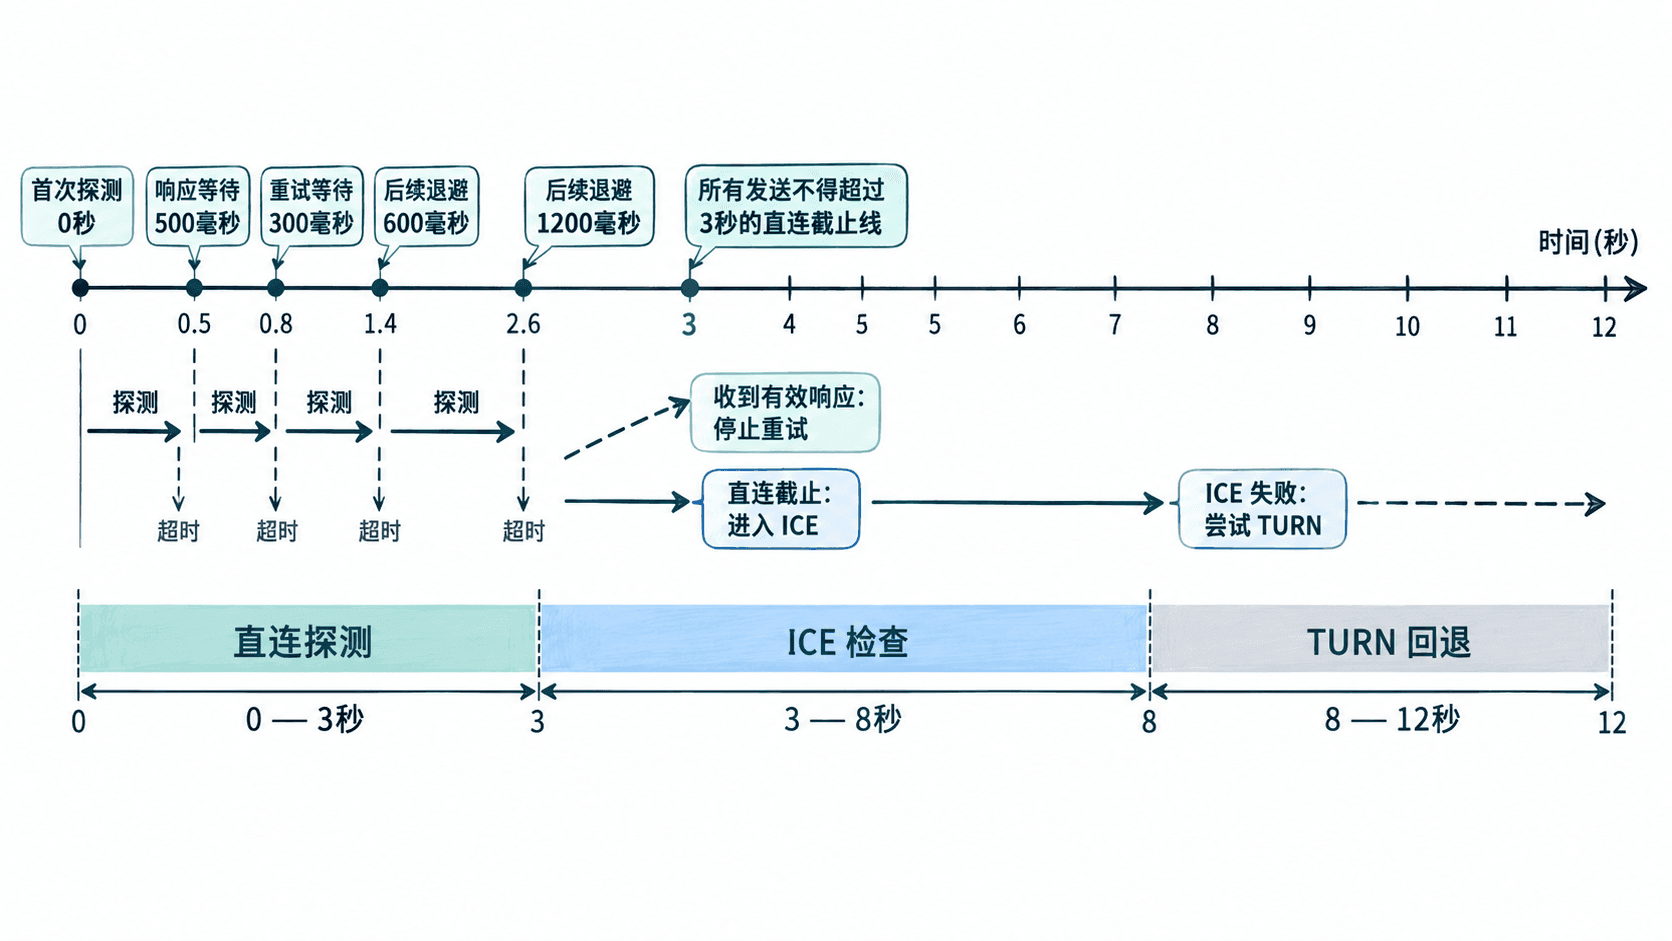
退避公式可以写为:第 次重试等待时间为 ,其中 为初始间隔。若初始间隔为 300 毫秒、最大间隔为 1200 毫秒,前三次重试的等待时间依次为 300、600、1200 毫秒。随机抖动可进一步降低群体同步重试的概率,例如在计算结果的 80%~120% 范围内随机取值,但仍须受截止时间约束。
实现可运行的重试计划
下面使用 Python 3.10 或更高版本,根据单次响应超时、退避间隔、最大尝试次数和绝对截止时间计算实际发送时刻。该示例只负责计划和边界验证,不直接发送 UDP 数据报;真正的网络程序应在每次发送前重新检查状态,并在收到有效响应后取消尚未执行的任务。
from dataclasses import dataclass


@dataclass(frozen=True)
class RetryConfig:
    response_timeout_ms: int = 500
    initial_delay_ms: int = 300
    max_delay_ms: int = 1200
    max_attempts: int = 4
    deadline_ms: int = 3000


def plan_attempts(config: RetryConfig) -> list[int]:
    values = (
        config.response_timeout_ms,
        config.initial_delay_ms,
        config.max_delay_ms,
        config.max_attempts,
        config.deadline_ms,
    )
    if any(value <= 0 for value in values):
        raise ValueError("all configuration values must be positive")
    if config.initial_delay_ms > config.max_delay_ms:
        raise ValueError("initial delay cannot exceed maximum delay")

    # 第一次发送发生在0毫秒,后续发送必须在截止时间之前开始。
    times = [0]
    current = 0
    delay = config.initial_delay_ms

    for _ in range(config.max_attempts - 1):
        next_time = current + config.response_timeout_ms + delay
        if next_time >= config.deadline_ms:
            break
        times.append(next_time)
        current = next_time
        delay = min(delay * 2, config.max_delay_ms)

    return times


config = RetryConfig()
print(plan_attempts(config))
预期输出
[0, 800, 1900]在此配置下,探测分别计划于 0、800 和 1900 毫秒发出。下一次计划时刻为 3600 毫秒,已经超过 3000 毫秒的截止时间,因此不会加入计划。这里的 max_attempts 是发送总次数上限,并不保证一定用满;截止时间优先级更高。
真实实现中,还应把计划时刻转换为单调时钟上的绝对时间,并在调度器实际执行发送时再次核对截止时间。不能只依赖定时器,因为线程调度延迟可能让已经过期的任务晚到执行。
把重试状态接入连接状态机
状态机至少需要区分 Probing、DirectConnected、IceChecking、TurnConnecting 和 Failed。首次探测前进入 Probing;任何有效的匹配响应都应停止后续重试并尝试确认直连;收到响应但后续数据通道不可用时,不能误判为连接成功。
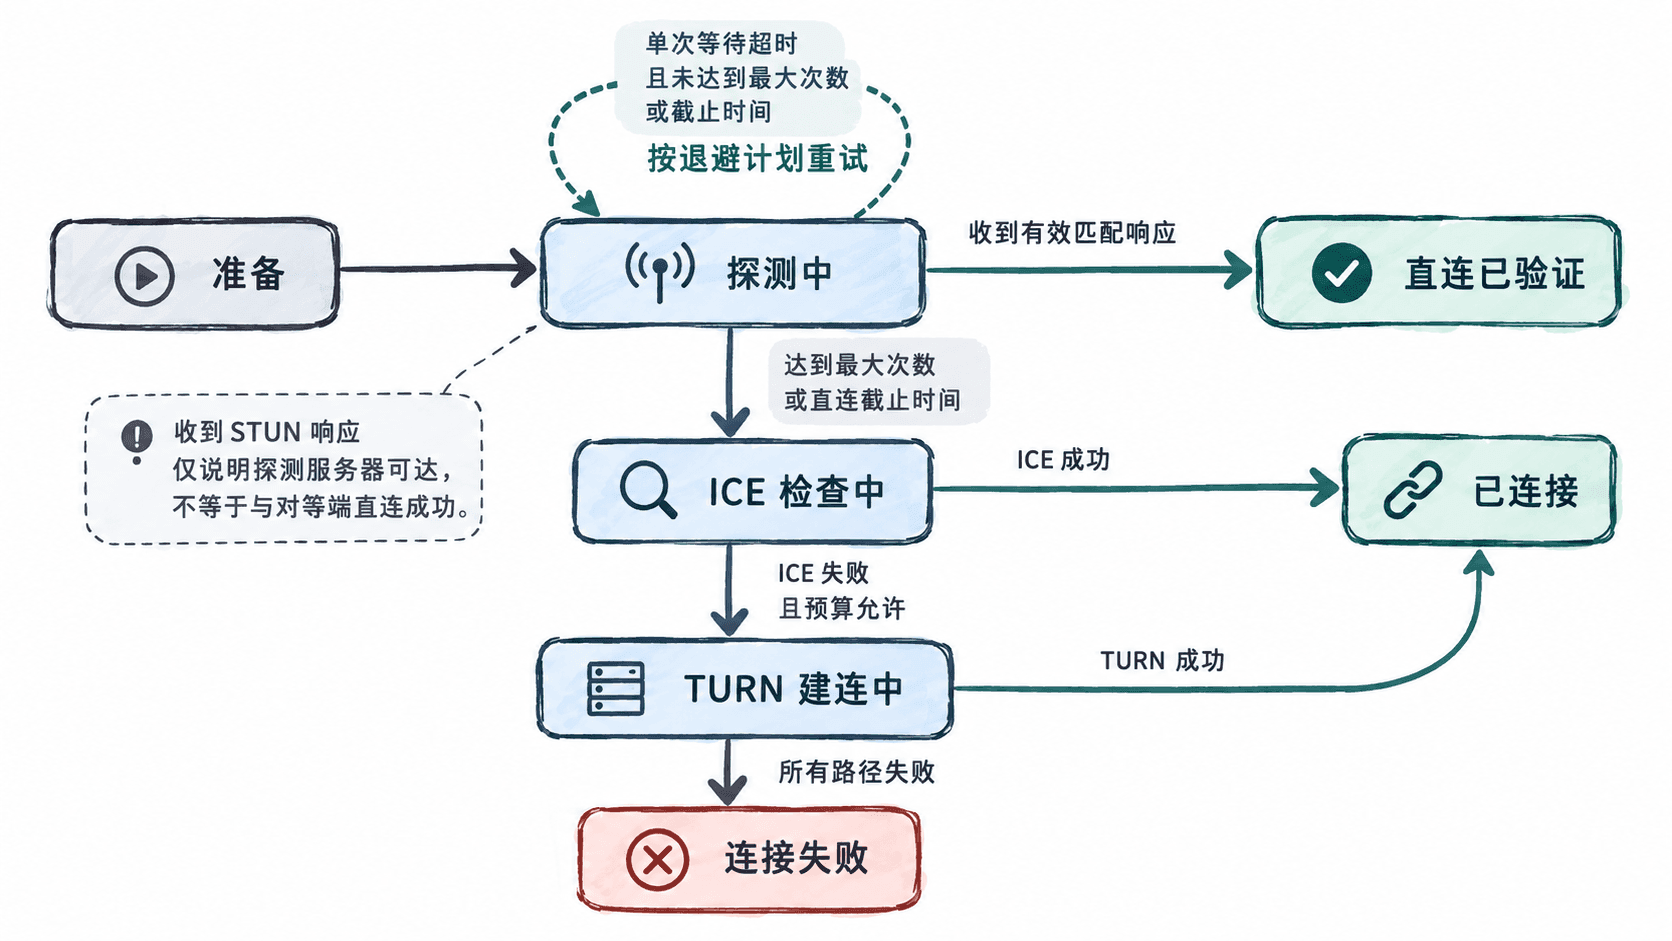
每个状态转换都应该有条件和副作用。进入 Probing 时初始化发送次数与截止时间;发生重试时增加计数并记录发送时间;进入其他状态时取消未执行的探测任务。收到重复响应时,要按事务标识、对等节点身份和当前连接代次进行校验,避免旧连接的响应误触发新连接状态。
为 ICE 和 TURN 保留时间预算
总连接预算应在开始时确定。假设应用允许最多等待 12 秒,可采用以下示例分配:直连探测 3 秒、ICE 检查 5 秒、TURN 回退 4 秒。某阶段提前成功时即可结束连接流程;某阶段失败时只使用预分配预算,不把所有剩余时间重新交给重试循环。
各阶段的截止时间应由同一个单调时钟基准计算。例如连接开始时记为 start,那么直连截止时间为 start + 3s,ICE 截止时间为 start + 8s,整个连接截止时间为 start + 12s。这样即使调度器延迟或阶段转换耗时,也不会无意中把总时长延长。
还要区分 ICE 检查与应用层超时:ICE 的候选对检查有自己的调度与超时机制,应由所用 ICE 实现管理;应用层在外部设置阶段截止时间时,应通过支持的取消接口停止后续工作,而不是另外并行发送一套冲突的探测请求。TURN 也需要预留分配、权限创建和通道建立等操作时间,不能把整个剩余预算只用于分配请求。
处理取消、迟到响应与日志
当直连已经验证成功、用户取消连接或总截止时间已到时,应停止创建新的探测任务。UDP 本身不保证可靠、有序或恰好一次交付,因此即使本地停止重试,网络中仍可能出现已经发出的迟到数据报。接收端应忽略与当前事务或连接代次不匹配的响应,并为过期状态设置清晰的终止条件。
建议每次尝试至少记录 peerId、attempt、sentAt、deadlineAt、result 和 fallbackReason。例如,result 可使用 timeout、response_received、cancelled;fallbackReason 可记录 attempt_limit 或 deadline_reached。日志中避免记录认证凭据、长期有效的访问令牌或不必要的完整公网地址。
验收时分别模拟三种情形:首个探测成功后不再发送;所有探测无响应时在截止时间到达后停止;直连失败时在预算允许的情况下进入 ICE,并在 ICE 失败后尝试 TURN。最终检查连接尝试耗时没有超过 12 秒预算,且任何终止状态都不会重新启动旧的探测任务。