
Web 服务器与网关 / 系统课时
为什么不能直接照抄优化参数
为什么不能直接照抄优化参数
一套参数在大文件下载站表现良好,换成短接口或长连接服务可能增加延迟与资源占用。本篇把优化视为有基线、单项变化和回退条件的实验,用一组固定数据说明延迟分位数改善也可能伴随不可接受的错误率上升。
学习目标
- 根据请求特征和系统约束提出可验证假设。
- 同时检查延迟、错误率与资源占用。
- 为参数调整定义停止条件和回退步骤。
先描述要解决的问题
不要从网上的大数值开始。先记录版本、CPU 与内存配额、文件限制、请求大小、并发、协议和上游能力,再指出瓶颈证据:是连接不足、上游慢、压缩 CPU 高,还是缓冲临时磁盘繁忙。
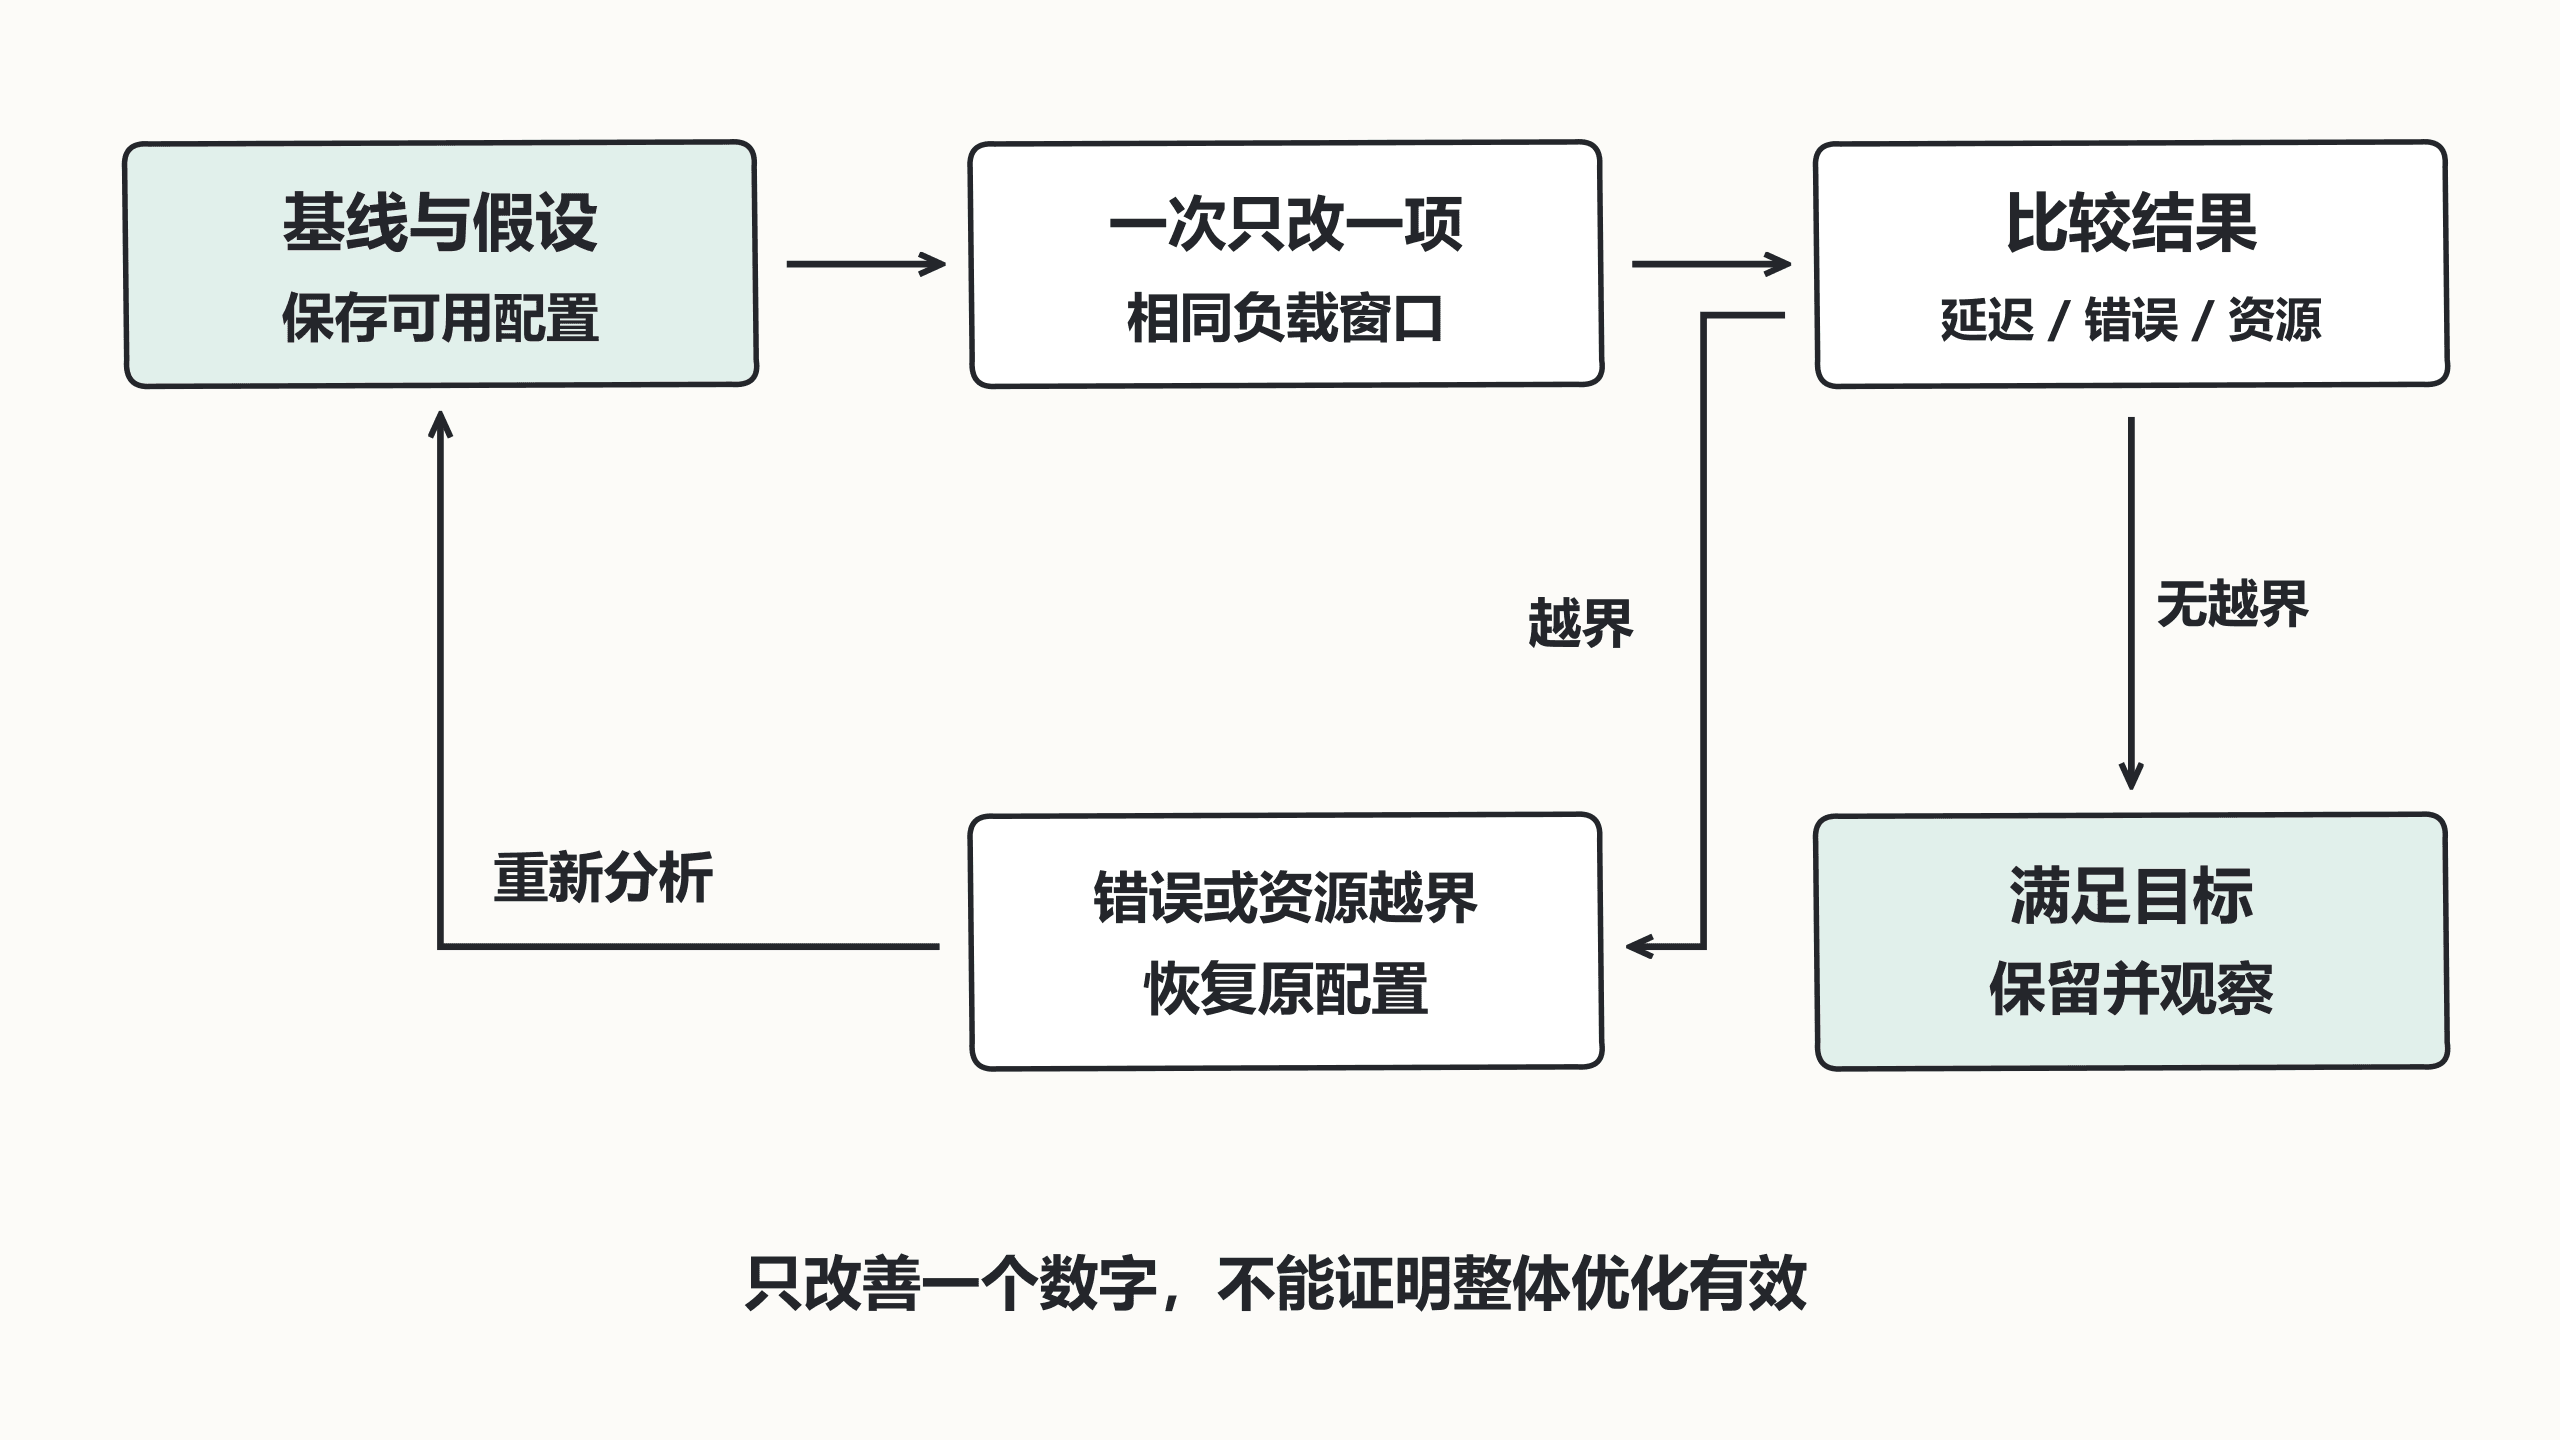
例如“增大读取超时减少 504”可能只是让相同慢请求等待更久,并增加活动并发。应事先定义端到端等待预算,不能只把错误码变少作为成功。
用固定数据练习判断
以下完整 Python 3 程序是教学数据,不是本机压测结果。使用最近秩方法计算 P95:排序后取向上取整的 95% 位置,同时计算全部请求的失败比例。
from math import ceil

before = [(200, 100)] * 90 + [(200, 200)] * 10
after = [(200, 80)] * 95 + [(504, 2000)] * 5

def report(name, rows):
    times = sorted(ms for status, ms in rows)
    p95 = times[ceil(0.95 * len(times)) - 1]
    errors = sum(status >= 500 for status, ms in rows)
    error_rate = errors / len(rows)
    print(f'{name}: n={len(rows)} p95={p95}ms errors={error_rate:.1%}')
    return error_rate

old_errors = report('before', before)
new_errors = report('after', after)
print(f'rollback={new_errors > old_errors}')
预期输出:
before: n=100 p95=200ms errors=0.0%
after: n=100 p95=80ms errors=5.0%
rollback=True
P95 下降仍不能覆盖 5% 请求失败的问题。本例只演示判断逻辑;真实服务应同时看尾部、吞吐、超时、业务正确性和资源,而非机械地规定任何微小波动都自动回退。
比较条件必须一致
| 要固定或记录的条件 | 不一致造成的偏差 |
|---|---|
| 请求类型与大小比例 | 小文件比例增加看似变快 |
| 并发、速率与连接复用 | 握手成本和等待量不同 |
| 缓存冷热与预热时间 | 把缓存命中误判为参数收益 |
| 上游版本与容量 | 后端变化混入代理结果 |
重复多个稳定窗口,避免把启动、重载和偶然低流量作为优化成果。HTTP 延迟统计应说明是否包含失败请求及测试端是否能发出目标负载,防止只统计成功的快速样本。
参数之间存在资源交换
连接数更大需要更多 FD 和内存;超时更长可能留下更多等待;缓冲更大可能增加并发内存;压缩更强可能增加 CPU。先做预算,再在受控路径或少量实例改变一项,观察收益与副作用。
检查配置语法、协议行为与错误响应同样必要。nginx -t 只能证明配置可接受,不能证明吞吐提高,也不能证明应用授权或响应内容正确。
把回退写进实验记录
保存原配置、改变项、理由、负载条件、采样窗口与阈值。超过错误率、延迟或资源阈值时恢复原配置,检查并重载,再复测关键路径;不要继续叠加新参数使原因无法辨认。
当没有改善或结果不稳定时,记录“未证明有效”并保留基线是有价值的结果。最终参数属于某一版本和某种负载下的选择,业务增长或部署变化后仍需重新验证。