
Web 服务器与网关 / 系统课时
Keep-Alive 为什么能减少连接开销
Keep-Alive 为什么能减少连接开销
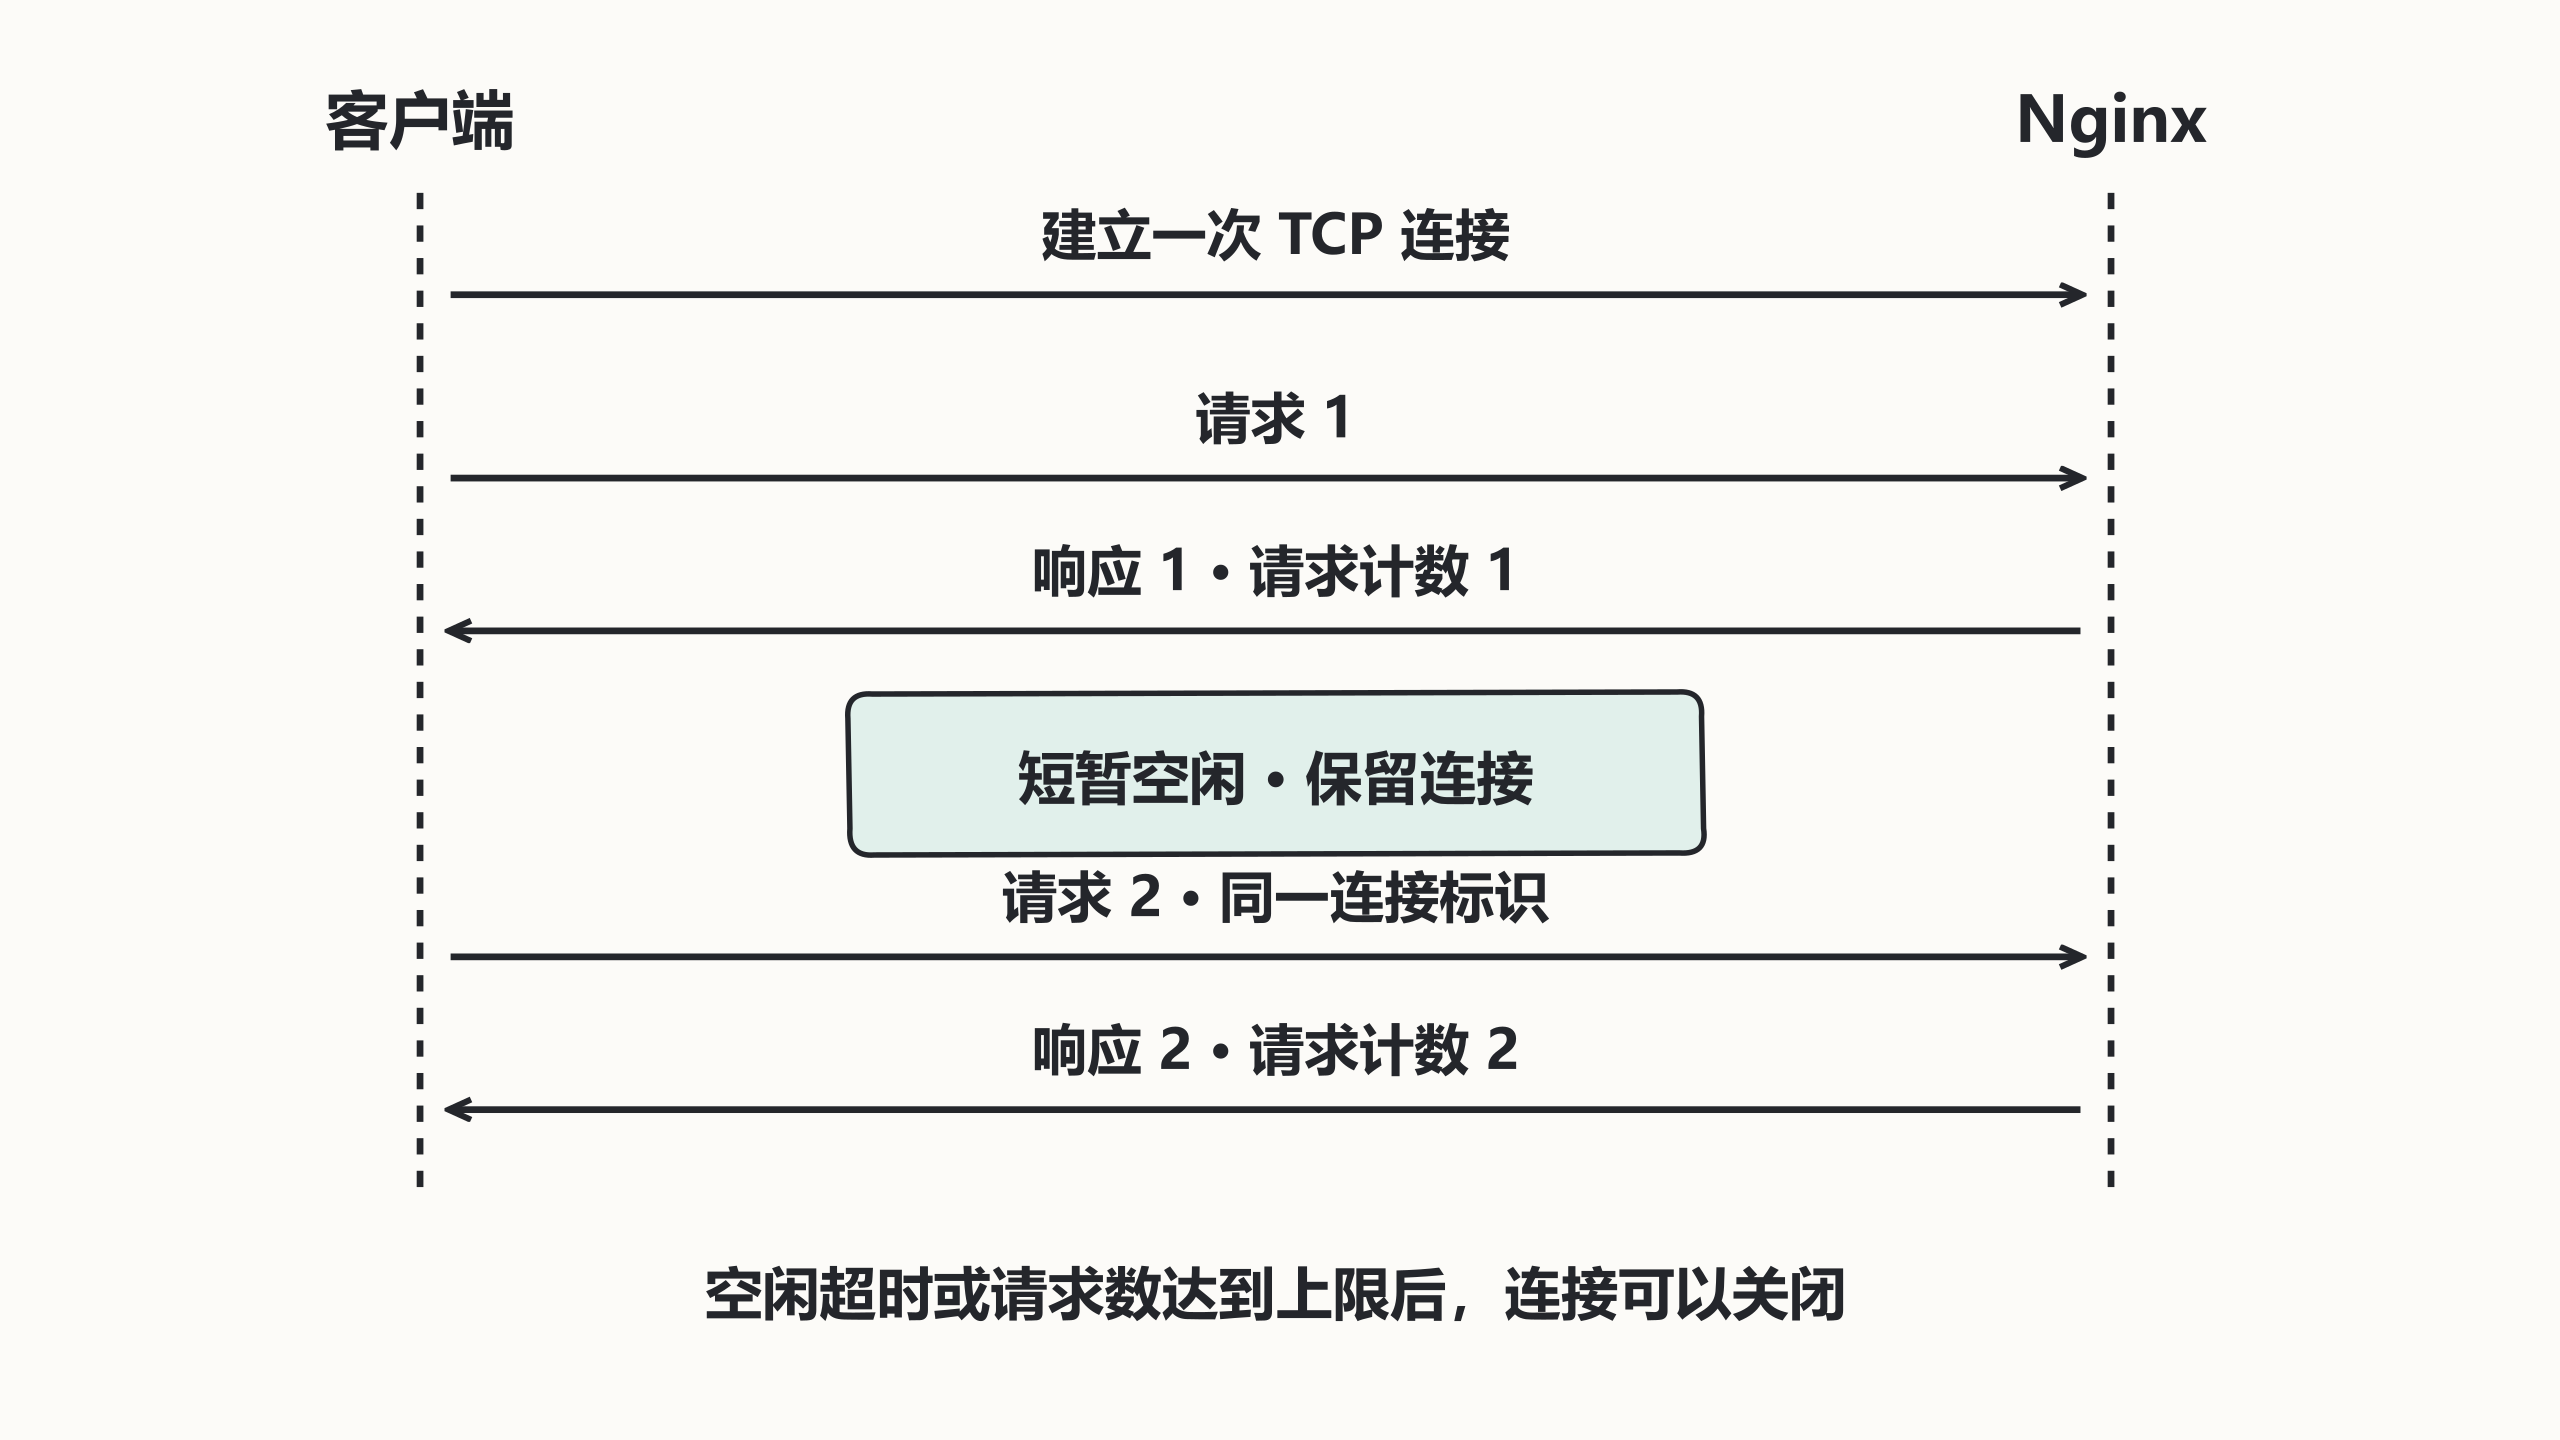
一个页面会请求多个资源,如果每次都重新建立连接,会反复支付连接建立和可能的 TLS 握手成本。本篇用同一条 HTTP/1.1 连接连续发出两次请求,观察连接标识和请求计数,再说明空闲连接保留时间的资源代价。
学习目标
- 理解连接复用减少重复建立连接的作用。
- 在日志中确认两个请求是否属于同一连接。
- 区分客户端长连接、上游连接池与 TCP 保活。
同一条连接可以承载后续请求
Keep-Alive 允许响应结束后暂时保留连接,后续请求可以复用;它不保证所有请求都复用,也不是让每个请求永不超时。HTTP/2 的多路复用属于更进一步的协议行为,本实验只演示 HTTP/1.1 顺序请求。
配置短时空闲保留并记录证据
实验需要 Nginx 1.28、Python 3、空闲回环 8080,以及已创建且 Worker 可写的 /tmp/nginx-keepalive-lab。以下片段示例放在 http:
log_format keep_lab '$connection $connection_requests $status';
server {
    listen 127.0.0.1:8080;
    server_name keep.test;
    keepalive_timeout 5s;
    keepalive_requests 100;
    access_log /tmp/nginx-keepalive-lab/access.log keep_lab;
    location = /ping { return 200 "ok\n"; }
}
keepalive_timeout 约束客户端连接的空闲保留,keepalive_requests 限制一条连接可处理的请求数量;这些值仅为实验选择。官方长连接配置说明
检查并重载后运行完整 Python 程序:
import http.client

conn = http.client.HTTPConnection("127.0.0.1", 8080, timeout=3)
try:
    ports = []
    for _ in range(2):
        conn.request("GET", "/ping", headers={"Host": "keep.test"})
        response = conn.getresponse()
        print(response.status, response.read().decode().strip())
        ports.append(conn.sock.getsockname()[1])
    print(f"same-socket={ports[0] == ports[1]}")
finally:
    conn.close()
预期输出:
200 ok
200 ok
same-socket=True
读取完整响应体后才发送下一次请求。对应 access.log 两行首列连接标识相同,第二列依次为 1、2,状态均为 200;标识值动态,日志可能同时包含其他请求,需对应这次测试。
空闲连接也有代价
空闲套接字仍占用连接槽位、FD 和一定内存。过长的保留时间在大量短时访客下可能占据资源;过短则降低复用机会。应结合客户端行为、连接数、复用比例与网络成本选择,而非一律设得很大。
可在独立实例将 keepalive_timeout 改为 0 关闭客户端长连接,验证日志中连续请求不再共用连接;不能直接沿用上面要求 conn.sock 非空的程序,而应按关闭连接的情况重新连接。
三种相似概念分开检查
| 配置或机制 | 连接在哪一侧 |
|---|---|
| 客户端 HTTP Keep-Alive | 浏览器或调用方与 Nginx |
| upstream keepalive 连接池 | Nginx Worker 与后端 |
| TCP keepalive 探测 | 操作系统检测长期空闲对端 |
开启一侧复用不会自动保证另一侧复用,TCP 探测也不等于允许多个 HTTP 请求共用连接。比较性能时记录请求量与新建连接量,区分正常空闲、慢响应和连接泄漏;本实验只证明复用行为,没有测量公网握手收益。