
操作系统 / 系统课时
从 OOM 日志还原现场
从 OOM 日志还原现场
OOM 发生后,真正困难的不是找到“进程被杀”那一行,而是把当时的内核决策、cgroup 限制、进程内存和重启行为拼回同一条时间线。本节用可复核的证据链还原现场,并区分受害进程与真正根因。
学习目标
- 区分系统级 OOM 与 cgroup 范围内的 OOM,确定排查边界。
- 从内核日志、cgroup 计数器和监控指标中还原事件前后的资源状态。
- 判断被杀进程是直接根因、限制配置问题,还是其他内存增长的受害者。
先判断 OOM 的作用范围
看到 Killed process 不能立即下结论。Linux 可能因为整机可用内存耗尽触发全局 OOM,也可能因为某个 cgroup 达到 memory.max,只在该控制组内部选择进程终止。两种情况的处置方向完全不同。
| 证据 | 更可能说明什么 | 排查重点 |
|---|---|---|
| 内核日志出现系统范围 OOM 信息 | 整机内存压力已经无法通过回收解决 | 全机工作集、Swap、匿名页、并发负载 |
某 cgroup 的 oom、oom_kill 增长 |
该控制组达到自身内存边界 | memory.max、组内进程、容器或服务限制 |
| 进程被杀后整机仍有明显可用内存 | 更应检查局部限制,而非只看主机总内存 | cgroup、容器或 systemd 单元配置 |
memory.events 中的计数是累计值,因此单独看到 oom_kill=3 不能证明第三次事件刚刚发生。需要与故障前的采样值、监控增量或事件时间对齐。
保全内核与限制证据
先围绕告警时间截取内核日志。下面命令适用于使用 systemd journal 的系统;把 <TIME_START> 和 <TIME_END> 替换成故障前后几分钟的实际时间。
sudo journalctl -k --since "<TIME_START>" --until "<TIME_END>" | grep -Ei 'oom-kill|out of memory|killed process'预期输出
kernel: oom-kill:...
kernel: Out of memory: Killed process <ID> (<COMM>) ...
具体字段和文字会随内核版本变化,但应重点保留时间、OOM 范围、被杀 PID、进程名以及日志中提供的内存信息。若命令没有结果,还要确认日志是否已轮转,以及故障是否发生在前一次启动周期。
在 cgroup v2 环境中,再检查对应控制组的限制与事件计数。<CGROUP> 是 /sys/fs/cgroup 下的相对路径,例如某个 systemd 服务或容器对应的控制组。
cg="/sys/fs/cgroup/<CGROUP>"
grep -E '^(max|oom|oom_kill) ' "$cg/memory.events"
cat "$cg/memory.current"
cat "$cg/memory.max"
预期输出
max <COUNT>
oom <COUNT>
oom_kill <COUNT>
<BYTES>
<BYTES_OR_MAX>
其中 memory.max 输出 max 表示没有设置硬上限。实际计数和字节数会不同。故障后读取的 memory.current 只是当前值,被杀进程退出或服务重启后通常已经下降,因此不能把它当作故障峰值。
按时间轴重建资源状态
还原现场的关键不是收集更多截图,而是让不同证据回答同一条时间线上的问题:限制什么时候接近边界、哪个工作集在增长、内核何时决定 OOM、哪个进程被杀、随后是否自动重启。
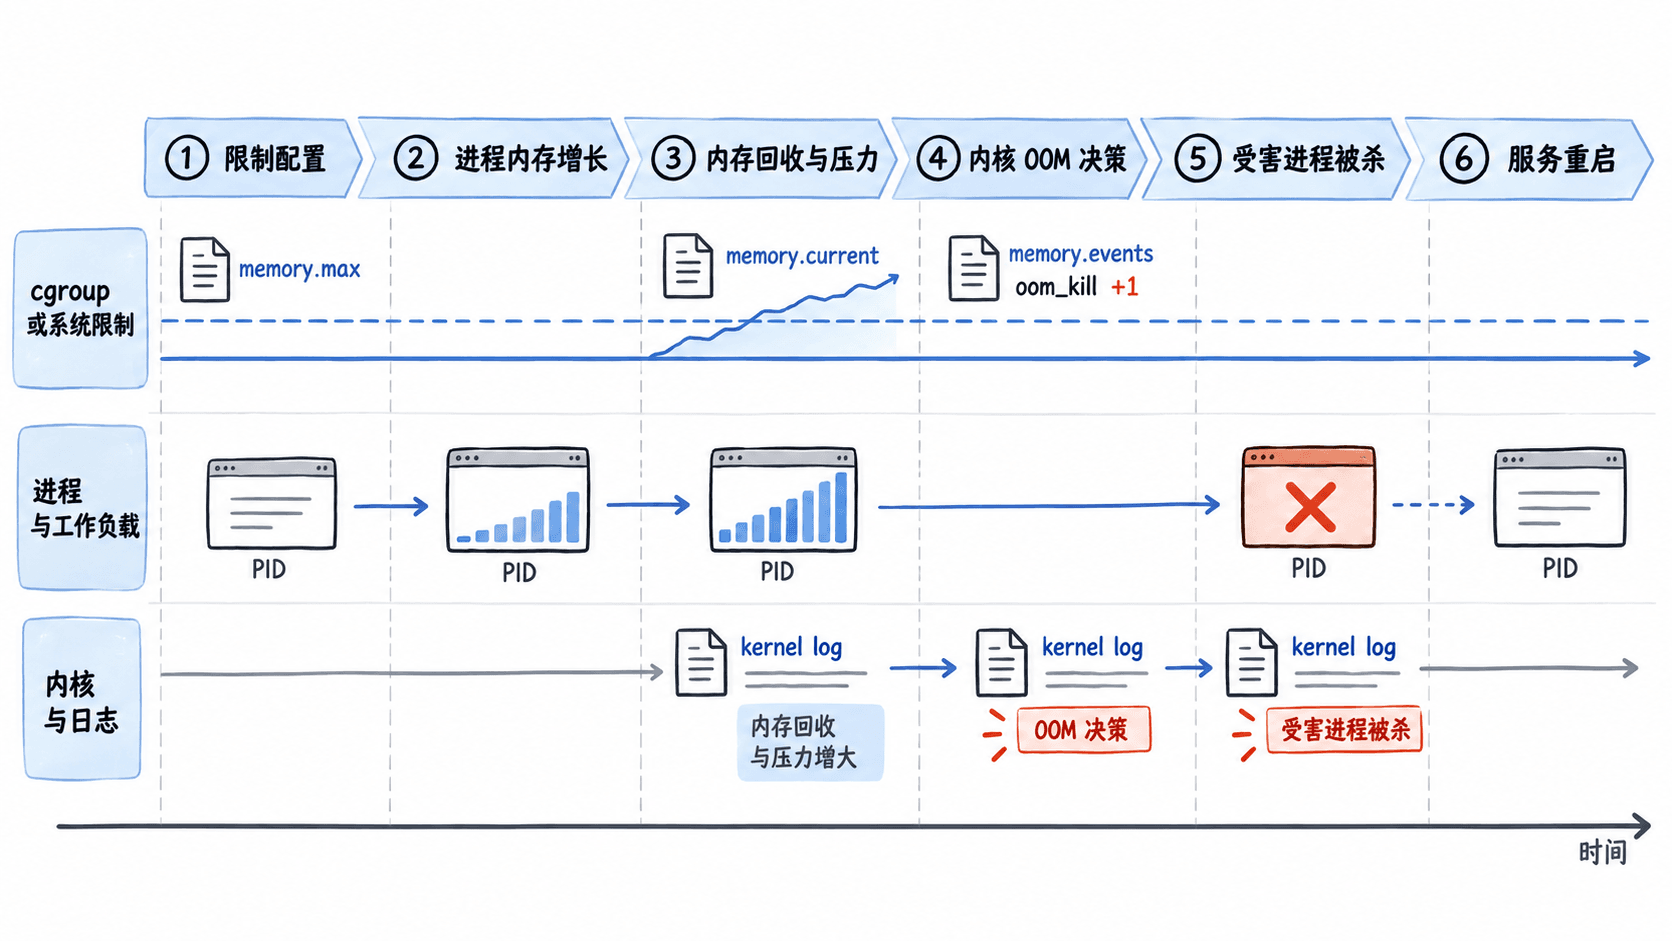
可以按下面的顺序拼接证据:
- 先确定故障发生的准确时间窗口,并记录时区,避免监控平台和主机日志错位。
- 从部署配置或 cgroup 文件确认当时生效的内存上限,而不是只查看事后修改过的配置。
- 查故障前的进程或容器监控,关注 RSS、匿名内存、文件缓存、Swap 以及工作负载是否同步变化。
- 用内核 OOM 日志确定内核真正执行 kill 的时刻和受害进程。
- 对照
memory.events的增量以及服务重启记录,确认事件发生在哪个控制组、杀后系统如何恢复。
监控数据尤其重要,因为 OOM 发生后 /proc/<ID> 往往已经不存在。没有历史指标时,只能根据内核日志和剩余计数器做有限还原,应明确标记哪些峰值无法证实。
不要把被杀进程直接当根因
OOM Killer 选择的是需要终止的进程,不是在替排障人员做根因分析。一个占用较大的进程可能确实存在泄漏,也可能只是因为 oom_score_adj、工作集大小或所在 cgroup 的选择范围而成为受害者。
判断根因时至少要验证三种可能性。第一种是进程匿名内存持续增长,且增长与请求量无关,符合泄漏或无界缓存特征。第二种是业务峰值带来的正常工作集突然超过原有容量,此时程序未必有缺陷。第三种是 memory.max 设置低于正常峰值,即使主机仍有余量也会产生局部 OOM。
文件缓存增加也不能简单等同于泄漏。Linux 会利用空闲内存缓存文件页,其中相当一部分可回收;真正需要结合内存压力、匿名页、回收行为和 OOM 范围判断。
验证还原是否自洽
一个可信的 OOM 现场必须同时回答三个问题:为什么是这个时刻、为什么发生在这个资源范围、为什么最终杀了这个进程。如果只能回答其中一个,结论仍然只是线索。
最终记录中应保留事件时间、OOM 范围、当时生效的限制、故障前峰值、被杀 PID 与进程名、oom_kill 增量、服务是否重启,以及仍缺失的证据。修复后再用相同工作负载或具有代表性的生产观察窗口验证:限制不再被触发、oom_kill 不再增加,同时业务延迟和吞吐没有因为过度回收而恶化,才能认为这次还原真正指导了修复。