
操作系统 / 系统课时
内存抖动怎样关联到缺页
内存抖动怎样关联到缺页
线上服务出现几十毫秒到数秒的延迟尖峰时,先不要把“内存高”直接当成根因。真正有诊断价值的是把 major fault、Swap、块设备读写和延迟放到同一时间窗口,确认它们是否按因果顺序一起变化。
学习目标
- 区分 minor fault、major fault 与 Swap 活动,理解它们和延迟的关系。
- 用同一时间窗口的系统指标判断内存压力是不是延迟尖峰的根因。
- 识别“相关但非因果”的典型情况,避免误判磁盘或应用问题。
先看清缺页到底代表什么
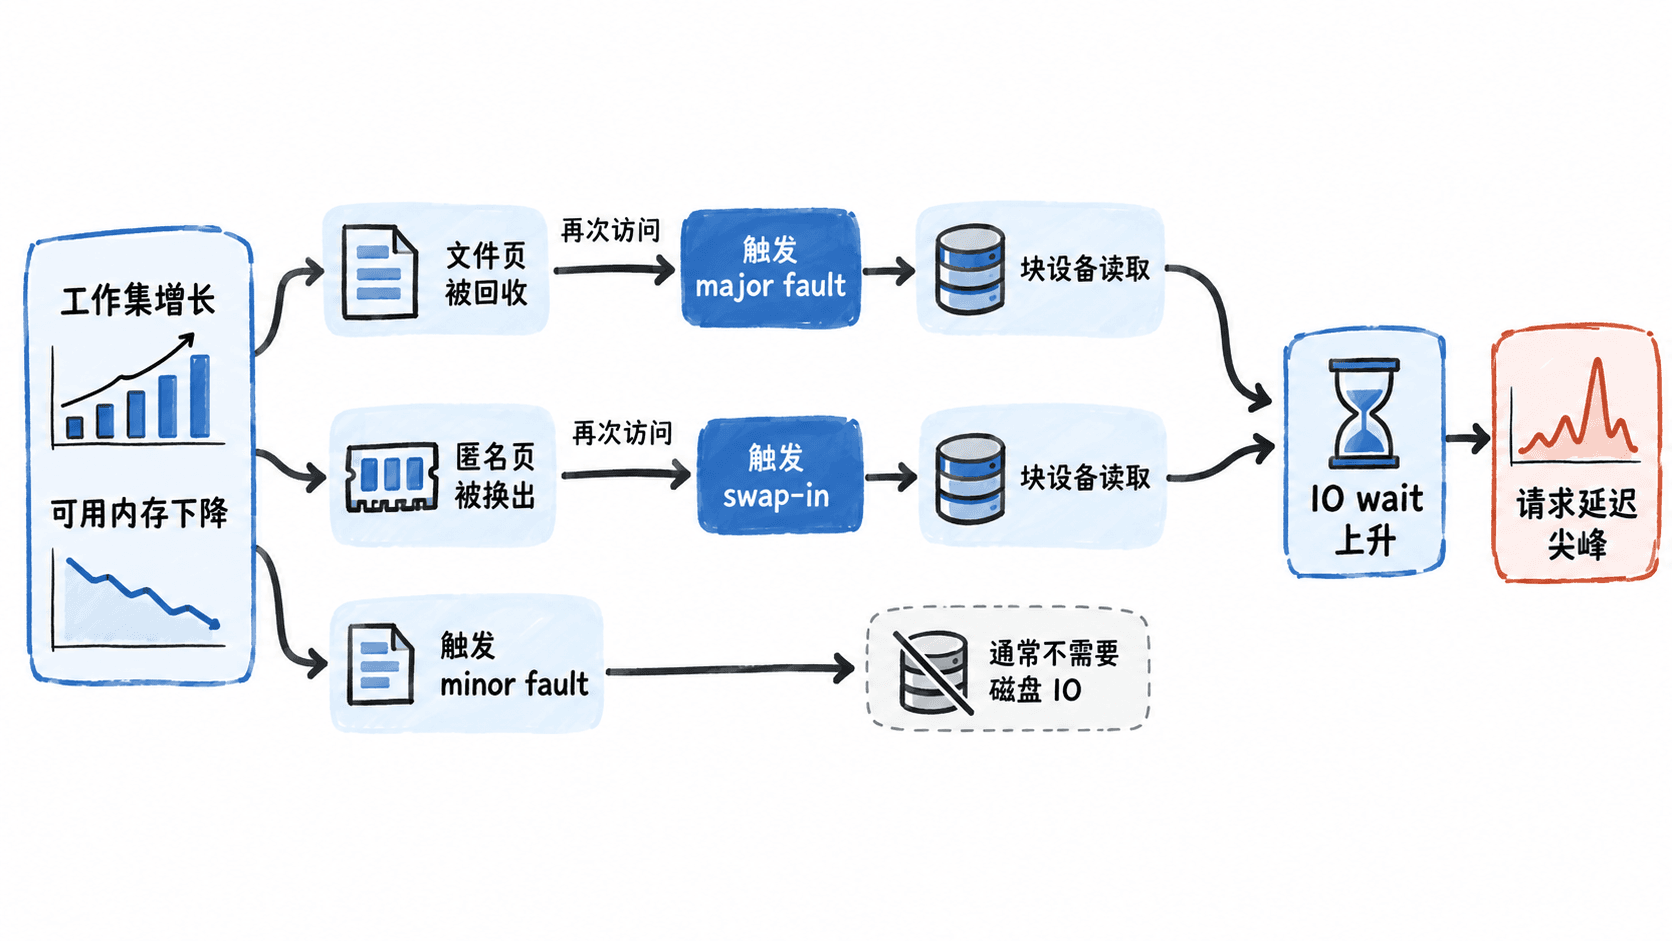
进程访问尚未建立有效页表映射的虚拟页时会触发 page fault。minor fault 不需要从块设备读取目标页,常见于首次建立匿名页、写时复制或页缓存中已经存在数据;major fault 则通常需要等待存储读取文件页或换入页面,因此更容易直接拉长请求延迟。
Swap 指标要和 major fault 分开看。发生 major fault 不等于一定发生 Swap:读取一个已经被回收的文件页也可能产生 major fault。反过来,持续的 si、so 说明系统确实在进行换入换出,通常意味着可回收页不足或匿名页压力已经很高。
把指标放进同一时间窗口
最有用的第一步是同时观察缺页速率、Swap 活动和 IO 等待,而不是只看某个累计值。sar -B 可以观察每秒 fault 与 major fault,vmstat 可以观察换入换出和 CPU 的 wa。若系统没有安装 sysstat,也可以直接读取 /proc/vmstat 的累计计数并比较前后差值。
先确认系统级累计计数:
grep -E '^(pgfault|pgmajfault|pswpin|pswpout) ' /proc/vmstat预期输出
pgfault <COUNT>
pgmajfault <COUNT>
pswpin <COUNT>
pswpout <COUNT>
这些值会持续累加,单次结果本身不能说明问题。应在延迟尖峰前后各采一次并计算差值;如果 pgmajfault、pswpin 在尖峰窗口明显增加,再去检查块设备读取延迟和 wa 是否同步抬升。
随后用 vmstat 看短时间趋势:
vmstat 1 5预期输出
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
<COUNT> <COUNT> <KB> <KB> <KB> <KB> <KBPS> <KBPS> <BLOCKS> <BLOCKS> <COUNT> <COUNT> <PERCENT> <PERCENT> <PERCENT> <PERCENT> <PERCENT>
实际数值会随负载变化。重点不是某个固定阈值,而是尖峰期间 si、so、bi 和 wa 是否一起升高;若 b 也增加,说明更多任务正在等待不可中断 IO。
用因果顺序判断是不是内存根因
如果内存压力是根因,常见顺序是:可用内存下降或回收增强,随后 major fault 或 swap-in 增加,再出现块设备读取和 IO wait 上升,最后请求延迟尖峰。这个顺序比“几个指标都高”更有说服力。
可以按下面的判断逻辑收敛范围:
- 延迟尖峰时 major fault 没有增加,Swap 也没有活动,优先检查锁竞争、CPU 饱和、网络和应用下游。
- major fault 增加,但
si、so接近零,重点检查文件页被回收后的重新读取,例如 mmap 文件或大文件扫描。 - major fault 与
si同时增加,且磁盘读取与wa上升,内存压力导致换入等待的证据较强。 so很高但延迟尚未尖峰,说明系统正在主动换出;如果工作集随后再次访问这些匿名页,后续si和 major fault 可能才会出现。
进一步定位到具体进程
系统级指标只能证明“机器正在抖”,还要找出谁在触发。pidstat -r 能查看进程级 minor/major fault 速率与 RSS 变化,适合把请求延迟和某个 PID 对齐。
pidstat -r -p <PID> 1 5预期输出
<TIME> UID PID minflt/s majflt/s VSZ RSS %MEM Command
<TIME> <UID> <PID> <COUNT> <COUNT> <KB> <KB> <PERCENT> <COMMAND>
如果目标进程的 majflt/s 在延迟尖峰同步上升,再结合系统级 si、块设备读取和 wa,就能把“机器有内存压力”进一步收敛成“这个进程的工作集正在触发真实的磁盘回读”。
最终要建立的是一条可验证的证据链:延迟尖峰不是因为“内存占用高”,而是因为关键工作集被回收或换出,访问时触发 major fault,并把请求阻塞在存储 IO 上。