
操作系统 / 系统课时
大页解决的是哪类问题
大页解决的是哪类问题
大页不是“内存更快”的开关,它主要减少页表层级访问和 TLB 未命中带来的地址翻译开销。理解普通页、透明大页与 HugeTLB 的差异,才能判断大页是否适合当前负载,而不是把它当作通用性能优化。
学习目标
- 说明大页为什么能降低 TLB 和页表压力
- 区分普通页、透明大页与显式 HugeTLB 的适用边界
- 能从系统状态和工作负载特征判断是否值得启用大页
大页真正优化的是地址翻译
CPU 访问虚拟地址时,最终必须找到对应的物理页。TLB 会缓存最近的地址转换结果,但容量有限。页越小,同样大小的工作集需要的页表项和 TLB 条目越多;当热点数据远大于 TLB 可覆盖范围时,TLB miss 会增加,CPU 需要更频繁地走页表。
以常见的 x86-64 配置为例,普通页通常是 4 KiB,大页常见为 2 MiB,部分场景还会使用 1 GiB 页。一个 2 MiB 页覆盖的地址范围相当于 512 个 4 KiB 页,因此在相同 TLB 条目数量下,大页能显著扩大 TLB 的有效覆盖范围,同时减少页表项数量。
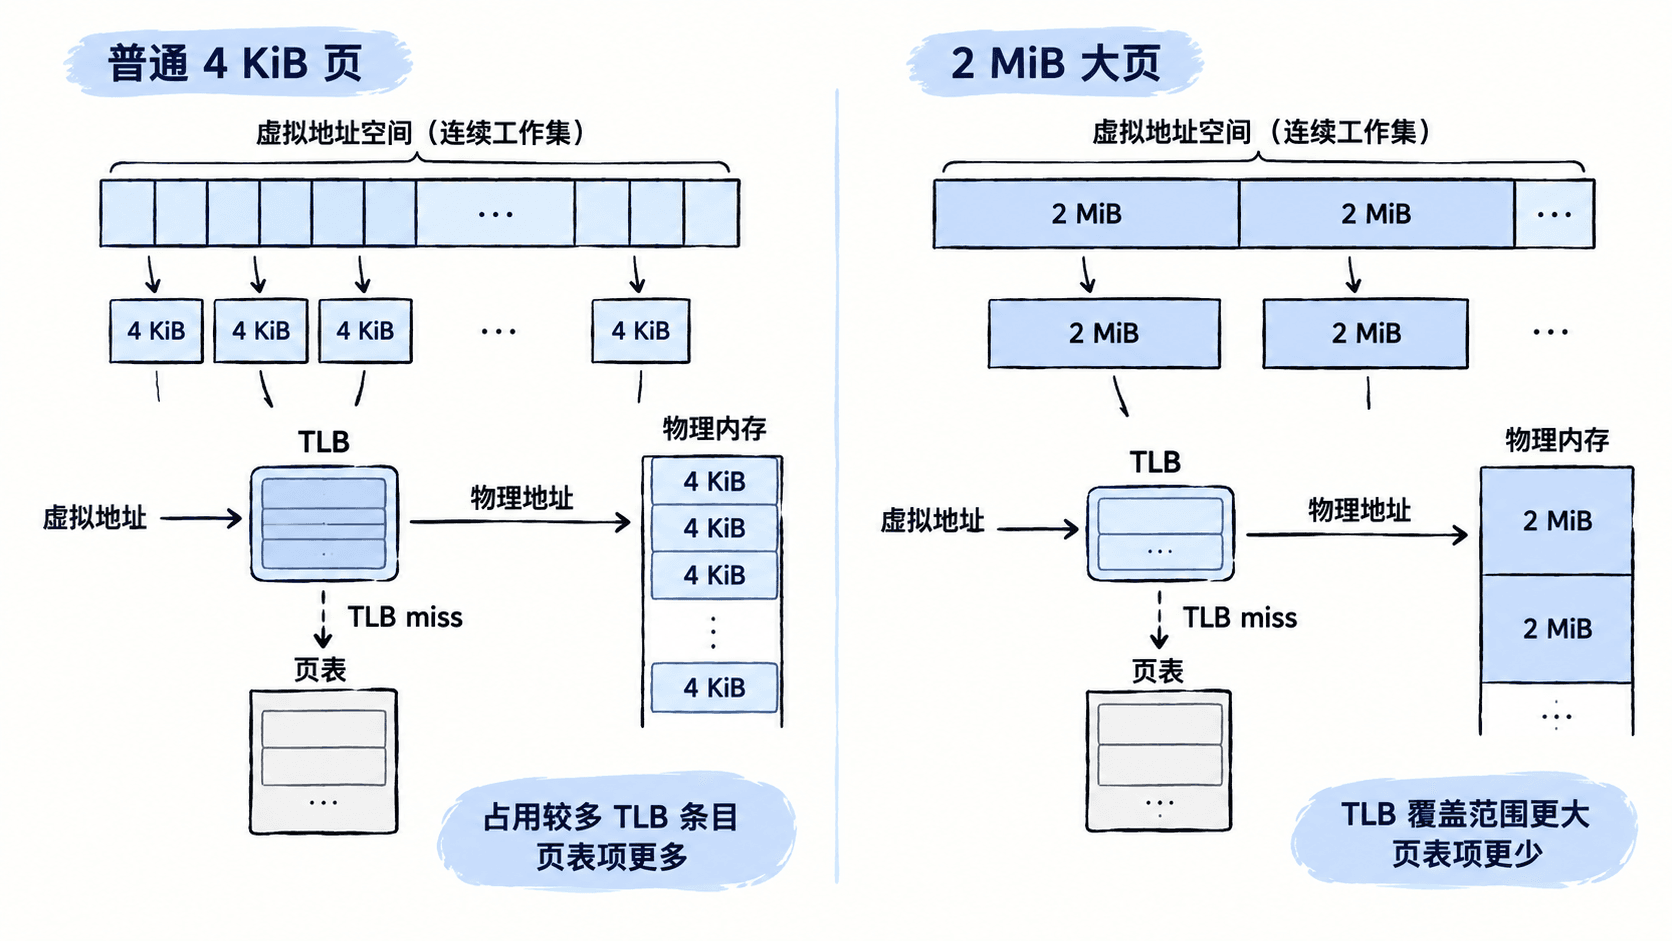
大页的收益因此最容易出现在大工作集、地址访问频繁、TLB miss 已成为瓶颈的程序中。它并不会减少业务本身的计算量,也不会自动解决缓存未命中、锁竞争或磁盘 I/O 问题。
三种页策略的边界
| 方式 | 分配方式 | 应用改动 | 主要优点 | 主要代价 |
|---|---|---|---|---|
| 普通页 | 内核按普通页管理 | 无 | 灵活、碎片小、回收粒度细 | 大工作集下页表与 TLB 压力更高 |
| 透明大页 THP | 内核尽量合并或直接分配大页 | 通常无 | 易启用,适合通用匿名内存负载 | 合并、拆分和内存整理可能带来延迟抖动 |
| HugeTLB | 预留或显式管理 hugetlb 页 | 通常需要显式使用或运行时支持 | 行为更可控,可提前预留,适合确定性需求 | 预留会占用内存,使用不当可能造成浪费 |
THP 更像“内核尽量帮你做”;HugeTLB 更像“应用明确要求并接受管理成本”。对数据库、JVM、大型内存缓存等长期运行的大内存进程,两者都可能有价值,但最终仍要以实际 TLB miss、延迟和内存占用数据验证。
用系统状态判断而不是盲开
先确认 THP 当前策略以及 HugeTLB 预留状态。下面的命令只读取状态,不会修改系统配置。
cat /sys/kernel/mm/transparent_hugepage/enabled
grep -E 'AnonHugePages|HugePages_|Hugepagesize' /proc/meminfo
预期输出(具体模式和数值会因机器而异):
always [madvise] never
AnonHugePages:    <KB> kB
HugePages_Total:  <COUNT>
HugePages_Free:   <COUNT>
HugePages_Rsvd:   <COUNT>
HugePages_Surp:   <COUNT>
Hugepagesize:     <KB> kB
方括号中的 THP 模式表示当前生效策略;AnonHugePages 反映匿名内存中已使用的透明大页规模;HugePages_Total 等字段描述 HugeTLB 池。仅看到“大页已启用”不能证明它带来收益,还要结合进程实际内存类型与性能计数器判断。
什么时候值得用大页
当进程拥有数 GiB 甚至更大的热点工作集,并且性能分析显示 TLB miss 较高时,大页通常值得测试。THP 适合先做低改动验证;如果业务对尾延迟敏感、需要固定页数量或希望避免运行时合并开销,再考虑显式 HugeTLB。
反过来,小工作集、内存高度碎片化、生命周期很短的对象,往往难以从大页中获益。大页还会放大内部碎片,某些 THP 合并或内存整理路径也可能造成延迟尖峰,因此“更少的页”不等于“任何负载都更快”。
判断是否采用大页时,应同时比较吞吐量、P95/P99 延迟、TLB miss、RSS 和内存回收压力。只有这些指标在真实负载下整体改善,大页才算解决了实际问题。