
操作系统 / 系统课时
构建一套内存排障命令集
构建一套内存排障命令集
线上出现“内存高”时,不能只凭 RSS 下结论。本节把 free、vmstat、top、pmap、smaps、perf、dmesg 排成证据链:先判断主机压力,再定位映射、缺页与 OOM,最终形成可复用采集脚本。
学习目标
- 按“主机压力 → 进程占用 → 映射来源 → 缺页行为 → 内核事件”的顺序排查内存问题。
- 能区分可用内存不足、单进程 RSS 增长、页错误频繁和 OOM Kill 这几类现象。
- 能用一组只读命令快速保留现场,并知道哪些命令可能受权限限制。
把命令排成证据链
free 和 vmstat回答“整机是否缺内存”;top回答“谁在占”;pmap 与 /proc/<PID>/smaps回答“占用来自哪些映射”;perf回答“进程是否在持续制造缺页”;dmesg最终确认内核是否发生过 OOM。不要跳过前两层,否则很容易把正常的页缓存或共享库误判成泄漏。
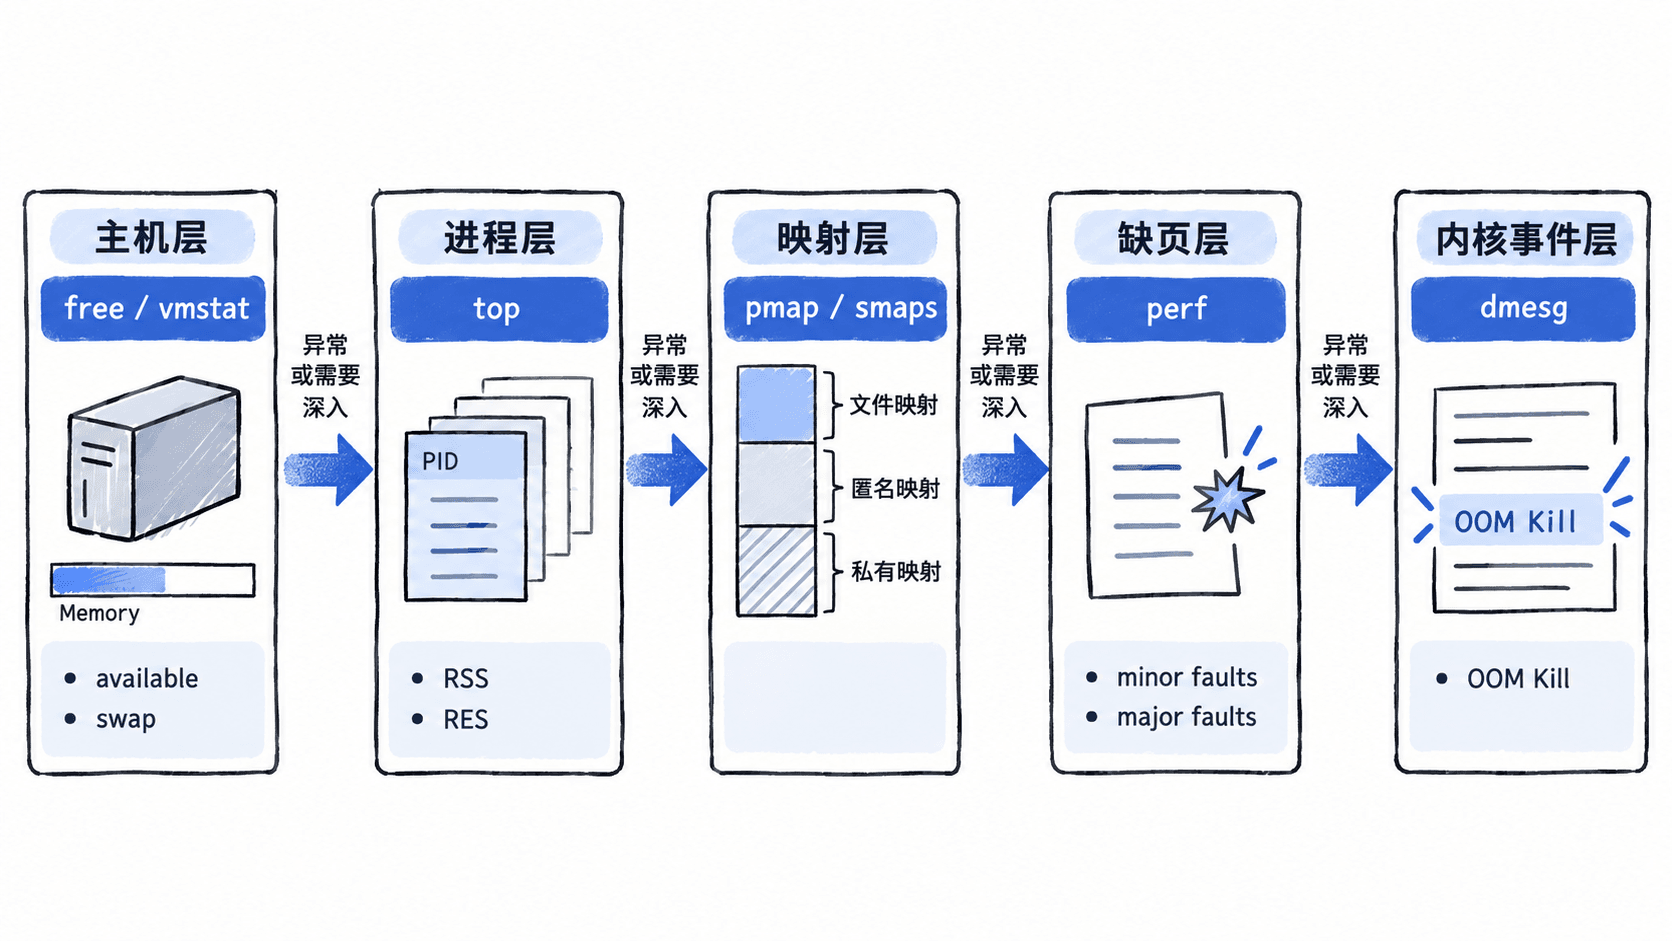
第一条判断线是“压力”而不是“已用百分比”。free -h重点看 available 与 Swap,vmstat 1 5重点看 si、so 是否持续非零以及系统是否伴随明显阻塞。Linux 会积极使用空闲内存做缓存,所以 free 很低并不等于内存耗尽。
锁定进程与映射来源
找到目标进程后,先用 top确认 RES、VIRT 与 CPU 是否同步变化,再用 pmap -x查看各虚拟映射的大小、RSS 和 Dirty。若要区分共享页、私有页、匿名页与 Swap,继续读取 smaps 或内核提供的 smaps_rollup。
其中,RSS 表示当前驻留物理内存,但共享页会被多个进程重复计入;PSS 会按共享比例摊分,更适合估算一个进程对整机物理内存的实际贡献。Private_Dirty 持续上涨通常比单看 RSS 更值得追踪,但仍要结合业务行为和时间序列判断。
用缺页和内核日志验证假设
RSS 上升可能只是进程第一次触碰已经分配的虚拟页。perf stat 可以短时间统计 minor fault 与 major fault:前者通常只需建立页表或复用已有页,后者往往需要从存储取页,代价更高。若故障表现是“突然被杀”,则必须回到 dmesg 查找 OOM 记录,而不是只依赖应用日志。
perf 受 kernel.perf_event_paranoid 等安全策略限制;dmesg 也可能只允许 root 读取。权限不足本身不是“没有问题”的证据,应记录为采集限制。
固化成一次现场采集
下面脚本接收一个 PID,把七类证据一次性输出到当前目录。它不修改目标进程,只进行读取和短时统计;perf、pmap 或 dmesg 不可用时会保留提示并继续采集。
#!/usr/bin/env bash
set -u

PID="${1:-}"
if [[ ! "$PID" =~ ^[0-9]+$ ]] || [[ ! -d "/proc/$PID" ]]; then
  echo "用法: $0 <PID>" >&2
  exit 2
fi

OUT="mem-triage-${PID}.txt"

{
  echo "== free =="
  free -h

  echo
  echo "== vmstat =="
  vmstat 1 3

  echo
  echo "== top =="
  top -b -n 1 -p "$PID" | head -n 12

  echo
  echo "== pmap =="
  if command -v pmap >/dev/null 2>&1; then
    pmap -x "$PID"
  else
    echo "pmap not installed"
  fi

  echo
  echo "== smaps summary =="
  if [[ -r "/proc/$PID/smaps_rollup" ]]; then
    grep -E '^(Rss|Pss|Private_Clean|Private_Dirty|Shared_Clean|Shared_Dirty|Swap):'       "/proc/$PID/smaps_rollup"
  elif [[ -r "/proc/$PID/smaps" ]]; then
    awk '
      /^(Rss|Pss|Private_Clean|Private_Dirty|Shared_Clean|Shared_Dirty|Swap):/ {
        sum[$1] += $2
      }
      END {
        for (k in sum) print k, sum[k], "kB"
      }
    ' "/proc/$PID/smaps"
  else
    echo "smaps not readable"
  fi

  echo
  echo "== page faults for 5s =="
  if command -v perf >/dev/null 2>&1; then
    perf stat --timeout 5000 -e page-faults,minor-faults,major-faults -p "$PID" || true
  else
    echo "perf not installed"
  fi

  echo
  echo "== oom evidence =="
  if dmesg >/dev/null 2>&1; then
    dmesg -T | grep -Ei 'out of memory|oom-kill|killed process' | tail -n 20 || true
  else
    echo "dmesg not readable; retry with sufficient privileges"
  fi
} 2>&1 | tee "$OUT"
预期输出
== free ==
Mem:  <TOTAL>  <USED>  <FREE>  <SHARED>  <BUFF_CACHE>  <AVAILABLE>
Swap: <TOTAL>  <USED>  <FREE>

== vmstat ==
procs ... memory ... swap ... io ... system ... cpu ...
<VALUES>

== top ==
top - <TIME> ...
<PID> ... <RES> ... <COMMAND>

== smaps summary ==
Rss: <KB> kB
Pss: <KB> kB
Private_Dirty: <KB> kB
Swap: <KB> kB

== page faults for 5s ==
<COUNT>      page-faults
<COUNT>      minor-faults
<COUNT>      major-faults

== oom evidence ==
<NO_MATCH_OR_KERNEL_OOM_LINES>
实际数值、时间和日志格式会随机器、内核与进程状态变化。脚本结束后,应先看 available、Swap 与 vmstat 的换入换出,再看目标进程的 RES/PSS/Private_Dirty,最后用缺页与 OOM 日志验证原因。这样得到的是一条能复查的证据链,而不是某个瞬间的单一指标。