
操作系统 / 系统课时
脏页什么时候写回磁盘
脏页什么时候写回磁盘
应用修改文件后,数据通常先落在 Page Cache 中,对应页面被标记为 dirty page,而不是每次 write() 都立即等待磁盘完成写入。内核随后按照阈值和时间策略做后台写回;应用也可以用同步接口主动要求持久化。理解这些路径,才能正确判断“写成功”和“已经持久化”的差别。
学习目标
- 说明 clean、dirty、writeback 三种页面状态的关系
- 理解后台写回何时被触发,以及阈值配置如何参与决策
- 区分普通
write()、fsync()与系统级sync的作用
从写入到落盘经历哪些状态
普通缓冲写入首先修改 Page Cache 中的文件页。页面内容与后端存储中的旧数据不一致后,就成为脏页;内核开始向存储提交相应数据时,会出现 writeback 活动;写回完成后,该页重新成为可直接回收的干净缓存页。
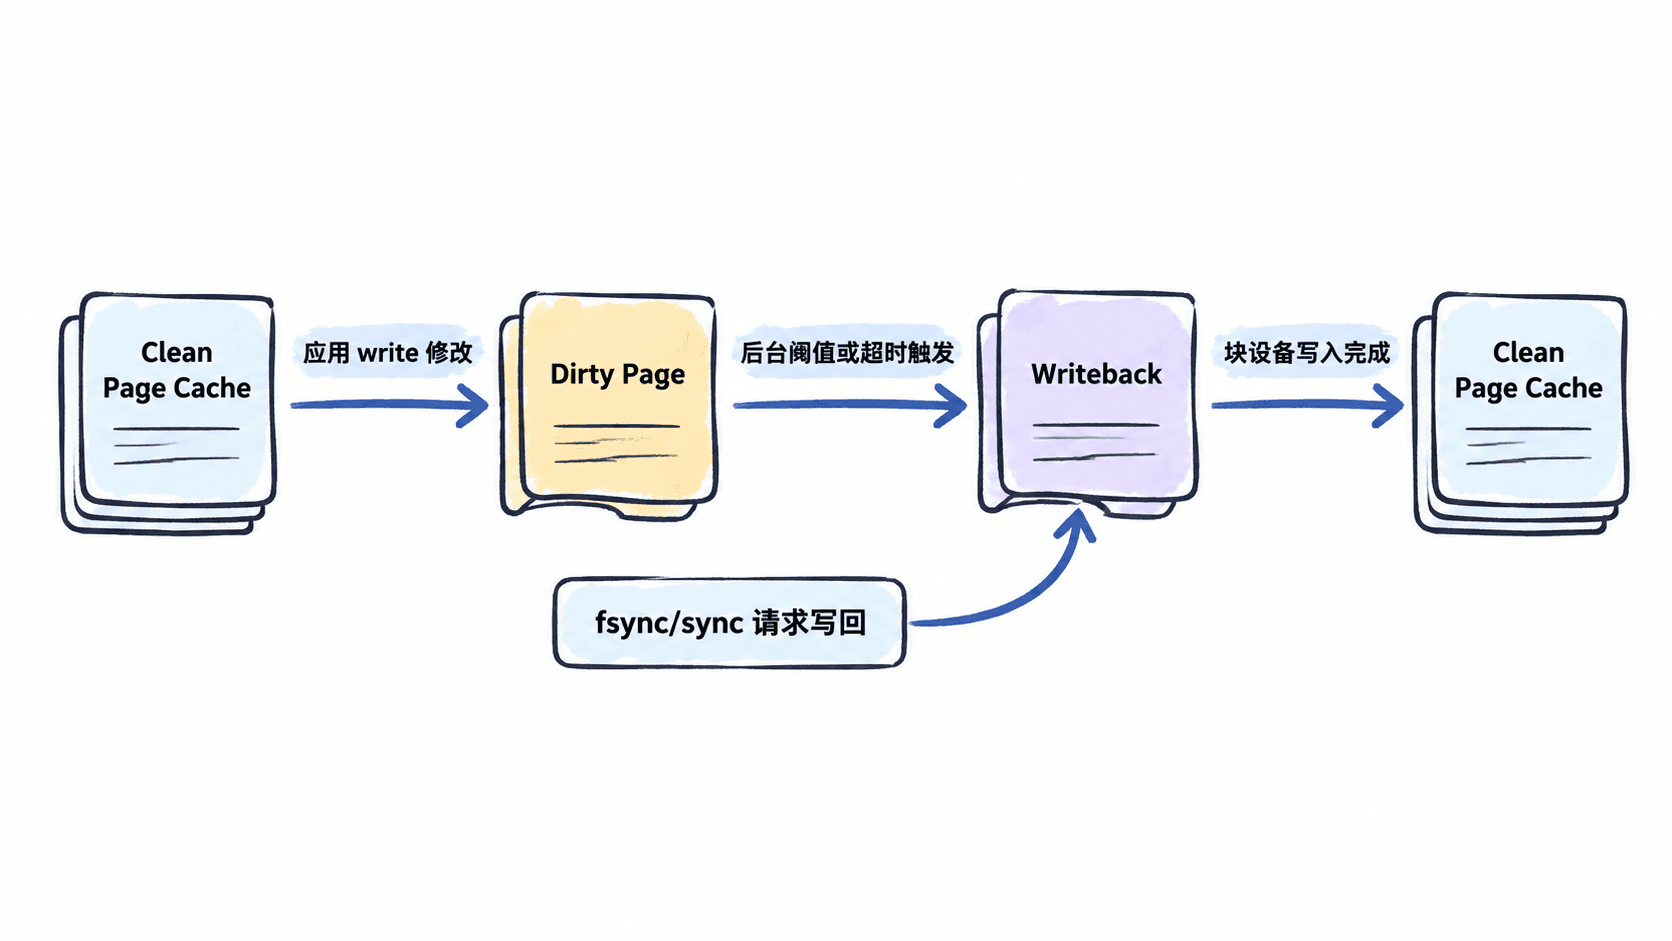
write() 返回时,通常表示数据已经复制到内核并被文件系统接受,并不等价于存储介质已经完成持久化。这样可以把应用写入延迟与设备实际 I/O 解耦,提高吞吐,也允许内核合并和调度写操作。
后台写回由什么触发
Linux 会根据脏页规模和脏页停留时间启动写回。常见控制项包括 vm.dirty_background_ratio、vm.dirty_ratio、vm.dirty_writeback_centisecs 与 vm.dirty_expire_centisecs;系统也提供对应的 *_bytes 配置,其中非零的 bytes 配置会取代对应 ratio 配置作为阈值依据。
先查看当前系统设置,不要直接套用其他机器的数值:
sysctl vm.dirty_background_ratio vm.dirty_ratio vm.dirty_background_bytes vm.dirty_bytes vm.dirty_writeback_centisecs vm.dirty_expire_centisecs预期输出:
vm.dirty_background_ratio = <VALUE>
vm.dirty_ratio = <VALUE>
vm.dirty_background_bytes = <VALUE>
vm.dirty_bytes = <VALUE>
vm.dirty_writeback_centisecs = <VALUE>
vm.dirty_expire_centisecs = <VALUE>
<VALUE> 取决于内核和系统配置。可以把 background 阈值理解为后台写回开始积极工作的水位;当产生脏页的速度持续过快时,更高层级的脏页限制会对写入任务施加节流,避免脏数据无限增长。
后台写回与同步写入不是一回事
后台写回由内核自行调度,目标是在吞吐、延迟和脏页规模之间取得平衡。应用如果只调用普通 write(),通常不需要等待底层设备真正完成写入,因此延迟较低,但尚未持久化的数据仍可能在异常断电或系统故障时丢失。
需要建立明确持久化边界时,应用通常针对关键文件调用 fsync() 或相关接口,请求该文件的数据以及持久化所需的元数据完成同步。命令行的 sync 则面向更广的系统范围,适合运维或测试场景,但不能替代应用自己的事务和持久化设计。
如何观察脏页是否正在积累
/proc/meminfo 可以直接看到当前脏页以及正在写回的内存规模:
awk '/^(Dirty|Writeback|WritebackTmp):/ {print}' /proc/meminfo预期输出:
Dirty:           <VALUE> kB
Writeback:       <VALUE> kB
WritebackTmp:    <VALUE> kB
短时间写入高峰出现 Dirty 上升是正常现象;更值得关注的是脏页是否长期高位、写回是否持续堆积,以及应用写延迟是否同步恶化。如果存储速度长期跟不上产生脏页的速度,回写压力会反过来限制写入进程,表现为吞吐下降或延迟抖动。
判断写回问题时,应把“脏页有多少”“写回是否持续”“设备是否拥塞”放在一起看。脏页本身是正常缓存机制的一部分,真正的异常通常来自脏页产生速度长期超过存储消化能力,或应用设置的持久化边界与业务要求不匹配。