
操作系统 / 系统课时
kswapd 在后台做什么
kswapd 在后台做什么
当空闲页下降时,Linux 会尽量在应用真正申请不到内存之前启动后台回收。承担这项工作的核心线程是 kswapd。理解它与 direct reclaim 的分工,可以解释为什么有时系统内存仍未耗尽,应用延迟却突然升高,也能判断回收压力是否已经进入分配路径。
学习目标
- 理解内存水位如何触发
kswapd后台回收 - 区分后台回收与 direct reclaim 对应用线程的影响
- 能利用
/proc/vmstat判断回收压力主要发生在哪条路径
kswapd 为什么需要提前工作
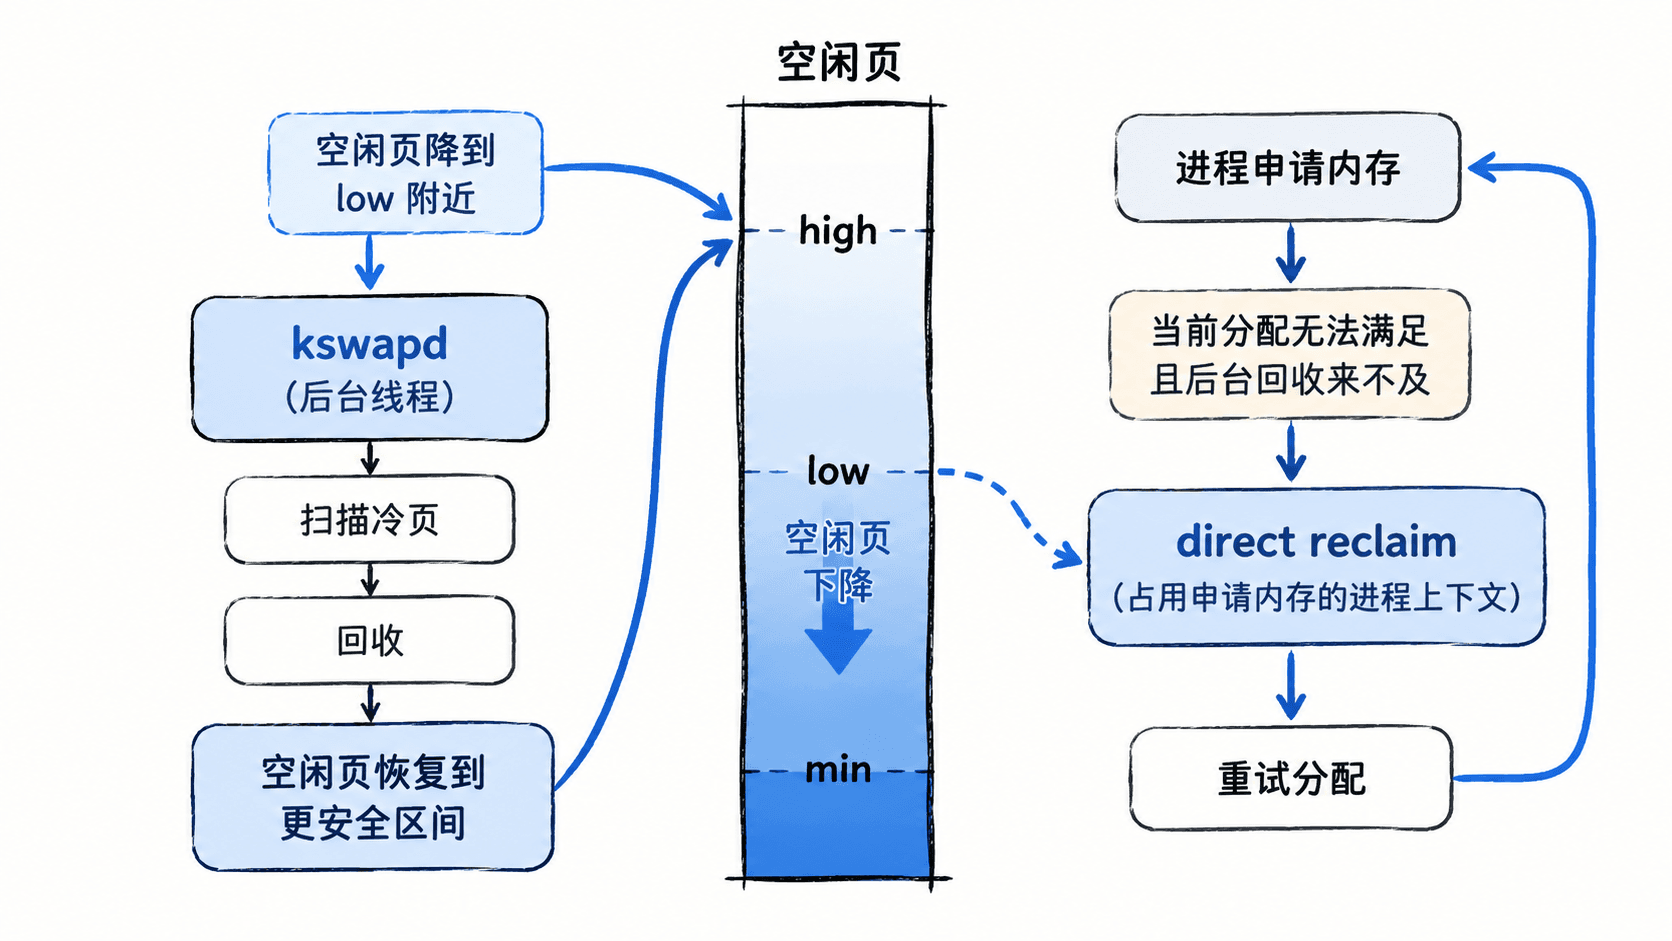
每个内存节点的 zone 都维护用于内存分配与回收决策的水位。为了便于理解,可以关注 min、low 和 high 三组阈值:可用页下降到较低水位后,系统会唤醒后台回收线程;kswapd 扫描可回收页面,努力把空闲内存恢复到更安全的范围。
在 NUMA 系统上通常可以看到按节点工作的 kswapd 内核线程,例如 kswapd0。它的价值在于把部分回收工作提前放到后台完成,使普通进程后续申请内存时更可能直接拿到空闲页,而不用自己同步参与耗时的扫描和回收。
后台回收怎样运行
kswapd 被唤醒后,会扫描适合回收的页面,并尝试释放文件页、换出适合的匿名页以及配合其他回收机制释放内存。它并不是定时清缓存的守护进程,而是由内存压力驱动,在不需要工作时可以睡眠。
如果回收顺利,空闲页重新升高,后台线程就可以停止积极扫描。这样应用线程感受到的主要是间接影响,例如 Page Cache 被淘汰后出现更多文件读取,或 Swap 活跃后访问匿名页需要换入,而不是每次分配内存都同步执行回收。
direct reclaim 为什么更影响延迟
当一个进程请求内存,而当前分配无法立即满足时,如果仅依靠后台 kswapd 来不及释放足够页面,分配路径可能进入 direct reclaim。此时执行申请的线程自己参与扫描和回收,完成之前不能继续原来的业务工作。
这意味着系统不一定已经 OOM,应用也可能出现明显的请求抖动。若 direct reclaim 需要等待脏页写回、扫描大量难以回收的页,或者频繁处理匿名页,单次内存分配的延迟就可能显著放大。
两条路径可以这样区分:kswapd 的目标是提前制造可用页,尽量把回收成本放到后台;direct reclaim 是分配已经受到阻塞后的同步补救。如果后者长期活跃,通常说明系统的内存余量、工作集或回收效率已经不足。
查看后台和直接回收计数
可以从 /proc/vmstat 分别读取两类扫描与回收计数。在问题窗口内连续观察这些值,比只看某一时刻的空闲内存更有意义。
grep -E '^(pgscan_kswapd|pgscan_direct|pgsteal_kswapd|pgsteal_direct) ' /proc/vmstat预期输出
pgsteal_kswapd <COUNT>
pgsteal_direct <COUNT>
pgscan_kswapd <COUNT>
pgscan_direct <COUNT>
<COUNT> 是动态累计值,具体数字和字段排列可能不同。若 pgscan_kswapd 与 pgsteal_kswapd 增长,说明后台回收正在工作;若 pgscan_direct、pgsteal_direct 持续明显增加,则应用分配路径已经直接参与回收。
也可以确认系统中实际存在的 kswapd 线程:
ps -e -o pid,comm | grep '[k]swapd'预期输出
<PID> kswapd0<PID> 会随系统而变化;多 NUMA 节点机器可能出现多个 kswapd<N> 线程,因此输出不一定只有一行。
从计数增长判断压力阶段
如果主要是 kswapd 计数增长,而 direct reclaim 很少,通常说明系统虽然存在内存压力,但后台回收仍有机会提前补充空闲页。此时还应结合业务延迟、磁盘 I/O 和 Swap 活动判断是否影响实际负载。
如果 direct reclaim 计数持续增长,并且应用延迟同步恶化,应继续检查工作集是否超过物理内存、Swap 是否发生抖动、脏页写回是否受阻,以及容器或 cgroup 是否存在更紧的内存限制。仅仅清理 Page Cache 往往不能解决这些根因。
当回收扫描已经非常积极却仍无法提供足够可用页时,问题就从“后台维护空闲页”升级成“应用线程被迫为分配内存付费”。这正是观察 kswapd 与 direct reclaim 的核心价值。