
操作系统 / 系统课时
大页启用后为什么没变快
大页启用后为什么没变快
启用 HugeTLB 或 Transparent Huge Pages 后性能没有变化,并不代表大页失效。大页主要减少页表层级访问和 TLB 压力,只有当实际映射成功、TLB miss 是瓶颈且工作集足够连续时,收益才会显现;否则甚至可能引入整理与回收成本。
学习目标
- 判断系统“开启了大页”与进程“实际使用了大页”之间的差别。
- 从 TLB、内存碎片、映射方式和工作集特征解释没有收益的原因。
- 建立启用前后可重复的验证顺序,而不是只比较一次吞吐结果。
先确认大页有没有真正进入映射
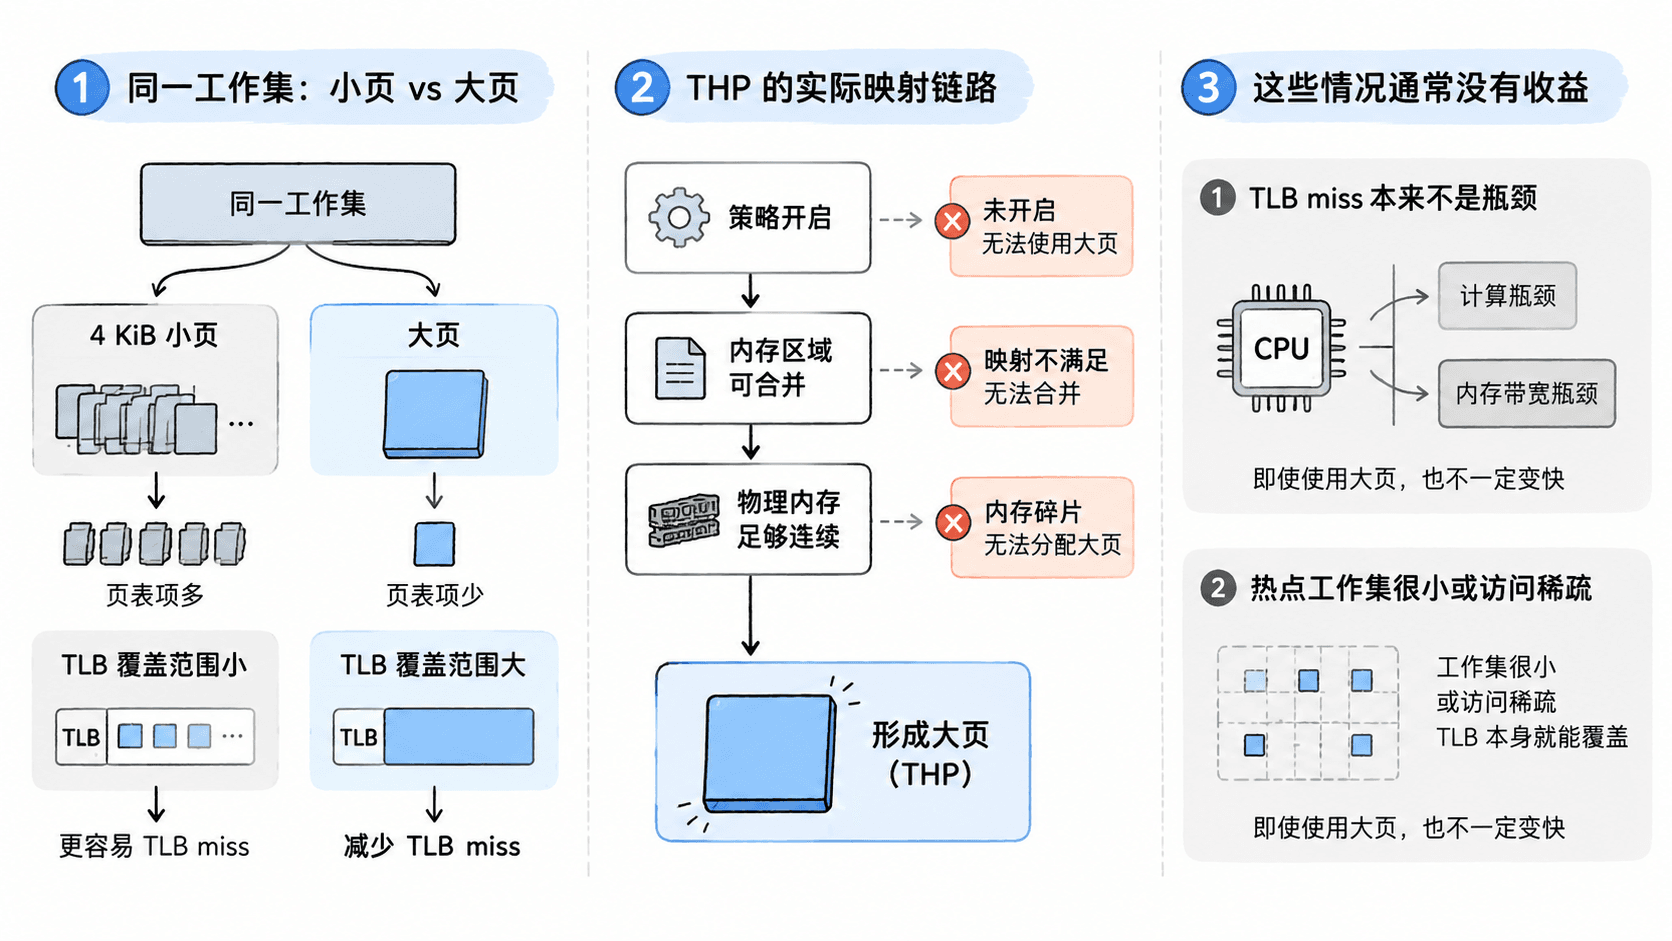
Transparent Huge Pages(THP)是内核按策略尝试把普通匿名页合并成更大的页;HugeTLB 则依赖预留的大页池以及显式映射机制。系统开关打开,只表示“允许或倾向于使用”,不保证目标进程的热点区域已经由大页覆盖。
先检查系统状态:
cat /sys/kernel/mm/transparent_hugepage/enabled
grep -E '^(AnonHugePages|HugePages_Total|HugePages_Free|Hugepagesize):' /proc/meminfo
预期输出
always [madvise] never
AnonHugePages: <KB> kB
HugePages_Total: <COUNT>
HugePages_Free: <COUNT>
Hugepagesize: <KB> kB
方括号中的模式是当前 THP 策略;实际模式可能是 always、madvise 或 never。AnonHugePages 只反映匿名大页的系统级规模,不能证明你的进程热点区域已经使用大页。
继续看目标进程的汇总映射:
grep -E '^(AnonHugePages|ShmemPmdMapped|FilePmdMapped|Hugetlb):' /proc/<PID>/smaps_rollup预期输出
AnonHugePages: <KB> kB
ShmemPmdMapped: <KB> kB
FilePmdMapped: <KB> kB
Hugetlb: <KB> kB
如果这些值几乎为零,而 RSS 很大,那么“开了大页但没变快”首先可能是因为目标工作集根本没有形成大页映射。
大页只优化特定瓶颈
大页最直接的收益是让一个 TLB 条目覆盖更多虚拟地址,并减少页表项数量。假设工作集本来就完全落在 TLB 可覆盖范围内,或者程序主要耗时在计算、锁、缓存未命中、系统调用和 IO,那么把 4 KiB 页换成更大的页,吞吐可能几乎不变。
验证时不要只看总 CPU 使用率,要比较启用前后的 TLB miss。可以使用 perf stat,但具体事件是否可用取决于 CPU 和内核;若通用事件不受支持,应改用当前平台提供的等价事件。
perf stat -e dTLB-loads,dTLB-load-misses -p <PID> -- sleep 10预期输出
<COUNT> dTLB-loads
<COUNT> dTLB-load-misses
真正有意义的是比较同一负载下的 miss 数量或 miss 比例。如果大页启用后 TLB miss 明显下降,但业务耗时没有变化,说明 TLB 不是主导瓶颈;如果 miss 也没下降,则要继续检查映射是否成功以及热点工作集是否被大页覆盖。
碎片和整理成本会抵消收益
THP 需要较大的连续物理内存区域。运行时间较长、频繁分配释放或高阶页紧张时,内核可能需要做 compaction,或者无法及时形成大页。此时大页覆盖率低,甚至会因为整理和回收带来额外延迟。
可以观察与大页整理相关的 /proc/vmstat 计数:
grep -E '^(compact_stall|compact_success|compact_fail|thp_fault_alloc|thp_fault_fallback) ' /proc/vmstat预期输出
compact_stall <COUNT>
compact_success <COUNT>
compact_fail <COUNT>
thp_fault_alloc <COUNT>
thp_fault_fallback <COUNT>
这些也是累计值,要比较压测前后的增量。如果 thp_fault_fallback 或 compact_stall 在负载期间快速增加,说明内核经常无法直接获得合适的大页,优化收益可能被碎片和整理成本削弱。
映射方式和工作集决定最终效果
THP 主要针对满足条件的内存区域自动工作,madvise 模式还要求应用对目标区域给出合适提示;HugeTLB 则通常需要应用、运行库或挂载方式显式配合。只改系统参数而不改变映射方式,可能根本不会覆盖真正的热点内存。
工作集特征同样重要。顺序扫描、随机访问超大匿名堆、虚拟机或数据库缓冲池更可能从更大的 TLB 覆盖中受益;小工作集、冷数据多、频繁拆分映射或大量短生命周期内存则未必适合。大页还会增加内部碎片,所以“页越大越快”不是通用规律。
验证大页优化时,顺序应当固定:先确认进程实际大页覆盖率,再比较 TLB miss,然后检查 compaction 与 fallback,最后才看吞吐和尾延迟。只有当“映射成功、TLB 压力下降、额外整理成本可控”同时成立时,大页才有机会转化成稳定的业务收益。