
操作系统 / 系统课时
OOM 发生后先查哪几项
OOM 发生后先查哪几项
OOM 发生后最容易误判的是一上来就盯着当前 free 输出,因为被杀进程退出后,内存可能已经恢复。本篇建立固定排查顺序:先从内核日志确认是否真是 OOM,再看当时的系统与进程占用,最后核对 cgroup 限制,从而区分整机内存耗尽与容器或服务自身的额度触顶。
学习目标
- 从内核日志识别全局 OOM 与 memory cgroup OOM。
- 用系统内存和进程 RSS 数据缩小问题范围。
- 核对 cgroup v2 的
memory.current、memory.max与memory.events。
先用内核日志确认事件
第一步不是猜,而是找 OOM 证据。systemd 主机可先查询当前启动周期的内核日志,并聚焦 OOM 关键词:
sudo journalctl -k -b --no-pager \
  | grep -Ei 'out of memory|oom-kill|killed process|memory cgroup' \
  | tail -n 20
预期输出
<TIME> <HOST> kernel: <OOM_CONTEXT>
<TIME> <HOST> kernel: Killed process <ID> (<PROCESS>) ...
不同内核版本和发行版的字段会不同,所以这里用 <TIME>、<ID> 等占位。真正要记录的是:是否出现 Killed process、触发的是全局 OOM 还是 memory cgroup OOM、被杀 PID/进程名,以及日志中出现的 cgroup 路径。
如果这一步没有任何 OOM 证据,就不要直接下结论。进程也可能因为显式 SIGKILL、容器编排超时、人工操作或其他故障退出。
再看系统内存是否整体紧张
确认 OOM 后,再检查当前系统状态。虽然事后数据不能完整还原故障瞬间,但可以判断机器是否仍处于持续压力,并观察 Swap 是否耗尽:
free -h
printf '\nTop RSS processes:\n'
ps -eo pid,comm,rss,vsz --sort=-rss | head -n 11
预期输出
               total        used        free      shared  buff/cache   available
Mem:           <SIZE>      <SIZE>      <SIZE>      <SIZE>      <SIZE>      <SIZE>
Swap:          <SIZE>      <SIZE>      <SIZE>

Top RSS processes:
    PID COMMAND           RSS    VSZ
   <ID> <PROCESS>      <RSS>  <VSZ>
available 比单独的 free 更适合判断系统还能否为应用提供内存;RSS 用来找当前主要常驻内存消费者,但它只能说明“谁现在占得多”,不能证明“谁触发了 OOM”。如果被杀进程已经退出,它甚至不会出现在列表里。
最后核对 cgroup 限制
容器或受 systemd 资源控制的服务可能在宿主机仍有大量可用内存时触发 memcg OOM。cgroup v2 中,memory.current 是当前使用量,memory.max 是硬上限,memory.events 记录 oom、oom_kill 等事件计数。
下面的命令检查当前 shell 所属 cgroup;诊断具体服务时,把 PID 换成目标进程 PID,并读取 /proc/<PID>/cgroup 对应的目录:
cg=$(awk -F: '$1=="0" {print $3}' /proc/$$/cgroup)
base="/sys/fs/cgroup${cg}"

printf 'cgroup=%s\n' "$cg"
for f in memory.current memory.max memory.events; do
  if [ -r "$base/$f" ]; then
    printf '\n%s\n' "$f"
    cat "$base/$f"
  fi
done
预期输出
cgroup=<CGROUP_PATH>

memory.current
<BYTES>

memory.max
<BYTES_OR_MAX>

memory.events
low <COUNT>
high <COUNT>
max <COUNT>
oom <COUNT>
oom_kill <COUNT>
如果 memory.max 是明确字节数,而 oom 或 oom_kill 持续增长,就应优先检查这个 cgroup 的额度、应用峰值和内存增长原因,而不是先给整台机器加 Swap。若 memory.max 为 max,则说明该 cgroup 没有设置这一层硬上限,需要继续回到全局内存和上层 cgroup 约束排查。
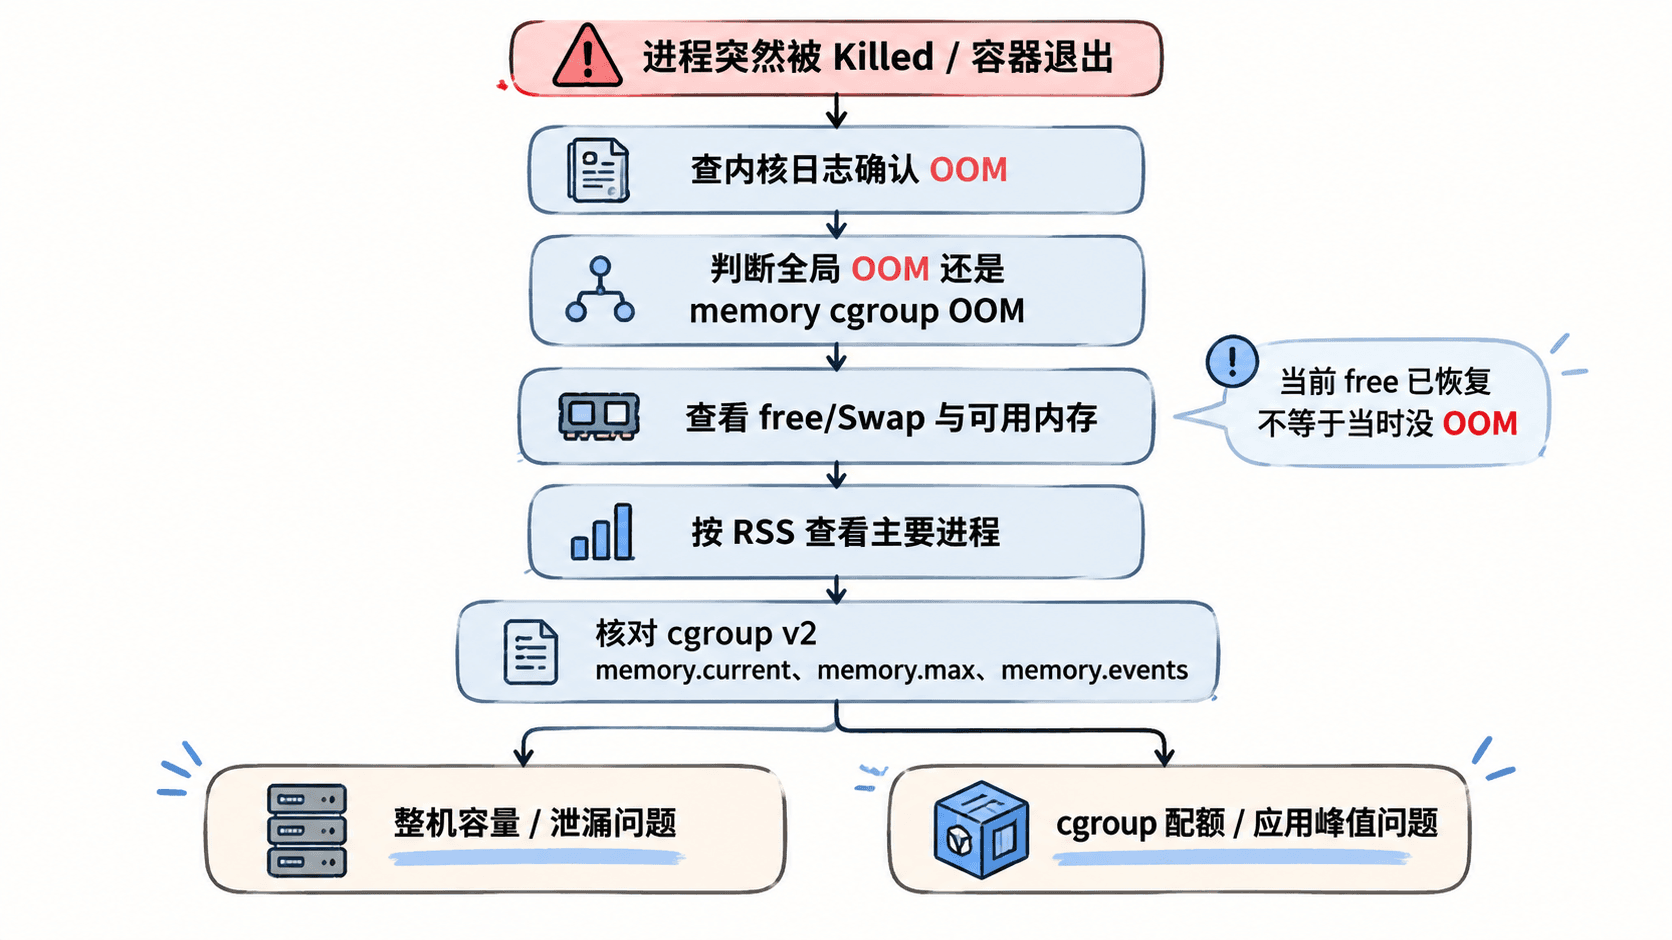
按固定顺序形成证据链
一次可靠排查至少要把四类证据串起来:内核日志确认事件类型,系统内存判断全局压力,RSS 定位主要消费者,cgroup 数据判断是否存在局部上限。顺序不能反过来,因为 OOM 发生后进程被杀、内存释放,现场会迅速变化。
最有价值的记录不是“现在内存用了多少”,而是 OOM 日志中的时间点、被杀进程、所属 cgroup 与限制值,再结合应用在同一时间段的负载和发布变化。这样才能区分容量不足、内存泄漏、突发并发和 cgroup 配额过低,而不是把所有 OOM 都归因于“Linux 内存不够”。