
操作系统 / 系统课时
fork 大进程为什么可能很慢
fork 大进程为什么可能很慢
fork 使用 COW 避免立即复制所有数据页,但它并不是零成本操作。地址空间越复杂,创建子进程时处理内存元数据和页表的工作越多;子进程随后大量写内存时,还会继续支付 COW 缺页和数据复制成本。
学习目标
- 区分
fork调用本身与后续 COW 写入的两阶段成本 - 理解页表复制、TLB 失效和缺页处理为什么会放大延迟
- 会用一个最小程序分别观察
fork延迟与 COW 写入成本
fork 并不会复制全部数据页
Linux 创建子进程时,通常让父子页表先指向相同的物理页,并把适合 COW 的私有可写映射设置成写保护。这样可以避免在 fork 返回前复制大量页内容,但内核仍要创建新的进程内存描述、复制或重建 VMA 信息,并为已有映射准备子进程页表。
因此,大进程的 fork 成本更接近“复制地址空间结构并建立共享关系”,而不是“把 RSS 对应的所有字节复制一遍”。页表越多、映射越碎,前半段工作往往越重。
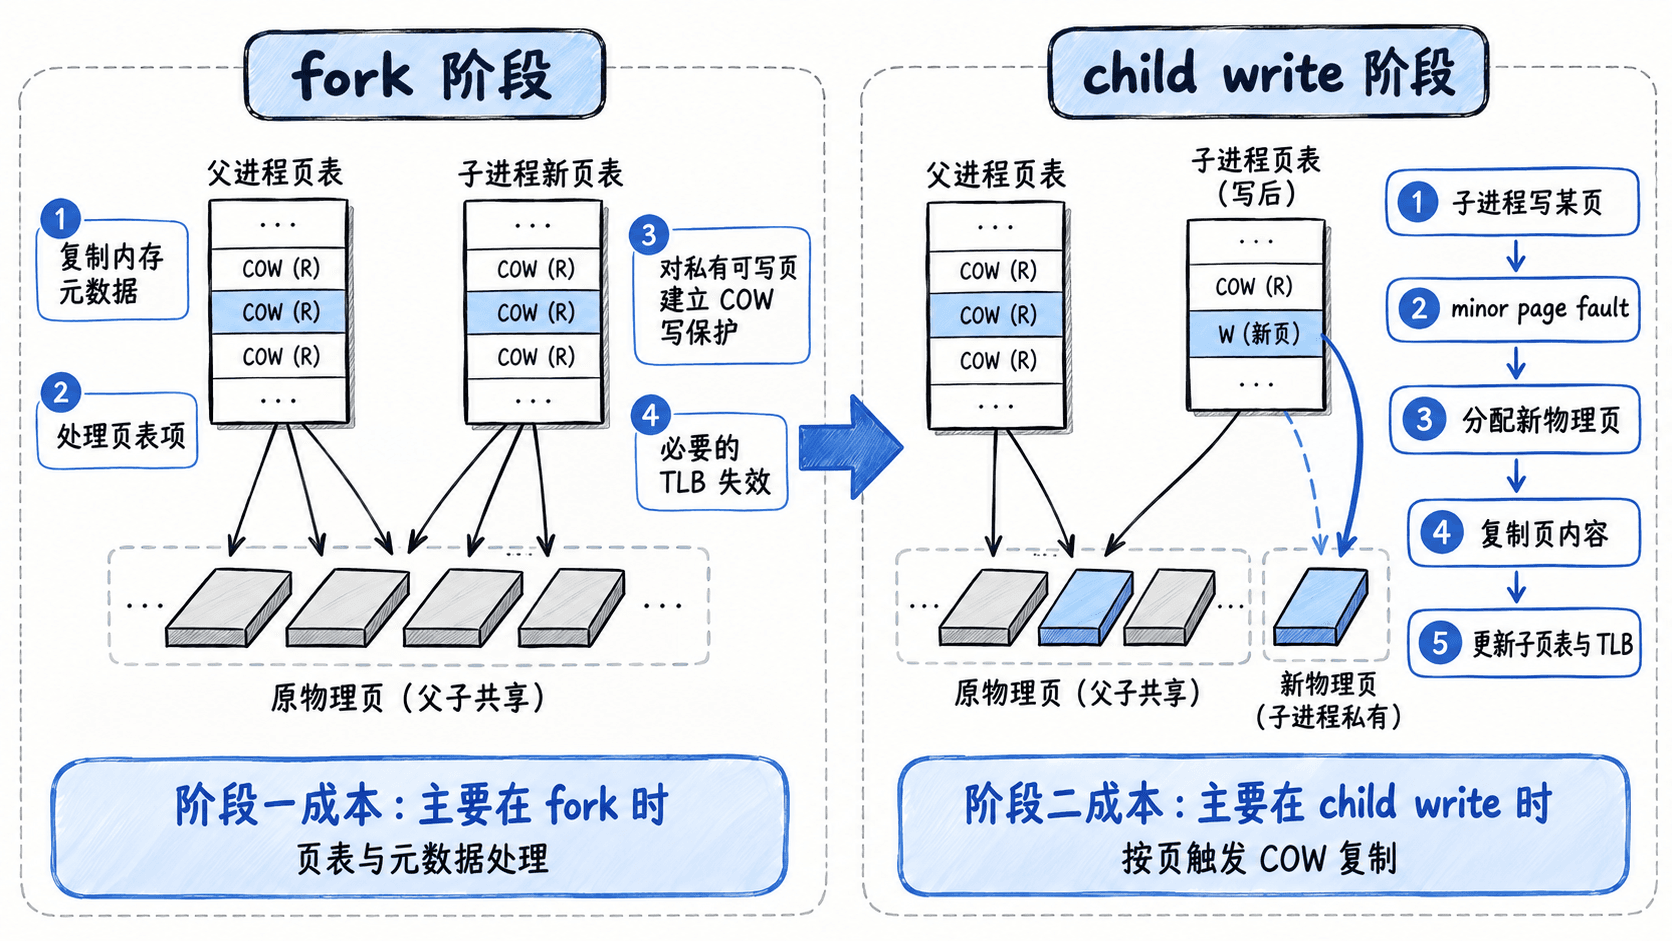
成本分成两个阶段
第一阶段发生在 fork 调用附近。内核要复制进程的内存映射描述,并处理相关页表。对私有可写映射建立 COW 关系时,还可能需要让旧的可写 TLB 条目失效,确保父子后续写入都能正确进入 COW 路径。
第二阶段发生在父进程或子进程第一次写共享页时。CPU 因写保护触发缺页异常,内核判断这是 COW 后,会准备可写私有页、复制原页内容、修改页表项,并让对应地址使用新的映射。这类缺页通常属于 minor fault,因为数据并不是从磁盘重新读入。
如果子进程 fork 后很快 exec,很多共享页根本不会被写,第二阶段成本很低;如果子进程马上改写一个很大的堆,COW 缺页数和内存复制带宽就可能成为主要开销。
用最小程序分开观察
下面的 Linux/Python 示例先触碰 64 MiB 内存,确保页已经建立映射,再测量 fork 返回时间;子进程随后每 4 KiB 写一次,主动触发大量 COW:
import os
import resource
import time

size = 64 * 1024 * 1024
page = 4096
buf = bytearray(size)

# 先触碰每页,避免把首次分配缺页混进 child 的 COW 统计。
for i in range(0, size, page):
    buf[i] = 1

t0 = time.perf_counter()
pid = os.fork()

if pid == 0:
    fork_ms = (time.perf_counter() - t0) * 1000
    before = resource.getrusage(resource.RUSAGE_SELF).ru_minflt

    cow_start = time.perf_counter()
    for i in range(0, size, page):
        buf[i] = (buf[i] + 1) & 0xFF
    cow_ms = (time.perf_counter() - cow_start) * 1000

    after = resource.getrusage(resource.RUSAGE_SELF).ru_minflt
    print(f"child fork: {fork_ms:.3f} ms", flush=True)
    print(f"child COW write: {cow_ms:.3f} ms", flush=True)
    print(f"child minor faults added: {after - before}", flush=True)
    os._exit(0)

os.waitpid(pid, 0)
预期输出
child fork: <FORK_MS> ms
child COW write: <COW_MS> ms
child minor faults added: <MINFLT_DELTA>
这些值受 CPU、内核版本、页大小、透明大页和系统负载影响,实际数值会不同。关键观察点不是某个固定毫秒数,而是 fork 本身有一段成本,随后批量写共享页又会产生一批额外的 minor fault 和复制开销。
大地址空间不等于一定很慢
虚拟地址范围很大但大部分没有建立页表的稀疏映射,未必比一个实际驻留且页表密集的进程更难 fork。同样,VMA 数量很多时,内核还要处理更多映射元数据;透明大页、共享映射以及内核版本中的页表优化也会改变实际成本。
所以排查时不要只看一个 RSS 数字。应把 fork 延迟、VMA 数量、页表规模、minor fault 增量以及 fork 后是否立刻大量写内存放在一起判断,才能区分是创建阶段慢,还是 COW 阶段慢。
什么时候要调整设计
如果服务依赖频繁 fork,而父进程又长期持有很大的可写堆,最好让子进程尽快 exec,减少对共享匿名页的写入;也可以把高频子任务交给预先创建的 worker,避免不断复制大地址空间的页表结构。
对延迟敏感的服务,真正要验证的是“fork 发生时父进程有多少有效映射,以及子进程接下来会写多少页”。COW 能推迟复制,但无法消除页表处理、TLB 维护和后续写缺页这些成本。