
操作系统 / 系统课时
TLB 命中为什么能省很多时间
TLB 命中为什么能省很多时间
多级页表虽然节省页表空间,却让一次地址转换可能需要多次访存。TLB 把最近使用的虚拟页到物理页框映射缓存在处理器内部,使绝大多数访存不必重复遍历页表。本节重点比较命中、未命中以及地址空间切换时发生的事情。
学习目标
- 能说明 TLB 缓存的对象,以及一次命中省掉了哪些页表访问
- 能区分 TLB 未命中与真正的页故障
- 能理解进程切换、地址空间标识和 TLB 失效之间的关系
TLB 缓存的是地址翻译结果
TLB 可以理解为 CPU 内部专门用于地址转换的小型高速缓存。它通常根据虚拟页号查询已经缓存的物理页框号,同时保存与访问控制有关的信息。
因此 CPU 执行一次读写时,会先用虚拟页号查询 TLB。若命中,就可以直接取得物理页框号,与页内偏移组合得到物理地址,而不需要再从内存中的页表逐级读取页表项。
TLB 容量远小于普通数据缓存,但它只需要保存近期活跃页面的翻译结果。程序常见的时间局部性和空间局部性使同一批页面会被反复访问,因此较小的 TLB 也能获得很高的命中价值。
命中与未命中的路径差在哪里
TLB 命中时,地址翻译可以直接利用缓存结果,然后继续访问数据缓存或内存。真正节省的不是最终那一次数据读取,而是原本为了找到页表项所需要的多级页表访问。
TLB 未命中时,处理器必须进行页表遍历。具体遍历可能由硬件自动完成,也可能在某些体系结构上需要软件参与。只要页表中仍然存在有效映射,遍历完成后就能把结果重新填入 TLB,再继续原来的访存。
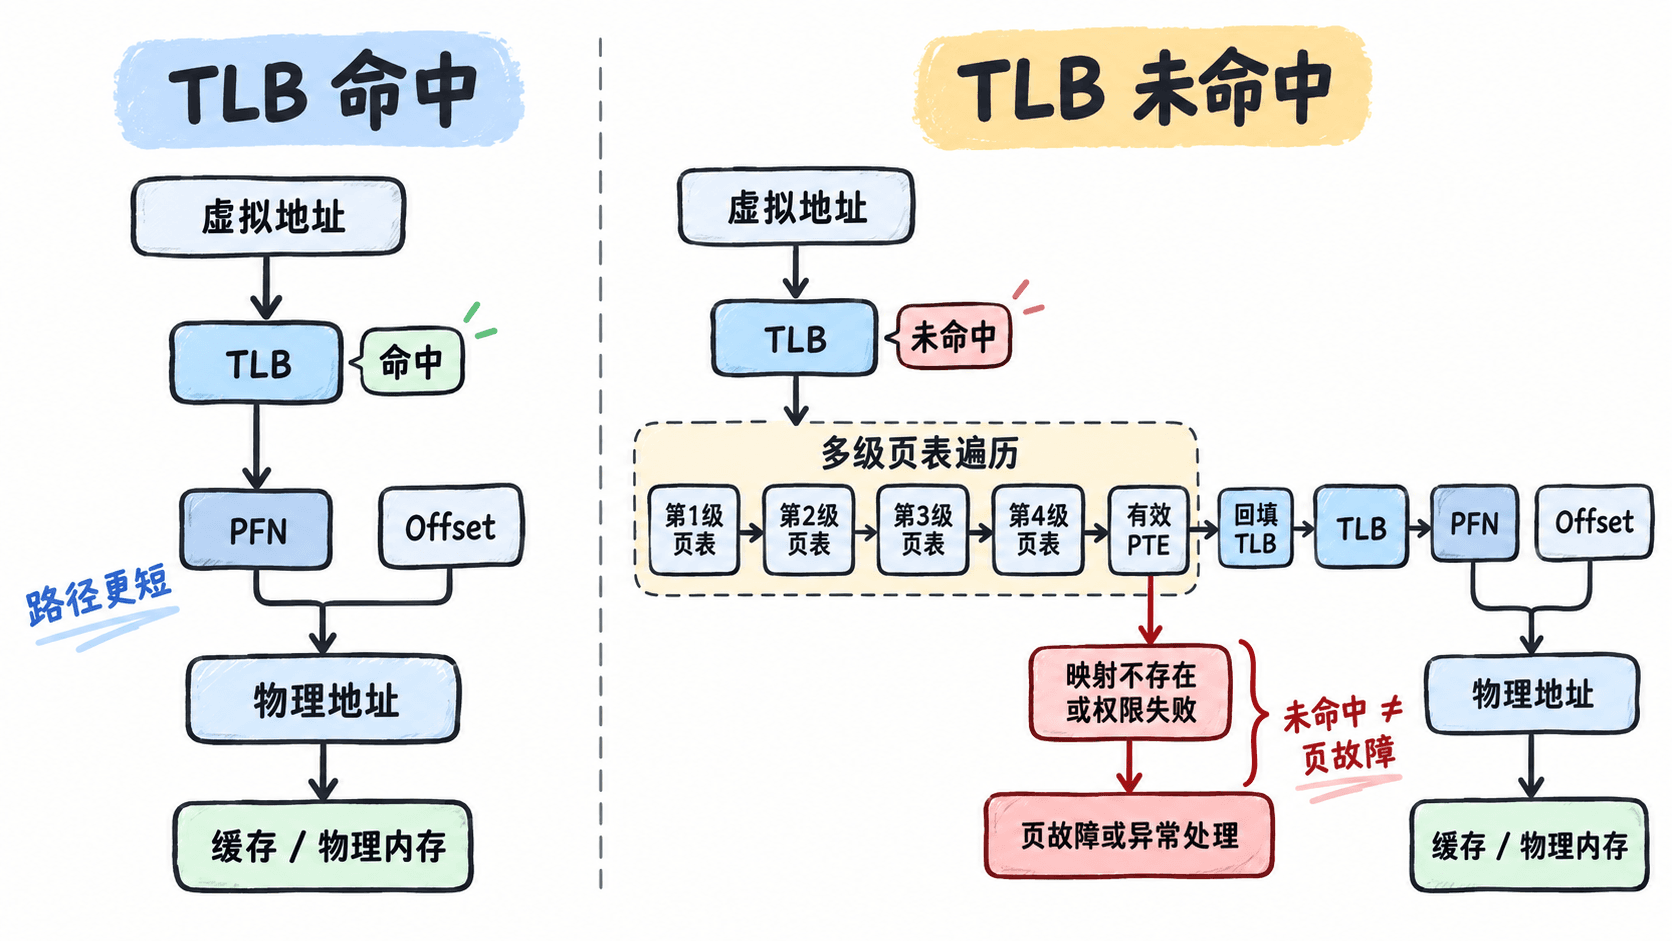
假设一个体系结构需要读取多级页表才能获得最终 PTE,那么 TLB 未命中可能引入多次额外的缓存或内存访问;而命中路径只需完成 TLB 查询和最终数据访问。实际耗时受缓存层级、处理器微架构和页表是否已在 CPU 缓存中等因素影响,因此不应把差异理解成固定的某个倍数。
地址空间切换为什么会影响 TLB
不同进程可以在相同虚拟地址上建立完全不同的映射。例如两个进程都可能使用虚拟地址 0x400000,但它们对应的物理页框并不相同。如果 CPU 在切换进程后错误复用前一个地址空间的 TLB 项,就可能访问错误的物理页面。
一种简单做法是在切换地址空间时清除相关 TLB 项,但这样会让新进程刚开始运行时产生较多 TLB 未命中。现代处理器通常提供 ASID、PCID 一类地址空间标签,让 TLB 项同时带有地址空间身份。这样不同进程的翻译结果可以共存,切换时不必总是把整个 TLB 清空。
这并不意味着 TLB 永远无需失效。如果内核修改了已经缓存的页表映射,例如撤销页面、修改权限或重新映射物理页,就必须确保处理器不再使用旧翻译。在多核系统中,同一地址空间还可能同时运行在多个 CPU 上,因此内核可能需要通知其他 CPU 失效对应项,这类跨核协调通常称为 TLB shootdown。
为什么大页也会影响 TLB 效率
一条普通 TLB 项若对应 4 KiB 页面,它只能覆盖这一小段虚拟地址;如果使用更大的页面,同样数量的 TLB 项就能覆盖更大的内存范围。这也是大页有机会降低 TLB miss 的原因之一。
但大页不是无条件更快。它可能增加内存碎片、页面分配难度和不必要的内存占用,因此应根据工作集、访问模式和实际性能指标判断,而不是只因为 TLB 覆盖范围更大就默认启用。
判断一次慢访存时,可以把路径分成三个层次:先看 TLB 是否已有翻译;没有时再看页表遍历能否得到有效 PTE;只有页表无法提供合法映射时,问题才升级为页故障或权限异常。把这三层分开,是分析地址转换开销和缺页问题时最重要的边界。