
容器与云原生 / 系统课时
形成线上排障决策树
形成线上排障决策树
线上 Service 故障真正困难的不是缺命令,而是缺“哪条证据决定下一步”。本课把访问边界、DNS、EndpointSlice、后端直连、数据平面与外部入口串成可执行分支,并明确何时止损、何时停止继续扩大排查范围。
学习目标
- 能根据访问边界和失败类型选择第一组高价值证据。
- 能用 DNS、EndpointSlice、Service 与后端直连结果决定下一条排障分支。
- 能把部分失败、大面积故障与近期变更纳入同一套止损和回滚决策流程。
把检查清单改成证据分支
真正的决策树不是“DNS → Service → EndpointSlice → Pod → 网络”按顺序检查,而是让每一步都回答一个问题:当前证据能排除哪一层,下一步只需验证哪两三种可能,什么时候应该停止继续向外扩散排查。
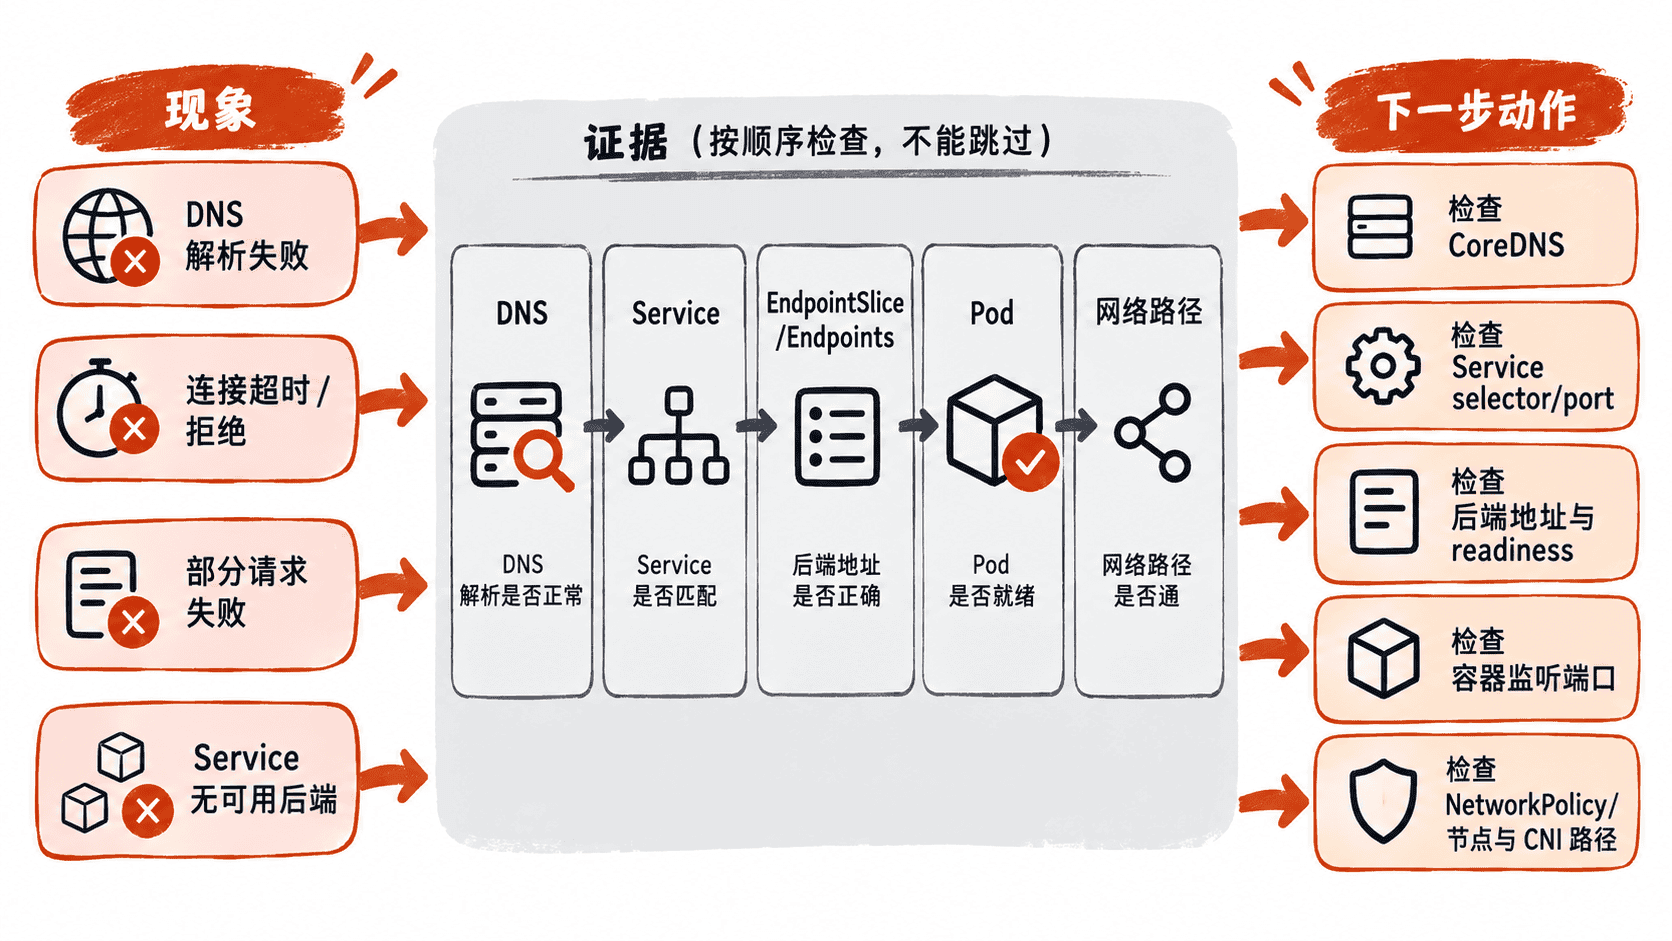
| 判定问题 | 关键证据 | 证据成立后的下一步 |
|---|---|---|
| 故障只发生在集群外吗 | 集群内访问同一 Service 的结果 | 内部成功就停止查 Pod 与 Service 基本链路,转查 LoadBalancer、NodePort、Gateway/Ingress、防火墙或云负载均衡 |
| Service 名称能解析吗 | nslookup 或 getent hosts |
解析失败就只查名称、命名空间、CoreDNS 与 DNS 路径,不继续测 ClusterIP |
| EndpointSlice 有可用地址吗 | EndpointSlice 地址、端口与 Pod readiness | 没有地址就查 selector、标签和 readiness;此时不进入 kube-proxy/eBPF 排查 |
| 后端 Pod 直连成功吗 | Pod IP 加 EndpointSlice 端口 | 直连失败就查应用监听、Pod 状态、NetworkPolicy/CNI;直连成功而 Service 失败才进入 Service 端口映射和数据平面 |
| 失败是否绑定单个 Pod 或节点 | 逐 Endpoint 探测与 Pod 所在节点 | 绑定单 Pod 按实例故障处理;绑定同一节点上的多个 Pod 时优先查该节点的数据平面与 CNI |
| 故障是否与近期变更高度相关 | 发布时间、策略变更时间、错误率曲线 | 影响扩大且证据吻合时优先回滚最近变更,同时保留现场证据 |
对于 Headless Service,clusterIP: None 本身不是异常。它的 DNS 直接返回后端地址,因此判断重点应放在 DNS 返回的 Endpoint、端口和直连结果,而不是等待一个 ClusterIP。
用三组对照形成最小证据链
下面以“同一命名空间中的单端口 HTTP Service,/healthz 正常时返回 ok”为主示例。先读取对象状态,再从临时调试 Pod 分别验证 DNS、Service 和某个后端。<NAMESPACE>、<SERVICE_NAME>、<PORT>、<POD_IP>、<TARGET_PORT> 与 <LABEL_SELECTOR> 需要替换为实际值。
kubectl -n <NAMESPACE> get svc <SERVICE_NAME> -o wide
kubectl -n <NAMESPACE> get endpointslice -l kubernetes.io/service-name=<SERVICE_NAME> -o wide
kubectl -n <NAMESPACE> get pods -l <LABEL_SELECTOR> -o wide

kubectl -n <NAMESPACE> run debug-dns --rm -i --restart=Never --image=busybox:1.36 -- nslookup <SERVICE_NAME>.<NAMESPACE>.svc
kubectl -n <NAMESPACE> run debug-svc --rm -i --restart=Never --image=busybox:1.36 -- wget -T 3 -qO- http://<SERVICE_NAME>:<PORT>/healthz
kubectl -n <NAMESPACE> run debug-pod --rm -i --restart=Never --image=busybox:1.36 -- wget -T 3 -qO- http://<POD_IP>:<TARGET_PORT>/healthz
预期结果(名称、地址和端口会因集群而不同):
NAME       TYPE        CLUSTER-IP   PORT(S)
<service>  ClusterIP   <IP>         <PORT>/<PROTO>

NAME             ADDRESSTYPE   PORTS           ENDPOINTS
<endpointslice>  IPv4          <TARGET_PORT>   <POD_IP>,<POD_IP>

NAME     READY   STATUS    IP
<pod-a>  1/1     Running   <POD_IP>

Name:    <SERVICE_NAME>.<NAMESPACE>.svc.cluster.local
Address: <SERVICE_CLUSTER_IP>

ok
ok
这三组对照不是为了“都跑一遍”,而是为了尽快分流:DNS 失败时停止后续 Service 探测;DNS 成功、Pod 直连成功而 Service 失败时,问题才收敛到 port、targetPort、协议或 kube-proxy/eBPF 数据平面;Service 和 Pod 直连都失败时,应把注意力转向应用监听、readiness、NetworkPolicy 与节点到 Pod 的路径。
按结果选择下一跳
如果 EndpointSlice 为空,先比较 Service 的 selector 与 Pod 标签,再确认候选 Pod 是否 Ready。Pod 处于 Running 只表示进程容器正在运行,并不等价于它会作为普通 Service 的可用后端参与转发。
如果 EndpointSlice 有地址,但所有后端直连都失败,继续检查 Service 对象通常不会产生新证据。此时应验证容器实际监听的地址和端口、应用进程、NetworkPolicy、CNI 以及节点到 Pod 的路由或封装路径。
如果 Pod 直连稳定成功,而通过 Service 失败,再核对 Service 的 port、targetPort、协议与 EndpointSlice 端口是否对应。若失败只发生在特定节点,从正常节点和异常节点各发起一次相同请求,比全局重启 kube-proxy 或 CNI 更有判别力。
如果只有部分请求失败,逐个 Endpoint 测试并记录 Pod 与节点归属。失败稳定绑定某个 Pod 时优先按实例故障处理;失败稳定绑定某个节点上的多个 Pod 时,更像节点级数据平面或 CNI 问题。只有这些网络证据都正常后,才把排查范围移到应用协议、连接池、超时与上游依赖。
设置止损和停止条件
线上排障应先执行只读查询和低风险探测,不要把“重启 CoreDNS、删除 Pod、重建 Service”当成探索命令。每个分支都应有停止条件:集群内访问正常就停止查 Service 基础链路;EndpointSlice 为空就停止查数据平面;后端直连全部失败就停止反复检查 ClusterIP。
当部分 Endpoint 已被证据确认异常且错误率正在扩大时,优先修复 readiness、回滚异常版本或按既有发布流程摘除故障实例。不要为了“试一下”直接修改 selector,把状态未知的 Pod 强行加入流量。
如果大面积故障与刚发生的 NetworkPolicy、Service、Ingress/Gateway 或数据平面变更在时间上高度一致,并且回滚路径明确,应优先回滚最近变更,同时保留 get、describe、事件、关键日志与受影响节点信息。恢复服务优先于继续扩大诊断范围。
可复用的线上决策树最终应满足三个条件:每条命令回答一个明确问题,每个结果只通向少数下一步,每个分支都有停止或止损边界。这样一次排障过程才能沉淀为下一次可直接执行的决策流程。