
容器与云原生 / 系统课时
构造 Service 无端点故障
构造 Service 无端点故障
Service 对象和 ClusterIP 都正常时,流量仍可能因为没有后端而失败。本课用实验专用 Service 和唯一独立 Pod 构造标签失配,并等待 EndpointSlice 实际收敛,再用 selector、Pod 标签和请求结果组成完整证据链,最后恢复标签验证数据路径恢复。
学习目标
- 用实验专用 selector 和唯一独立 Pod 稳定构造 Service 无端点故障。
- 用 Service selector、Pod 标签与 EndpointSlice 判断后端发现链路是否中断。
- 恢复标签后同时验证端点重新出现和 Service 请求成功。
建立可重复的唯一后端前提
只修改一个 Pod 标签,只有在该 Pod 是 Service 的唯一匹配后端时,才能稳定得到零端点。为避免 Deployment、ReplicaSet 等控制器自动补副本,本实验在独立命名空间中创建不带 Owner 的单 Pod,并让 Service selector 同时匹配 app=demo 与 fault-scope=single。这样只有目标 Pod 同时具备两个标签,其他 Pod 即使存在也不会进入该 Service 的后端集合。
EndpointSlice 由控制器异步更新,因此标签变化后不能假定地址“立即”消失或恢复。实验会显式等待端点数量收敛到目标值,再进入下一步。
构造并验证无端点故障
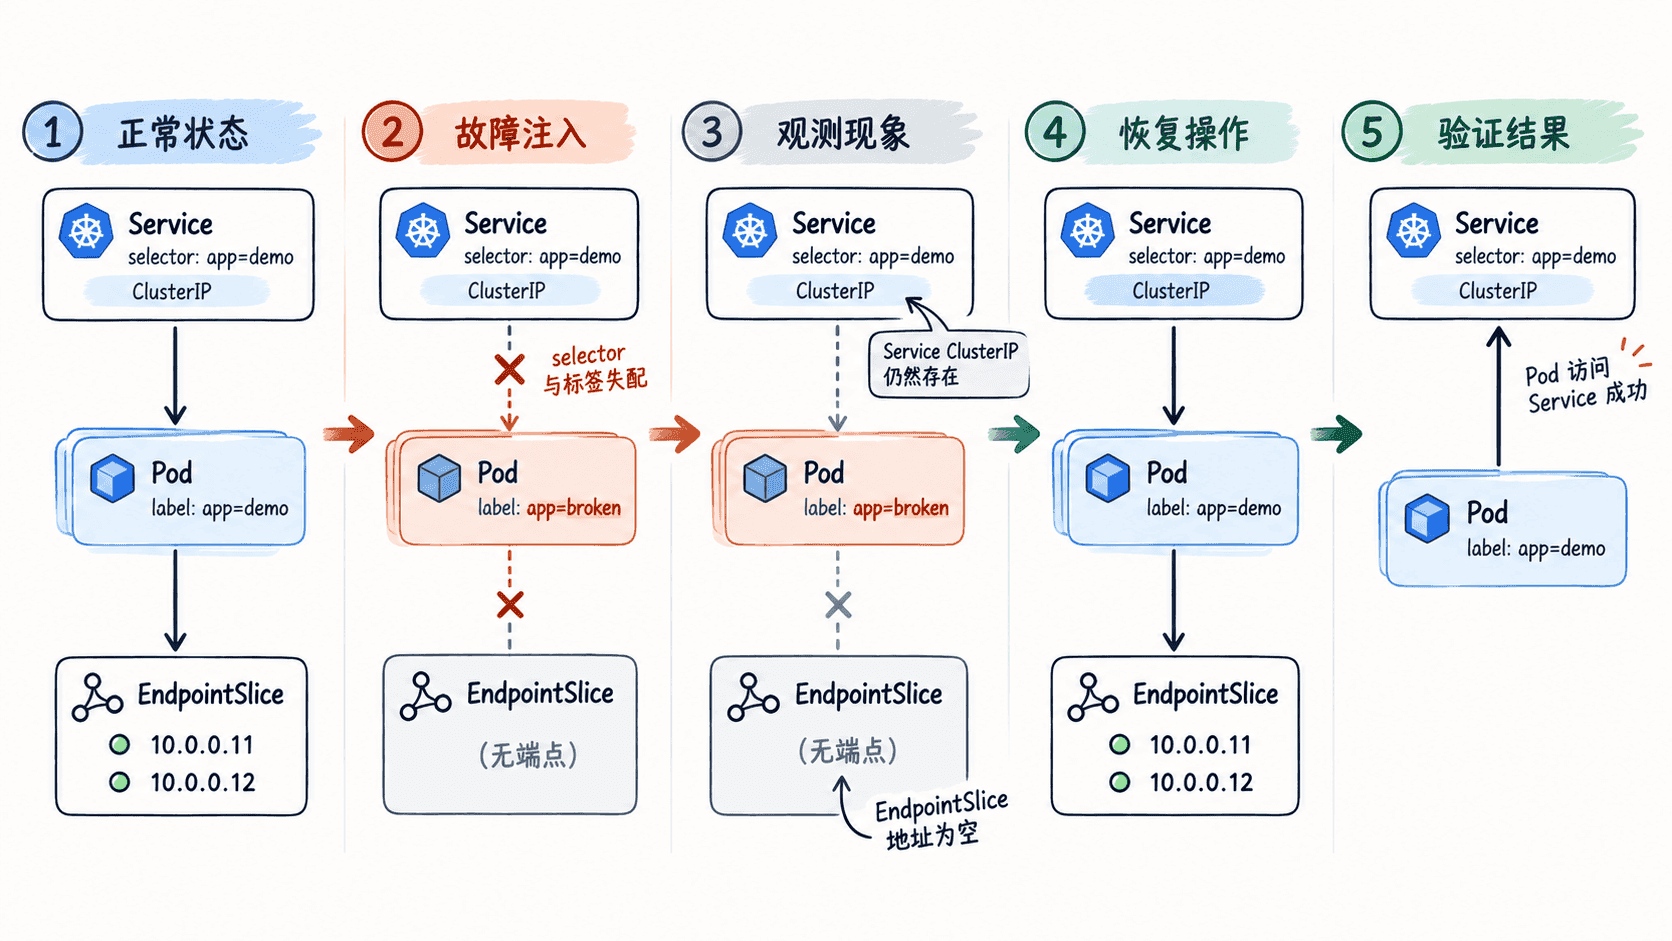
下面是一份完整主示例。它先建立唯一后端并验证前提,再把唯一 Pod 的 fault-scope 从 single 改为 broken;此时 selector 不再匹配任何 Pod。脚本等待 EndpointSlice 地址数变为 0 后发起请求,随后恢复标签并再次等待地址数变为 1。
set -eu

ns=svc-endpoint-lab
svc=demo-svc
backend=demo-backend
client=client

kubectl delete namespace "$ns" --ignore-not-found >/dev/null 2>&1 || true
kubectl create namespace "$ns" >/dev/null

kubectl -n "$ns" run "$backend"   --image=nginx:1.27-alpine   --restart=Never   --labels='app=demo,fault-scope=single' >/dev/null

kubectl -n "$ns" expose pod "$backend"   --name="$svc"   --port=80   --target-port=80 >/dev/null

# 固定实验 Service 的 selector,确保只有同时满足两个标签的 Pod 才能成为后端。
kubectl -n "$ns" patch service "$svc" --type=merge   -p '{"spec":{"selector":{"app":"demo","fault-scope":"single"}}}' >/dev/null

kubectl -n "$ns" run "$client"   --image=busybox:1.36   --restart=Never   --labels='app=client'   -- sleep 3600 >/dev/null

kubectl -n "$ns" wait   --for=condition=Ready   pod/"$backend" pod/"$client"   --timeout=90s >/dev/null

endpoint_count() {
  addresses=$(kubectl -n "$ns" get endpointslice     -l "kubernetes.io/service-name=$svc"     -o jsonpath='{range .items[*].endpoints[*]}{.addresses[0]}{" "}{end}')
  set -- $addresses
  echo "$#"
}

wait_for_endpoint_count() {
  expected=$1
  count=-1
  for _ in $(seq 1 30); do
    count=$(endpoint_count)
    if [ "$count" -eq "$expected" ]; then
      echo "$count"
      return 0
    fi
    sleep 1
  done
  echo "timeout waiting endpoint_count=$expected, last=$count" >&2
  return 1
}

matching=$(kubectl -n "$ns" get pods   -l 'app=demo,fault-scope=single'   -o name | wc -l | tr -d ' ')
owner_count=$(kubectl -n "$ns" get pod "$backend"   -o go-template='{{len .metadata.ownerReferences}}')
before_endpoints=$(wait_for_endpoint_count 1)

echo "before_matching_pod_count=$matching"
echo "owner_count=$owner_count"
echo "before_endpoint_count=$before_endpoints"

if [ "$matching" -ne 1 ] || [ "$owner_count" -ne 0 ]; then
  echo "unique backend prerequisite failed" >&2
  exit 1
fi

kubectl -n "$ns" label pod "$backend" fault-scope=broken --overwrite >/dev/null

after_matching=$(kubectl -n "$ns" get pods   -l 'app=demo,fault-scope=single'   -o name | wc -l | tr -d ' ')
after_endpoints=$(wait_for_endpoint_count 0)

echo "after_matching_pod_count=$after_matching"
echo "after_endpoint_count=$after_endpoints"
echo "service_selector_app=$(kubectl -n "$ns" get svc "$svc" -o jsonpath='{.spec.selector.app}')"
echo "service_selector_fault_scope=$(kubectl -n "$ns" get svc "$svc" -o jsonpath='{.spec.selector.fault-scope}')"
echo "pod_fault_scope=$(kubectl -n "$ns" get pod "$backend" -o jsonpath='{.metadata.labels.fault-scope}')"

request_result=$(kubectl -n "$ns" exec "$client" -- sh -c   'if wget -q -T 3 -O /dev/null http://demo-svc/; then echo UNEXPECTED_SUCCESS; else echo EXPECTED_FAILURE; fi')
echo "request_during_fault=$request_result"

kubectl -n "$ns" label pod "$backend" fault-scope=single --overwrite >/dev/null

restored_matching=$(kubectl -n "$ns" get pods   -l 'app=demo,fault-scope=single'   -o name | wc -l | tr -d ' ')
restored_endpoints=$(wait_for_endpoint_count 1)
service_result=$(kubectl -n "$ns" exec "$client" -- sh -c   'wget -q -T 3 -O /dev/null http://demo-svc/ && echo ok')

echo "restored_matching_pod_count=$restored_matching"
echo "restored_endpoint_count=$restored_endpoints"
echo "service_request=$service_result"
预期输出
before_matching_pod_count=1
owner_count=0
before_endpoint_count=1
after_matching_pod_count=0
after_endpoint_count=0
service_selector_app=demo
service_selector_fault_scope=single
pod_fault_scope=broken
request_during_fault=EXPECTED_FAILURE
restored_matching_pod_count=1
restored_endpoint_count=1
service_request=ok
只要前置三项不是 1、0、1,就不应继续制造故障。尤其是匹配 Pod 多于 1 个时,修改其中一个标签只会减少端点,不会得到稳定的零端点结果;脚本因此先验证唯一后端,再执行故障步骤。
从证据链定位根因
故障阶段的关键证据是同一条因果链:Service 仍要求 app=demo,fault-scope=single,目标 Pod 已变成 fault-scope=broken,匹配 Pod 数为 0,EndpointSlice 中也没有地址。此时没有必要先修改 Service 类型、ClusterIP 或 kube-proxy 配置,因为后端发现已经在 selector 这一层明确中断。
实际请求只用来确认数据路径与控制面证据一致。没有后端时,请求可能表现为超时、拒绝连接或其他网络错误,因此示例只判断命令是否失败,不把某一种错误文本当作所有集群都必须出现的固定结果。
恢复并检查排查边界
恢复时把同一个 Pod 的 fault-scope 改回 single,等待 EndpointSlice 地址数重新变为 1,再请求 Service。只有“唯一匹配 Pod 恢复”“端点恢复”和“业务请求成功”同时成立,才能确认故障已经从资源关系一直恢复到实际流量路径。
线上遇到“Service 存在但不可用”时,零地址并不只有 selector 失配这一种原因。还应检查工作负载是否存在、Pod 是否正在滚动或缩容,以及 Service selector 是否被误改。如果 EndpointSlice 仍有地址但端点处于未就绪状态,则应继续检查 Pod Ready 条件和应用监听,而不能把它误判为本课构造的“完全无端点”场景。