
容器与云原生 / 系统课时
识别节点级 Service 转发异常
识别节点级 Service 转发异常
当 Pod IP 直连正常、但 ClusterIP 只在部分节点访问失败时,重点应转向节点上的 Service 数据平面。本课按“跨节点对照 → Service 与后端校验 → 识别代理实现 → 节点规则与日志检查 → 复验”定位问题,避免把流量策略或后端网络异常误判为 kube-proxy 故障。
学习目标
- 能通过跨节点对照判断故障是否局限于单个节点
- 能核对 Service、EndpointSlice 与
internalTrafficPolicy是否符合预期 - 能先识别 Service 代理实现,再选择匹配的数据平面检查方法
先把异常定位到节点
Service 请求从客户端 Pod 发出后,会先经过客户端所在节点的 Service 转发实现,再被送往某个 Ready 后端。首先比较同一 ClusterIP 在不同节点上的表现;只有正常节点与异常节点形成稳定差异,才应继续检查节点本地的数据平面。
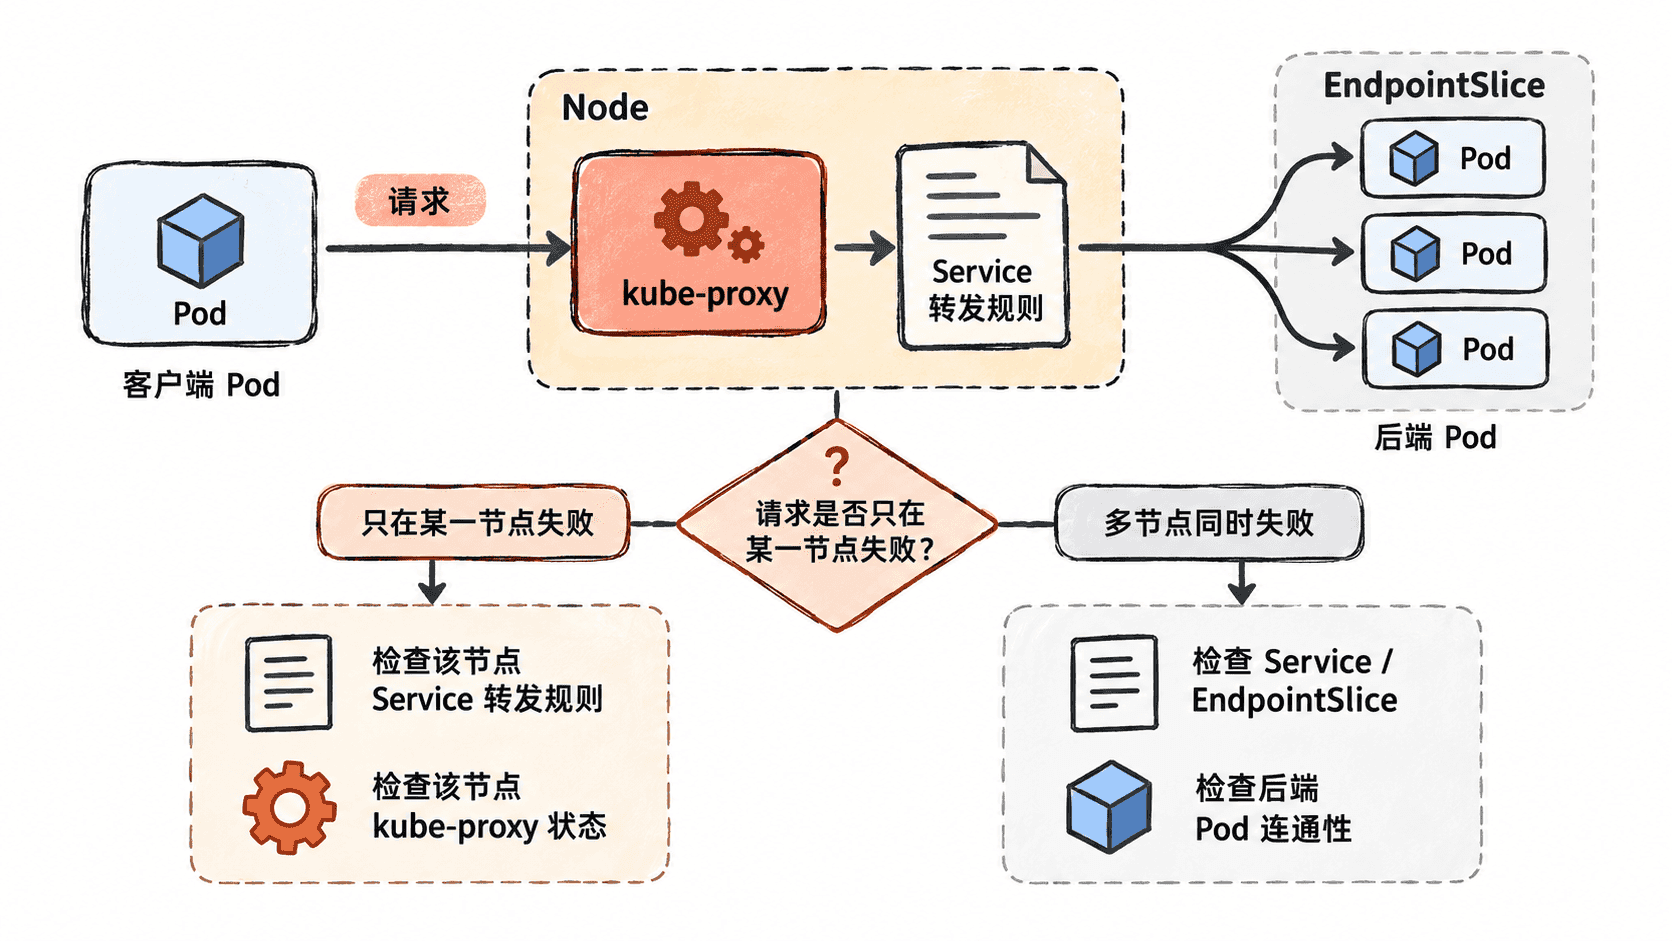
确认 Service 与 EndpointSlice 健康
先排除 Service 没有可用后端,或流量策略本来就要求只选本地后端。特别是 internalTrafficPolicy: Local 时,节点没有本地 Ready endpoint 会导致该节点无法把内部 Service 流量转到其他节点,这是策略语义,不应直接判定为代理同步异常。
将占位符替换为实际值后执行:
NS=<NAMESPACE>
SVC=<SERVICE_NAME>

kubectl -n "$NS" get svc "$SVC" -o wide
kubectl -n "$NS" get svc "$SVC" -o jsonpath='clusterIP={.spec.clusterIP} internalTrafficPolicy={.spec.internalTrafficPolicy}{"\n"}'
kubectl -n "$NS" get endpointslice   -l kubernetes.io/service-name="$SVC"   -o custom-columns='ADDRESS:.endpoints[*].addresses[*],READY:.endpoints[*].conditions.ready,NODE:.endpoints[*].nodeName'
预期结果
clusterIP=<CLUSTER_IP> internalTrafficPolicy=<POLICY>
ADDRESS          READY   NODE
<POD_IP>         true    <NODE_NAME>
至少应存在一个 Ready endpoint。若策略为 Local,还要确认异常节点上存在本地 Ready endpoint;如果不存在,应先按策略解释现象。
用跨节点请求锁定故障边界
选择一个正常节点上的客户端 Pod 和一个异常节点上的客户端 Pod,对同一个 ClusterIP 发起请求;随后从异常节点上的客户端直连一个 Ready 后端 Pod IP。下面以 HTTP 服务为例,客户端镜像需要包含 curl。
NS=<NAMESPACE>
GOOD_CLIENT=<CLIENT_POD_ON_HEALTHY_NODE>
BAD_CLIENT=<CLIENT_POD_ON_SUSPECT_NODE>
CLUSTER_IP=<CLUSTER_IP>
SERVICE_PORT=<SERVICE_PORT>
POD_IP=<READY_BACKEND_POD_IP>
TARGET_PORT=<TARGET_PORT>

kubectl -n "$NS" exec "$GOOD_CLIENT" -- curl -fsS --connect-timeout 3 "http://$CLUSTER_IP:$SERVICE_PORT/"
kubectl -n "$NS" exec "$BAD_CLIENT" -- curl -fsS --connect-timeout 3 "http://$CLUSTER_IP:$SERVICE_PORT/"
kubectl -n "$NS" exec "$BAD_CLIENT" -- curl -fsS --connect-timeout 3 "http://$POD_IP:$TARGET_PORT/"
预期结果
正常节点访问 ClusterIP:返回应用的正常响应
异常节点访问 ClusterIP:失败或超时
异常节点直连 Ready Pod IP:返回应用的正常响应
如果出现这组结果,故障更符合异常节点上的 Service 转发层问题。若异常节点连 Pod IP 也失败,应转查 CNI、节点路由、防火墙、NetworkPolicy 或后端 Pod,而不是继续把范围限定在 Service proxy。
识别代理实现后再检查数据平面
不要把 iptables-save 当作所有节点的通用检查。Linux 上的 kube-proxy 可以使用 iptables、ipvs 或 nftables 模式,Windows 使用 kernelspace;集群也可能由其他组件实现 Service 转发。先确认是否部署 kube-proxy,并查看它的启动参数或配置入口。
kubectl -n kube-system get ds kube-proxy -o wide
kubectl -n kube-system get ds kube-proxy   -o jsonpath='{.spec.template.spec.containers[0].args}{"\n"}'
预期结果
使用 kube-proxy:能看到 DaemonSet;参数可能包含 --proxy-mode=<MODE>,也可能通过 --config=<PATH> 加载配置。
未使用 kube-proxy:可能返回 NotFound,此时应确认集群实际使用的 Service proxy。
若参数通过 --config=<PATH> 指向配置文件,应继续查看对应挂载配置中的 mode。确认 Linux 节点的实际模式后,在异常节点执行与模式匹配的检查;以下分支只会执行其中一个。
MODE=<PROXY_MODE>
CLUSTER_IP=<CLUSTER_IP>

case "$MODE" in
  iptables) sudo iptables-save | grep -F "$CLUSTER_IP" ;;
  nftables) sudo nft list ruleset | grep -F "$CLUSTER_IP" ;;
  ipvs) sudo ipvsadm -Ln | grep -F "$CLUSTER_IP" ;;
  *) echo "unsupported kube-proxy mode: $MODE"; exit 2 ;;
esac
预期结果
在当前代理模式对应的规则、集合或虚拟服务中能定位到 <CLUSTER_IP>。
若异常节点缺少对应状态,而正常节点存在同一 Service 的转发状态,应优先调查该节点的同步失败。
如果集群使用替代 Service proxy,应改用该实现提供的 Service 映射、数据平面状态与日志检查方法,不能套用 kube-proxy 的 iptables、nftables 或 IPVS 命令。
检查异常节点上的代理状态并复验
若集群使用 kube-proxy,应检查异常节点上的实例,而不是只确认整个 DaemonSet 存在 Running Pod。持续出现 API Server 连接失败、配置加载失败或规则同步失败,才是更直接的节点级证据。
kubectl -n kube-system get pods   -l k8s-app=kube-proxy   --field-selector spec.nodeName=<SUSPECT_NODE>   -o wide

kubectl -n kube-system logs <KUBE_PROXY_POD_ON_SUSPECT_NODE> --tail=100
预期结果
目标节点上的 kube-proxy Pod 处于 Running,且日志没有持续重复的配置、API 连接或规则同步错误。
如果存在重复同步错误,应先修复对应根因,再进行数据平面复验。
修复后重新执行跨节点 ClusterIP 请求,并确认原异常节点与正常节点行为恢复一致。Running 只证明代理进程存活;真正的恢复证据是 Service 请求恢复、后端选择正常,并且节点之间不再出现稳定差异。