
容器与云原生 / 系统课时
理解 CoreDNS 请求链路
理解 CoreDNS 请求链路
这一课把一次集群内 DNS 解析拆成可验证的链路,并明确区分“Pod 发出的 DNS 查询”与“DNS 组件读取 Kubernetes 数据”这两类流量。完成后,你可以从 Pod 的实际配置出发,判断故障发生在 DNS 入口、CoreDNS 处理、Kubernetes 数据同步还是名称本身。
学习目标
- 能说明
dnsPolicy、/etc/resolv.conf、集群 DNS 入口与 CoreDNS 的关系 - 能区分 DNS 请求流和 CoreDNS
kubernetes插件的数据获取流 - 能用
kubectl与nslookup沿实际链路验证 Service 名称解析
Pod 先决定查询发往哪里
应用发起名称解析时,首先遵循容器内的解析器配置。对 Linux Pod 来说,最直接的证据是 /etc/resolv.conf 中的 nameserver、search 和 options。这些值受 Pod 的 dnsPolicy、可选的 dnsConfig 以及 kubelet 的集群 DNS 配置影响,因此不能先假定请求一定直达某个固定 Service。
未显式设置时,Pod 的默认 DNS 策略通常是 ClusterFirst。在常见部署中,nameserver 指向集群 DNS Service 的 ClusterIP;启用了 NodeLocal DNSCache 等机制时,也可能先指向节点本地 DNS 地址,再由它转发。kube-dns 是集群 DNS Service 常见的兼容性命名约定,但不是所有发行版都必须使用这个名称,应以当前集群对象和 Pod 实际配置为准。
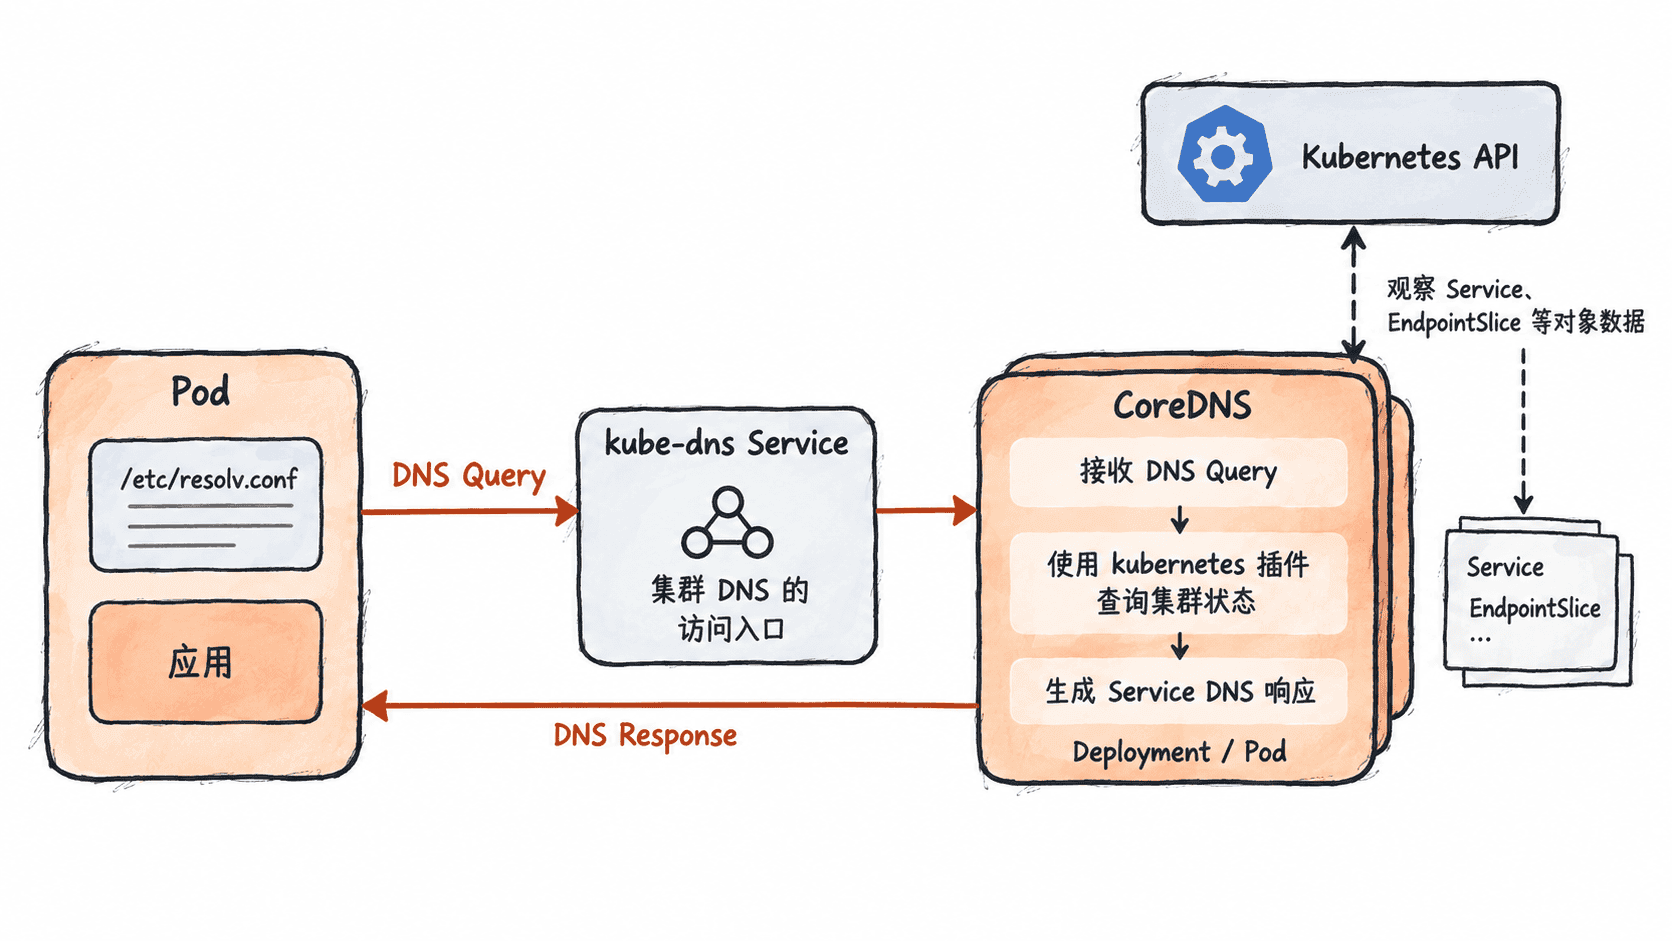
区分 DNS 请求流与 Kubernetes 数据流
如果集群使用 CoreDNS,并且 Corefile 在对应区域启用了 kubernetes 插件,那么该插件会从 Kubernetes API 获取并维护用于服务发现的数据;当前实现会监视 Service,并通过 EndpointSlice API 获取端点信息。具体哪些对象参与回答,还取决于查询记录类型和插件配置,例如普通 ClusterIP Service 与无头 Service 所需的数据并不完全相同。
这条 API 访问链路不是 Pod DNS 查询本身。请求流是“Pod 解析器 → Pod 配置的 nameserver → 可能的本地缓存或 DNS Service → CoreDNS”;数据流则是“CoreDNS 的 kubernetes 插件 ↔ Kubernetes API”。如果集群没有使用 CoreDNS,或者 CoreDNS 没有为该区域启用 kubernetes 插件,请求处理链路会不同,排障时必须先确认实际部署。
CoreDNS Pod 显示为 Running 只能说明容器进程处于运行状态,不能证明业务 Pod 一定能访问它,也不能单独证明插件已经同步到回答目标名称所需的数据。
用调试 Pod 验证端到端解析
下面创建一个默认使用 ClusterFirst 的临时 Pod,查看真实的 DNS 策略和解析器配置,再查询 Kubernetes 默认 Service。示例假定集群域为 cluster.local;如果你的集群使用其他域名,请把查询中的后缀替换为实际值。
kubectl run dns-debug -n default --image=busybox:1.36 --restart=Never -- sleep 3600
kubectl wait -n default --for=condition=Ready pod/dns-debug --timeout=60s

kubectl get pod -n default dns-debug -o jsonpath='{.spec.dnsPolicy}{"\n"}'
kubectl exec -n default dns-debug -- cat /etc/resolv.conf
kubectl exec -n default dns-debug -- nslookup kubernetes.default.svc.cluster.local
预期结果
ClusterFirst
search default.svc.cluster.local svc.cluster.local cluster.local
nameserver <IP>
options ndots:5

Server:    <IP>
Address:   <IP>:53
Name:      kubernetes.default.svc.cluster.local
Address:   <IP>
实际的搜索域、DNS 地址和 nslookup 输出格式可能不同。关键证据是 Pod 的 DNS 策略与 /etc/resolv.conf 相互一致,并且完整 Service 名称能够获得地址。若这里失败,先保留 nameserver 的实际值,不要急着把问题归因于 CoreDNS。
对照 nameserver 找到实际 DNS 入口
继续从调试 Pod 取出首个 nameserver,再在所有 Service 中查找相同 ClusterIP。下面的脚本同时处理“它不是 Service ClusterIP”的情况,这在 NodeLocal DNSCache 等部署中是正常现象。
DNS_IP=$(kubectl exec -n default dns-debug -- awk '/^nameserver/{print $2; exit}' /etc/resolv.conf)

DNS_SVC=$(
  kubectl get svc -A -o jsonpath='{range .items[*]}{.metadata.namespace}{"/"}{.metadata.name}{" "}{.spec.clusterIP}{"\n"}{end}' |
  awk -v ip="$DNS_IP" '$2 == ip {print $1; exit}'
)

printf 'DNS_IP=%s\n' "$DNS_IP"
printf 'DNS_SERVICE=%s\n' "${DNS_SVC:-<not-a-service-clusterip>}"

if [ -n "$DNS_SVC" ]; then
  DNS_NS=${DNS_SVC%/*}
  DNS_NAME=${DNS_SVC#*/}
  kubectl get svc -n "$DNS_NS" "$DNS_NAME" -o wide
  kubectl get endpointslice -n "$DNS_NS" -l "kubernetes.io/service-name=$DNS_NAME" -o wide
fi
预期结果
DNS_IP=<IP>
DNS_SERVICE=<NAMESPACE>/<DNS_SERVICE>
NAME          TYPE        CLUSTER-IP   PORT(S)
<DNS_SERVICE> ClusterIP   <IP>         <PORTS>

NAME              ADDRESSTYPE   PORTS   ENDPOINTS
<ENDPOINTSLICE>   <TYPE>        <PORTS> <IP>
如果输出为 DNS_SERVICE=<not-a-service-clusterip>,不要据此判定 DNS 异常;这说明 Pod 配置的入口不是某个 Service ClusterIP,应继续检查节点本地 DNS 缓存或发行版提供的 DNS 转发组件。若能匹配到 Service,则再核对 53/UDP、53/TCP 等实际端口以及 EndpointSlice 中是否存在可用后端。
按返回现象逐层定位
完整域名能解析、短名称失败时,优先检查 search、ndots、命名空间和 Pod DNS 策略。查询直接超时时,应先检查 Pod 到其实际 nameserver 的网络路径,再检查 DNS Service、EndpointSlice、NodeLocal DNSCache 或网络策略,而不是只看 CoreDNS 是否 Running。
如果请求已经到达 CoreDNS,但返回 NXDOMAIN,再核对查询名称、命名空间、集群域以及对应 Service 是否存在;若返回 SERVFAIL,则应继续检查 CoreDNS 配置、插件状态、上游 DNS,以及启用 kubernetes 插件时它与 Kubernetes API 的同步情况。
把证据固定为“Pod DNS 策略与解析器配置 → 实际 nameserver → DNS 转发或 Service 后端 → CoreDNS 实际插件配置与数据源 → DNS 响应”,就能避免把客户端配置、DNS 传输路径和 Kubernetes 服务发现数据混成一个问题。