
容器与云原生 / 系统课时
排查服务名称解析失败
排查服务名称解析失败
当 Pod 出现 can't resolve、SERVFAIL、NXDOMAIN 或 DNS 查询超时时,本课聚焦“证据链”而不是重复名称拼接规则:从 Pod 发出的查询开始,依次核对 DNS Service、CoreDNS 实例和 Kubernetes API 中的 Service 记录,直到把故障定位到具体一段。
学习目标
- 能沿 Pod → DNS Service → CoreDNS → Kubernetes API 的请求链收集证据
- 能根据超时、
SERVFAIL、NXDOMAIN等现象缩小故障范围 - 能正确判断普通 ClusterIP Service 与 Headless Service 对 EndpointSlice 的依赖差异
先固定同一份证据
排障时应固定同一个测试 Pod 和目标 Service,一次性记录解析器配置、DNS Service、CoreDNS 状态以及目标 Service。这样后续每个判断都来自同一时刻的证据,避免在不同 Pod 或命名空间之间切换后得到互相矛盾的结论。
下面假设当前命名空间已有名为 dnsutils 的测试 Pod;<CLUSTER_DOMAIN> 应替换为集群实际域名,常见值是 cluster.local。如果发行版修改了 DNS Service 名称或 CoreDNS 标签,也应替换为集群中的真实值。
NS='<NAMESPACE>'
SVC='orders'
TEST_POD='dnsutils'
CLUSTER_DOMAIN='<CLUSTER_DOMAIN>'
DNS_SVC='kube-dns'
DNS_LABEL='k8s-app=kube-dns'

DNS_IP=$(kubectl -n kube-system get svc "$DNS_SVC" -o jsonpath='{.spec.clusterIP}')
FQDN="${SVC}.${NS}.svc.${CLUSTER_DOMAIN}"

printf 'dnsPolicy: '
kubectl -n "$NS" get pod "$TEST_POD" -o jsonpath='{.spec.dnsPolicy}'; echo
kubectl exec -n "$NS" "$TEST_POD" -- cat /etc/resolv.conf
kubectl exec -n "$NS" "$TEST_POD" -- nslookup "$FQDN" "$DNS_IP"

kubectl -n kube-system get svc "$DNS_SVC"
kubectl -n kube-system get endpointslice   -l "kubernetes.io/service-name=${DNS_SVC}"
kubectl -n kube-system get pods -l "$DNS_LABEL" -o wide
kubectl -n kube-system logs -l "$DNS_LABEL" --tail=100

kubectl -n "$NS" get svc "$SVC" -o wide
kubectl -n "$NS" get endpointslice   -l "kubernetes.io/service-name=${SVC}"
预期结果(只列关键特征,实际列格式与日志内容可能不同)
dnsPolicy: ClusterFirst
search <NAMESPACE>.svc.<CLUSTER_DOMAIN> svc.<CLUSTER_DOMAIN> <CLUSTER_DOMAIN>
nameserver <CLUSTER_DNS_IP>

Server:  <CLUSTER_DNS_IP>
Name:    orders.<NAMESPACE>.svc.<CLUSTER_DOMAIN>
Address: <SERVICE_IP>

kube-dns   ClusterIP   <CLUSTER_DNS_IP>   53/UDP,53/TCP
<DNS_ENDPOINTSLICE>   IPv4   <COREDNS_POD_IPS>
coredns-<ID>   1/1   Running   <POD_IP>

orders   ClusterIP   <SERVICE_IP>   <PORT>/TCP
<SERVICE_ENDPOINTSLICE_ROW_OR_NONE>
这里最重要的不是输出长什么样,而是四类证据能否同时成立:Pod 知道应向哪个 DNS 服务器查询、DNS Service 有可用端点、CoreDNS 实例健康、目标 Service 对象真实存在。
按请求链定位故障
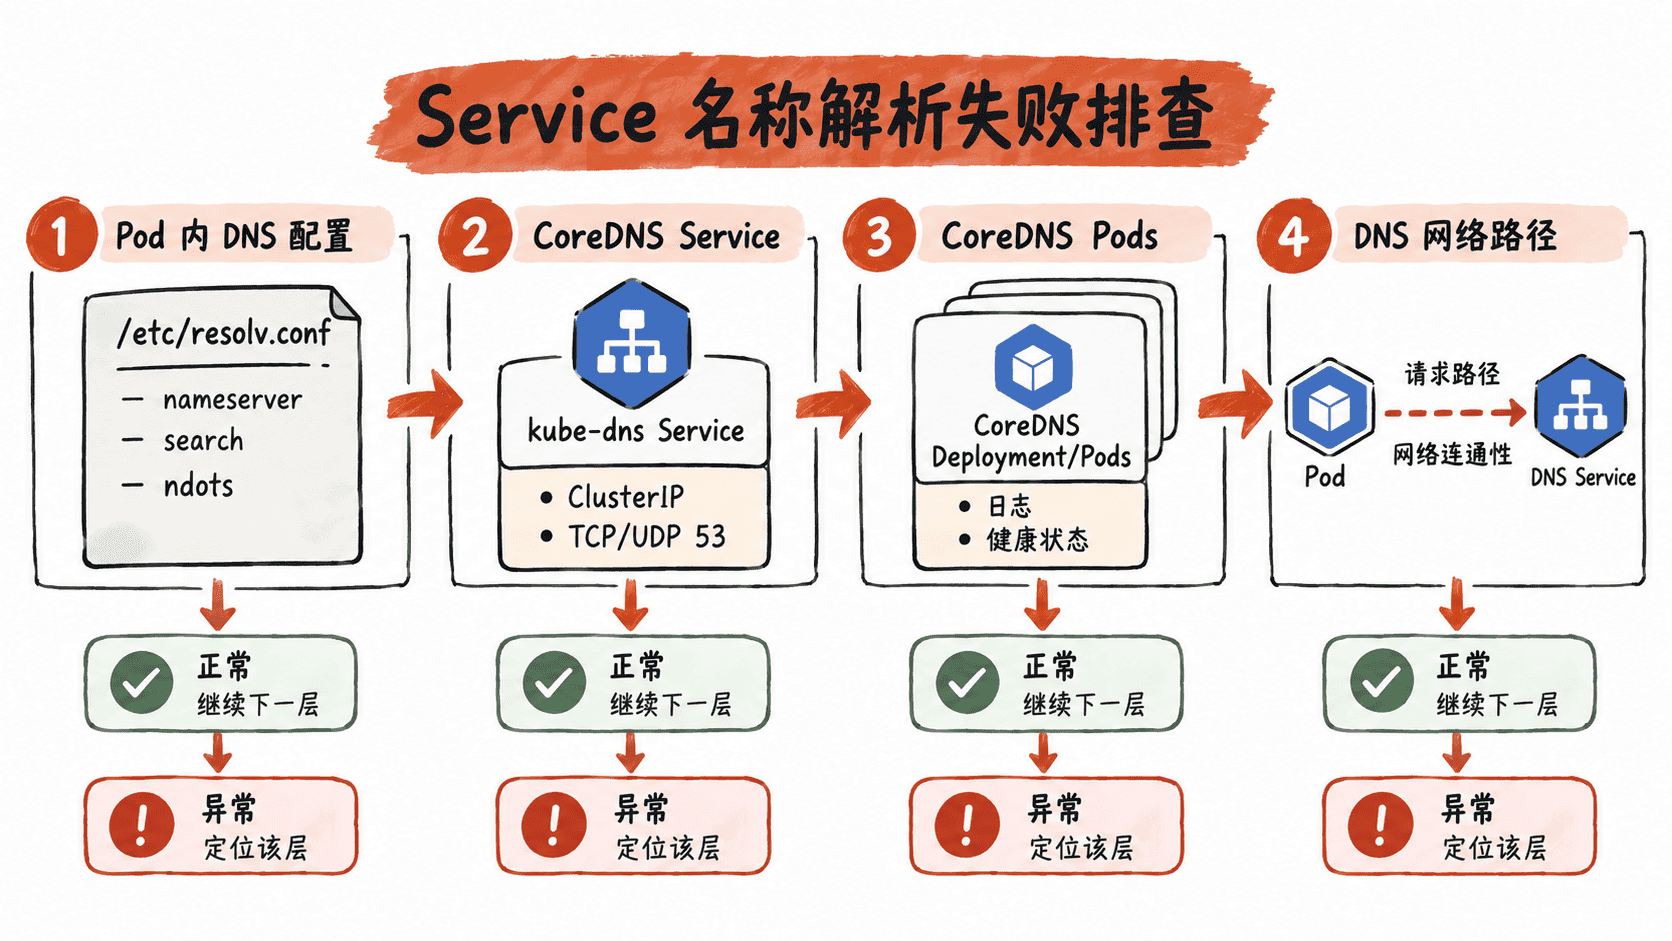
一次集群内 Service 解析可以拆成四段:Pod 解析器发出查询,请求进入集群 DNS Service,Service 数据面把流量转发到 CoreDNS,CoreDNS 再根据 Kubernetes API 中的对象生成记录。排障的目标不是“证明 CoreDNS 有问题”,而是确认请求在哪一段失去预期行为。
如果查询直接超时,应先验证 DNS Service 是否有 EndpointSlice,以及测试 Pod 到这些 DNS 端点的 UDP/TCP 53 路径是否可达。NetworkPolicy、CNI 或 Service 数据面异常都可能让 CoreDNS 本身健康却收不到请求。
如果收到 SERVFAIL,说明 DNS 请求已经得到服务器响应,但服务器无法完成解析,应结合 CoreDNS 日志检查插件初始化、Kubernetes API 访问、权限或内部错误。若返回 NXDOMAIN,则优先核对目标 Service 是否存在、命名空间是否正确,以及查询名称是否对应当前集群域名。
区分 DNS 记录与后端端点
普通 ClusterIP Service 的名称通常解析到 Service 的 ClusterIP。即使业务 EndpointSlice 暂时没有可用端点,DNS 记录仍可能正常存在;此时常见现象是“名称能解析,但连接失败”。因此,业务 EndpointSlice 为空不能单独证明 DNS 解析失败。
Headless Service 的 clusterIP 为 None,DNS 结果通常直接来自可发布的后端端点地址。此时 EndpointSlice 是否存在,以及端点是否处于可发布状态,会直接影响返回记录;若配置了 publishNotReadyAddresses,未就绪端点也可能被发布。排查前必须先确认 Service 类型,再决定 EndpointSlice 是 DNS 记录证据还是仅仅是后端可用性证据。
用 CoreDNS 与 API 证据收口
CoreDNS Pod 应处于 Running 且 Ready。日志中若持续出现 SERVFAIL、Kubernetes 插件初始化失败、连接 API Server 失败或 forbidden,再继续检查 CoreDNS 使用的 ServiceAccount、ClusterRole 与绑定关系;不要在没有证据时先修改业务 Service。
修复后复用同一个测试 Pod 和同一个完整服务名再次查询,并确认 DNS Service、CoreDNS 和目标 Service 的证据链恢复一致。若直接向集群 DNS 查询已经成功,而应用仍解析失败,再回到该 Pod 自身的 dnsPolicy、dnsConfig 与 /etc/resolv.conf 检查即可;这样只保留必要的末端确认,不再重复整套名称规则排障流程。