
容器与云原生 / 系统课时
排查 DNS 间歇性失败
排查 DNS 间歇性失败
偶发 DNS 失败最难的是证明故障跟随哪一条请求路径。本文从客户端解析配置、DNS Service、EndpointSlice、CoreDNS 副本和节点路径逐层收集证据,通过成功与失败请求对比,把问题收敛到可验证的故障层,而不是直接重启 CoreDNS。
学习目标
- 能通过多次查询和多节点对比,判断故障是否跟随客户端、节点或 CoreDNS 副本。
- 能检查 Pod 的
resolv.conf、kube-dnsService、EndpointSlice 和 CoreDNS 状态。 - 能用 Service 查询与 CoreDNS Endpoint 直连结果区分客户端配置、Service 转发和单副本异常。
先确认失败是否具有稳定边界
不要因为一次 SERVFAIL 或超时就直接重启 CoreDNS。先确认失败是否集中在某些 Pod、某些节点,或只影响短名称、某一类域名。最好从不同节点上的多个工作负载执行同一查询,并记录失败时间;只有找到稳定边界,后面的证据才有方向。
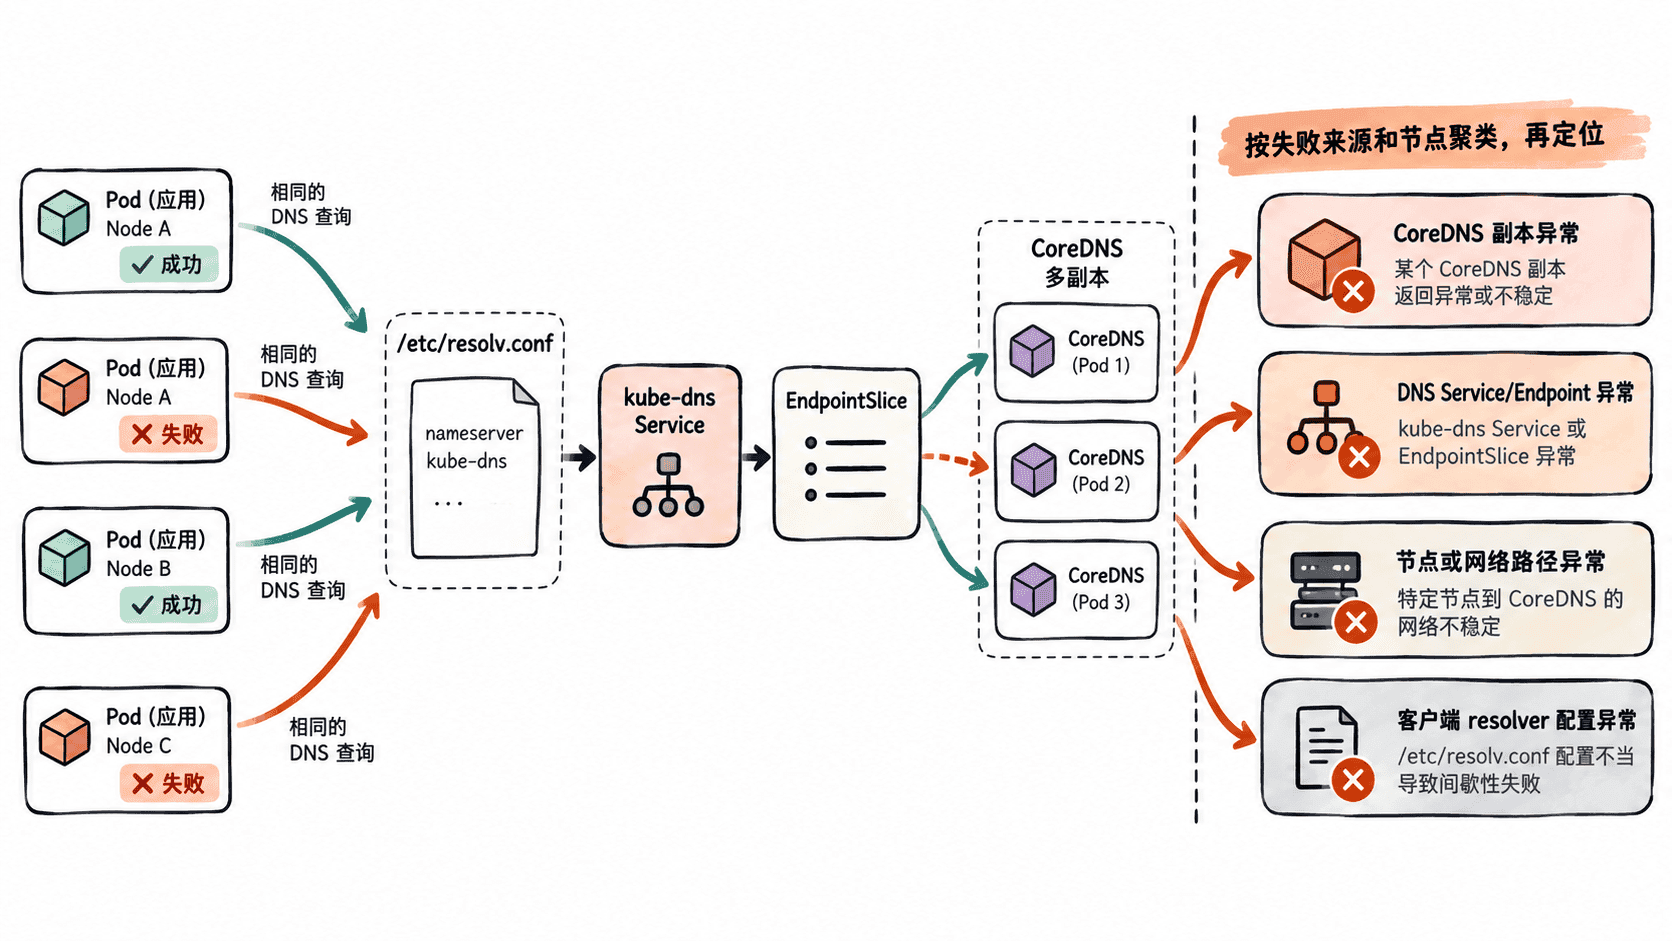
先检查测试 Pod 的本地解析配置以及集群 DNS Service。下面约定 <NAMESPACE> 表示测试 Pod 所在命名空间,<POD> 表示测试 Pod 名称,<IP> 表示环境中的实际地址。
kubectl exec -n <NAMESPACE> <POD> -- cat /etc/resolv.conf
kubectl get svc -n kube-system kube-dns
kubectl get endpointslice -n kube-system -l kubernetes.io/service-name=kube-dns -o wide
预期结果
nameserver <IP>
search <NAMESPACE>.svc.cluster.local svc.cluster.local cluster.local
options ndots:5

NAME       TYPE        CLUSTER-IP   EXTERNAL-IP   PORT(S)
kube-dns   ClusterIP   <IP>         <none>        53/UDP,53/TCP

NAME       ADDRESSTYPE   PORTS   ENDPOINTS
<NAME>     IPv4          53      <IP>,<IP>
实际搜索域和 ndots 取值可能因集群配置而不同,但 nameserver 应指向集群 DNS 地址,kube-dns Service 也应存在可用 Endpoint。若 EndpointSlice 已经没有后端,优先处理 CoreDNS Ready 状态、Service 选择器或 EndpointSlice 异常。
对比 Service 查询与副本直连
间歇性问题最有价值的证据,是失败是否稳定落在某个路径上。假设测试 Pod 已安装 nslookup,先连续查询 DNS Service;出现失败后,再从 EndpointSlice 取得 CoreDNS Pod IP,并从同一个客户端分别直连各副本。
for i in 1 2 3 4 5; do
  date
  kubectl exec -n <NAMESPACE> <POD> -- nslookup <DNS_NAME> || true
done

kubectl get endpointslice -n kube-system -l kubernetes.io/service-name=kube-dns -o wide
kubectl exec -n <NAMESPACE> <POD> -- nslookup <DNS_NAME> <COREDNS_IP_1>
kubectl exec -n <NAMESPACE> <POD> -- nslookup <DNS_NAME> <COREDNS_IP_2>
预期输出
<TIME>
Server:    <IP>
Name:      <DNS_NAME>
Address 1: <IP>

...连续查询可能全部成功,也可能出现超时或 SERVFAIL...

Server:    <COREDNS_IP_1>
Name:      <DNS_NAME>
Address 1: <IP>

Server:    <COREDNS_IP_2>
Name:      <DNS_NAME>
Address 1: <IP>
若 Service 查询失败,但直连所有 CoreDNS Endpoint 都稳定,优先调查该客户端节点到 DNS Service 的网络路径和 Service 数据面。若只有某个 CoreDNS Pod IP 的直连查询失败,则故障已经收敛到对应副本或其所在节点。若所有路径都随机失败,再继续检查上游 DNS、CoreDNS 配置和客户端行为。
检查 CoreDNS 副本与日志
Running 不代表副本一定稳定。重点检查 Ready 状态、重启次数、所在节点以及 EndpointSlice 是否仍把异常副本作为可用后端。发生失败后,应按具体 Pod 查看日志,避免把所有副本日志混在一起而失去时间与副本的对应关系。
kubectl get pods -n kube-system -l k8s-app=kube-dns -o wide
kubectl describe pod -n kube-system <COREDNS_POD>
kubectl logs -n kube-system <COREDNS_POD> --tail=100
kubectl get endpointslice -n kube-system -l kubernetes.io/service-name=kube-dns -o wide
预期结果
NAME            READY   STATUS    RESTARTS   NODE
<COREDNS_POD>   1/1     Running   0          <NODE>

...describe 输出应显示 Pod Ready,且重启次数没有持续增加...

<COREDNS_LOG_LINES>

NAME       ADDRESSTYPE   PORTS   ENDPOINTS
<NAME>     IPv4          53      <IP>,<IP>
<COREDNS_LOG_LINES> 的实际内容取决于 CoreDNS 配置;如果没有启用查询日志,不一定能看到每一次 DNS 请求。若某个副本频繁重启、Ready 抖动或其节点异常,应优先处理该副本或节点;若副本都稳定,再把重点转回客户端与节点路径。
排除客户端解析配置差异
Pod 内 /etc/resolv.conf 决定查询发送到哪个 DNS 服务器,也影响短名称如何按 search domain 展开。出现完整域名稳定而短名称失败时,应比较成功 Pod 与失败 Pod 的 resolv.conf,再检查应用是否缓存失败结果、自定义 DNS 配置或使用了不同的解析库。
如果失败只跟随某类应用,而同节点上的其他测试 Pod 查询正常,问题更可能位于应用或容器配置;如果失败跟随节点,则优先检查节点网络和 Service 数据面;如果失败稳定跟随某个 CoreDNS Endpoint,才把根因收敛到对应副本。间歇性 DNS 排障的关键,是用对照实验明确故障究竟跟随客户端、节点、Service 路径还是 CoreDNS 副本。