
容器与云原生 / 系统课时
排查只有部分 Pod 访问失败
排查只有部分 Pod 访问失败
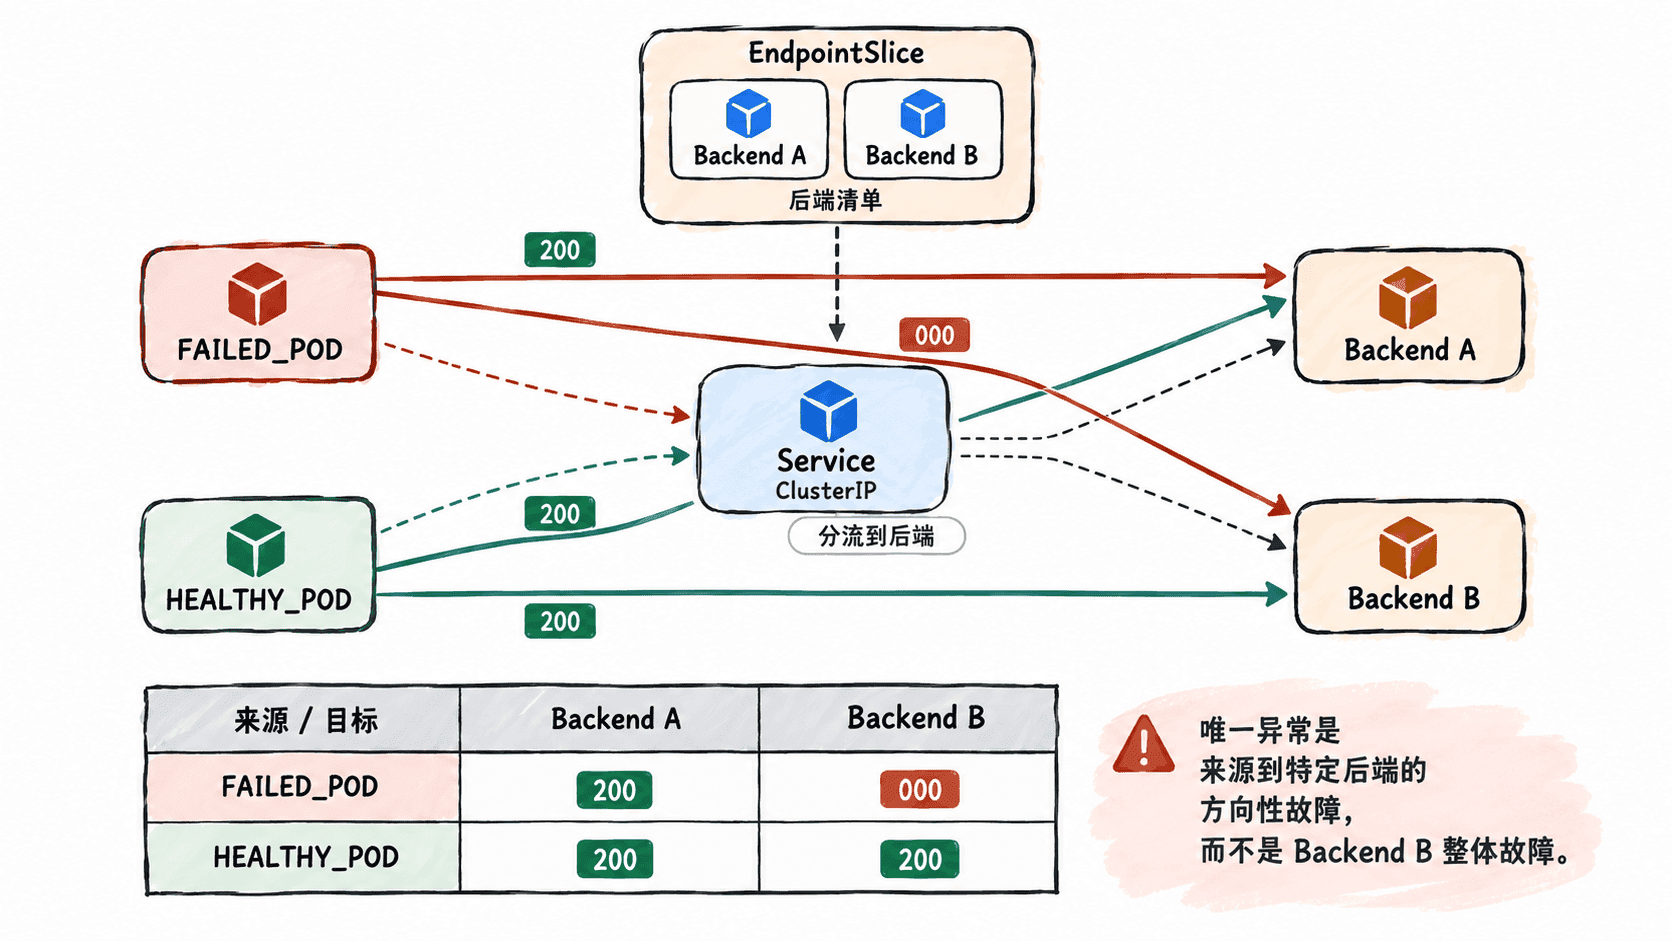
当同一个 Service 只对部分客户端 Pod 失败时,最有效的线索不是“它们在哪个节点”,而是失败是否稳定跟随某个来源、某个 Endpoint,或某一对来源与目标。用“来源 × 目标”的连接矩阵固定方向,可以避免把局部路径故障误判成 Service 整体异常。
学习目标
- 区分来源侧、后端侧、特定来源到后端方向和 Service 数据面四类局部故障。
- 用 EndpointSlice 固定实际后端,再对同一组 Pod IP 做交叉验证。
- 复用同一连接矩阵验证修复结果,而不是只看 Pod 是否恢复为
Running。
先把“部分失败”定义成方向
“部分 Pod 失败”本身不能直接说明是节点问题。更有诊断价值的是失败如何分布:某个客户端访问所有后端都失败,故障更像跟随来源;所有客户端都访问同一个后端失败,故障更像跟随后端;只有某个来源访问某个后端失败,则应优先怀疑这对源到目标之间的策略或网络路径。
Service 还会引入负载均衡。只反复请求 ClusterIP,失败可能被不同 Endpoint 的命中结果混在一起,因此必须把“经 Service 访问”和“直连固定 Pod IP”放到同一轮测试中比较。直连 Pod IP 会绕过 Service 的转发选择,但仍然经过 Pod 网络路径,这正好能把 Service 数据面和源到目标网络问题拆开。
用一个连接矩阵固定故障面
下面的主示例同时读取 EndpointSlice、固定两个客户端和两个后端,并比较直连后端与访问 ClusterIP 的结果。示例假设两个客户端容器中都有 curl;<SERVICE_PORT> 是 Service 端口,<BACKEND_PORT> 是 EndpointSlice 中实际后端端口,两者不要在未确认时视为相同。
SERVICE_NAME=<SERVICE_NAME>
SERVICE_PORT=<SERVICE_PORT>
BACKEND_PORT=<BACKEND_PORT>
FAILED_POD=<FAILED_POD>
HEALTHY_POD=<HEALTHY_POD>
BACKEND_A_IP=<BACKEND_A_IP>
BACKEND_B_IP=<BACKEND_B_IP>

SERVICE_IP="$(kubectl get svc "$SERVICE_NAME" -o jsonpath='{.spec.clusterIP}')"

echo "== EndpointSlice backends =="
kubectl get endpointslice   -l "kubernetes.io/service-name=$SERVICE_NAME"   -o jsonpath='{range .items[*]}slice={.metadata.name}{" port="}{.ports[0].port}{"
"}{range .endpoints[*]}{.addresses[0]}{"	"}{.nodeName}{"	"}{.conditions.ready}{"
"}{end}{end}'

probe() {
  pod="$1"
  host="$2"
  port="$3"
  code="$(kubectl exec "$pod" -- curl --connect-timeout 3 -sS -o /dev/null -w '%{http_code}' "http://$host:$port/health" 2>/dev/null || true)"
  [ -n "$code" ] || code=000
  printf '%s
' "$code"
}

echo "== direct matrix =="
printf 'failed->backend-a  '; probe "$FAILED_POD" "$BACKEND_A_IP" "$BACKEND_PORT"
printf 'failed->backend-b  '; probe "$FAILED_POD" "$BACKEND_B_IP" "$BACKEND_PORT"
printf 'healthy->backend-a '; probe "$HEALTHY_POD" "$BACKEND_A_IP" "$BACKEND_PORT"
printf 'healthy->backend-b '; probe "$HEALTHY_POD" "$BACKEND_B_IP" "$BACKEND_PORT"

echo "== failed client -> Service =="
for i in 1 2 3 4 5 6; do
  probe "$FAILED_POD" "$SERVICE_IP" "$SERVICE_PORT"
done
预期结果(示例故障下)
== EndpointSlice backends ==
slice=<SLICE_NAME> port=<BACKEND_PORT>
<BACKEND_A_IP>    <BACKEND_A_NODE>    true
<BACKEND_B_IP>    <BACKEND_B_NODE>    true
== direct matrix ==
failed->backend-a  200
failed->backend-b  000
healthy->backend-a 200
healthy->backend-b 200
== failed client -> Service ==
200
000
200
200
000
200
000 表示 curl 没有得到 HTTP 响应;Service 六次请求的成功与失败顺序会随负载均衡而变化。这里两个 Endpoint 都处于就绪状态,而且健康客户端可以访问 Backend B,因此不能把 Backend B 判为整体故障。真正稳定的异常是 <FAILED_POD> -> <BACKEND_B_IP>,应继续检查这一对来源与目标之间的策略和网络路径。
按矩阵结果选择下一层
| 稳定观察结果 | 更可能的故障面 |
|---|---|
| 某个来源直连多个就绪后端都失败,其他来源正常 | 来源 Pod 的 NetworkPolicy、来源节点 CNI、路由或数据面 |
| 多个来源直连同一个后端都失败 | 后端进程、监听端口、Pod 状态或后端所在节点 |
| 只有“某来源 → 某后端”失败 | 这对源到目标之间的 NetworkPolicy、跨节点路由、CNI、MTU 或路径异常 |
| 所有固定后端都能直连,但访问 ClusterIP 失败 | kube-proxy 或替代 Service 数据面的转发规则 |
| ClusterIP 成败交替,矩阵同时显示某个固定方向失败 | 先处理矩阵指出的后端或路径,不要反复修改 Service selector |
EndpointSlice 在这里主要承担“真实后端清单”的作用,而不是被当作网络路径中的一跳。conditions.ready=false 的 Endpoint 不应按普通就绪后端参与这组对照;字段为空也不能直接解释成 false,还要结合 Pod readiness、终止状态和 Service 配置判断。这样可以避免把控制面状态与数据面连通性混成一个结论。
修复后复用同一矩阵闭环
修复策略、CNI、路由、MTU 或 Service 数据面后,直接重新执行同一段脚本。闭环标准不是“Pod 又是 Running”,而是原先失败的固定方向恢复为 200,两个客户端对预期就绪后端的直连结果一致,并且连续访问 ClusterIP 不再出现与该方向相关的失败。
最终结论应落到“哪个来源、哪个目标、哪条方向”或“只有 Service 转发层异常”。只有先用矩阵把故障面固定下来,再去看相关节点和策略,才能避免把“部分 Pod 失败”重复简化成“某节点有问题”。