
容器与云原生 / 系统课时
构造节点局部访问故障
构造节点局部访问故障
本课构造一个只影响单个 Linux 节点访问指定 ClusterIP 的可回滚故障,并用 Pod IP、Service VIP、EndpointSlice 与节点代理状态做对照。目标是得到一条可解释、可恢复的证据链,而不是靠重启组件碰运气。
学习目标
- 能用两个节点的对照结果识别节点局部故障域。
- 能用 Pod IP、ClusterIP 与 EndpointSlice 区分后端问题和 Service 转发问题。
- 能安全注入并回滚一条只影响实验 Service 的节点本地网络规则。
准备可对比的 Service 基线
实验至少需要两个 Ready 的 Linux 节点。先创建两个 HTTP 后端和一个 ClusterIP Service。Deployment 的 selector.matchLabels 必须与 Pod 标签一致,否则工作负载本身就无法建立正确的副本集合。
将下面内容保存为 node-fault-demo.yaml:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: node-fault-demo
spec:
  replicas: 2
  selector:
    matchLabels:
      app: node-fault-demo
  template:
    metadata:
      labels:
        app: node-fault-demo
    spec:
      containers:
        - name: app
          image: registry.k8s.io/e2e-test-images/agnhost:2.40
          args:
            - serve-hostname
            - --port=8080
          ports:
            - containerPort: 8080
---
apiVersion: v1
kind: Service
metadata:
  name: node-fault-demo
spec:
  selector:
    app: node-fault-demo
  ports:
    - port: 80
      targetPort: 8080
这里的 selector.matchLabels 与模板标签都使用 app: node-fault-demo,Service 再通过同一标签选择后端。targetPort: 8080 指向容器实际监听端口,前端仍通过 Service 的 80 端口访问。
执行创建与控制面检查:
# 创建资源并等待两个副本就绪。
kubectl apply -f node-fault-demo.yaml
kubectl rollout status deployment/node-fault-demo --timeout=120s
kubectl get pod -l app=node-fault-demo -o wide
kubectl get service node-fault-demo
kubectl get endpointslice -l kubernetes.io/service-name=node-fault-demo
预期结果
deployment.apps/node-fault-demo created
service/node-fault-demo created
deployment "node-fault-demo" successfully rolled out
NAME                               READY   STATUS    IP           NODE
node-fault-demo-<ID>               1/1     Running   <POD_IP_1>   <NODE_X>
node-fault-demo-<ID>               1/1     Running   <POD_IP_2>   <NODE_Y>
NAME              TYPE        CLUSTER-IP     EXTERNAL-IP   PORT(S)
node-fault-demo   ClusterIP   <SERVICE_IP>   <none>        80/TCP
NAME                    ADDRESSTYPE   PORTS   ENDPOINTS
node-fault-demo-<ID> IPv4 8080 <POD_IP_1>,<POD_IP_2><ID>、<POD_IP_*>、<NODE_*> 与 <SERVICE_IP> 会随环境变化。EndpointSlice 中的端口应对应后端目标端口 8080,不是 Service 前端端口 80。
先证明两个节点都正常
选择两个 Ready 节点,并取得一个后端 Pod IP 与 Service ClusterIP。把 <NODE_A>、<NODE_B> 替换为实际节点名。
NODE_A="<NODE_A>"
NODE_B="<NODE_B>"
SERVICE_IP="$(kubectl get service node-fault-demo -o jsonpath='{.spec.clusterIP}')"
POD_IP="$(kubectl get pod -l app=node-fault-demo -o jsonpath='{.items[0].status.podIP}')"
printf 'SERVICE_IP=%s\nPOD_IP=%s\n' "$SERVICE_IP" "$POD_IP"
预期结果
SERVICE_IP=<SERVICE_IP>
POD_IP=<POD_IP>
分别进入两个节点的网络命名空间,先直连 Pod,再访问 Service。节点调试 Pod 使用宿主机网络命名空间,因此这里验证的是“节点自身访问”的路径。
# 先在 NODE_A 打开节点调试 shell。
kubectl debug node/"$NODE_A" -it --image=ghcr.io/nicolaka/netshoot:v0.16 -- bash
预期结果
Creating debugging pod node-debugger-<ID> with container debugger on node <NODE_A>.
<DEBUG_SHELL_PROMPT>
在调试 shell 中执行:
curl -fsS --connect-timeout 2 http://<POD_IP>:8080
curl -fsS --connect-timeout 2 http://<SERVICE_IP>:80
预期结果
node-fault-demo-<ID>
node-fault-demo-<ID>
退出后对 <NODE_B> 重复同样测试。只有两个节点在注入前都能直连 Pod IP 和 ClusterIP,后续“单节点失败”的证据才成立。
注入可回滚的单节点 Service 路径故障
不要通过删除 kube-proxy Pod 来“暂停”单个节点。kube-proxy 通常由 DaemonSet 管理,Pod 被删除后会立即尝试重建,这既不可控,也不能稳定表示“节点代理被暂停”。本实验改用独立 nftables 表,只在 <NODE_A> 的本机 output 路径上拒绝发往实验 ClusterIP 的 TCP/80 流量;它不修改 kube-proxy 管理的规则,删除整张实验表即可恢复。
该注入只模拟“节点自身访问这个 Service 失败”的节点局部数据面症状,不代表节点上的普通 Pod 都会失败,也不等价于 kube-proxy 崩溃。
从新的终端在 <NODE_A> 启动特权节点调试 shell:
kubectl debug node/"$NODE_A" -it --image=ghcr.io/nicolaka/netshoot:v0.16 --profile=sysadmin -- bash预期结果
Creating debugging pod node-debugger-<ID> with container debugger on node <NODE_A>.
<DEBUG_SHELL_PROMPT>
在该 shell 中安装故障规则。priority -110 让实验链在常见的目标地址转换优先级之前处理本机流量;独立表名保证可以一次性清除。
SERVICE_IP="<SERVICE_IP>"
# 先清理同名残留,再建立只匹配实验 Service 的独立规则。
nft delete table ip anystack_lab 2>/dev/null || true
nft add table ip anystack_lab
nft 'add chain ip anystack_lab output { type filter hook output priority -110; policy accept; }'
nft add rule ip anystack_lab output ip daddr "$SERVICE_IP" tcp dport 80 counter reject with tcp reset
nft list table ip anystack_lab >/dev/null && echo FAULT_RULE_INSTALLED
预期结果
FAULT_RULE_INSTALLED保持该 shell 打开并验证两层路径:
# Pod IP 应继续可达,只有指定 ClusterIP 失败。
curl -fsS --connect-timeout 2 http://<POD_IP>:8080
if curl -fsS --connect-timeout 2 http://<SERVICE_IP>:80 >/dev/null; then
  echo SERVICE_OK
else
  echo SERVICE_FAIL
fi
预期结果
node-fault-demo-<ID>
SERVICE_FAIL
此时 <NODE_A> 的 Pod IP 直连仍正常,而 ClusterIP 失败;在 <NODE_B> 重复基线测试时,ClusterIP 仍应成功。若集群使用在 netfilter 之前完成 Service 翻译的 eBPF 或 socket 级负载均衡,这条 nftables 规则可能不会命中,此时应换到与实际数据面实现匹配的实验环境,而不是把“规则未命中”误判为 Service 路径正常。
用跨节点证据定位故障域
单节点 ClusterIP 失败只能证明节点局部数据面可疑,不能直接等价为 kube-proxy 故障。真实事件中还要同时考虑 kube-proxy 或替代 Service 代理、nftables/iptables、IPVS、路由、内核连接跟踪以及 CNI 节点组件。
| 证据 | 正常节点 | 故障节点 | 结论 |
|---|---|---|---|
| Pod IP 直连 | 正常 | 正常 | 后端和基础 Pod 网络大概率健康 |
| Service ClusterIP | 正常 | 失败 | 故障收敛到节点局部 Service 路径 |
| EndpointSlice | 相同 | 相同 | 控制面看到的后端集合一致 |
| 节点本地规则或代理 | 正常 | 异常 | 继续查故障节点的数据面实现 |
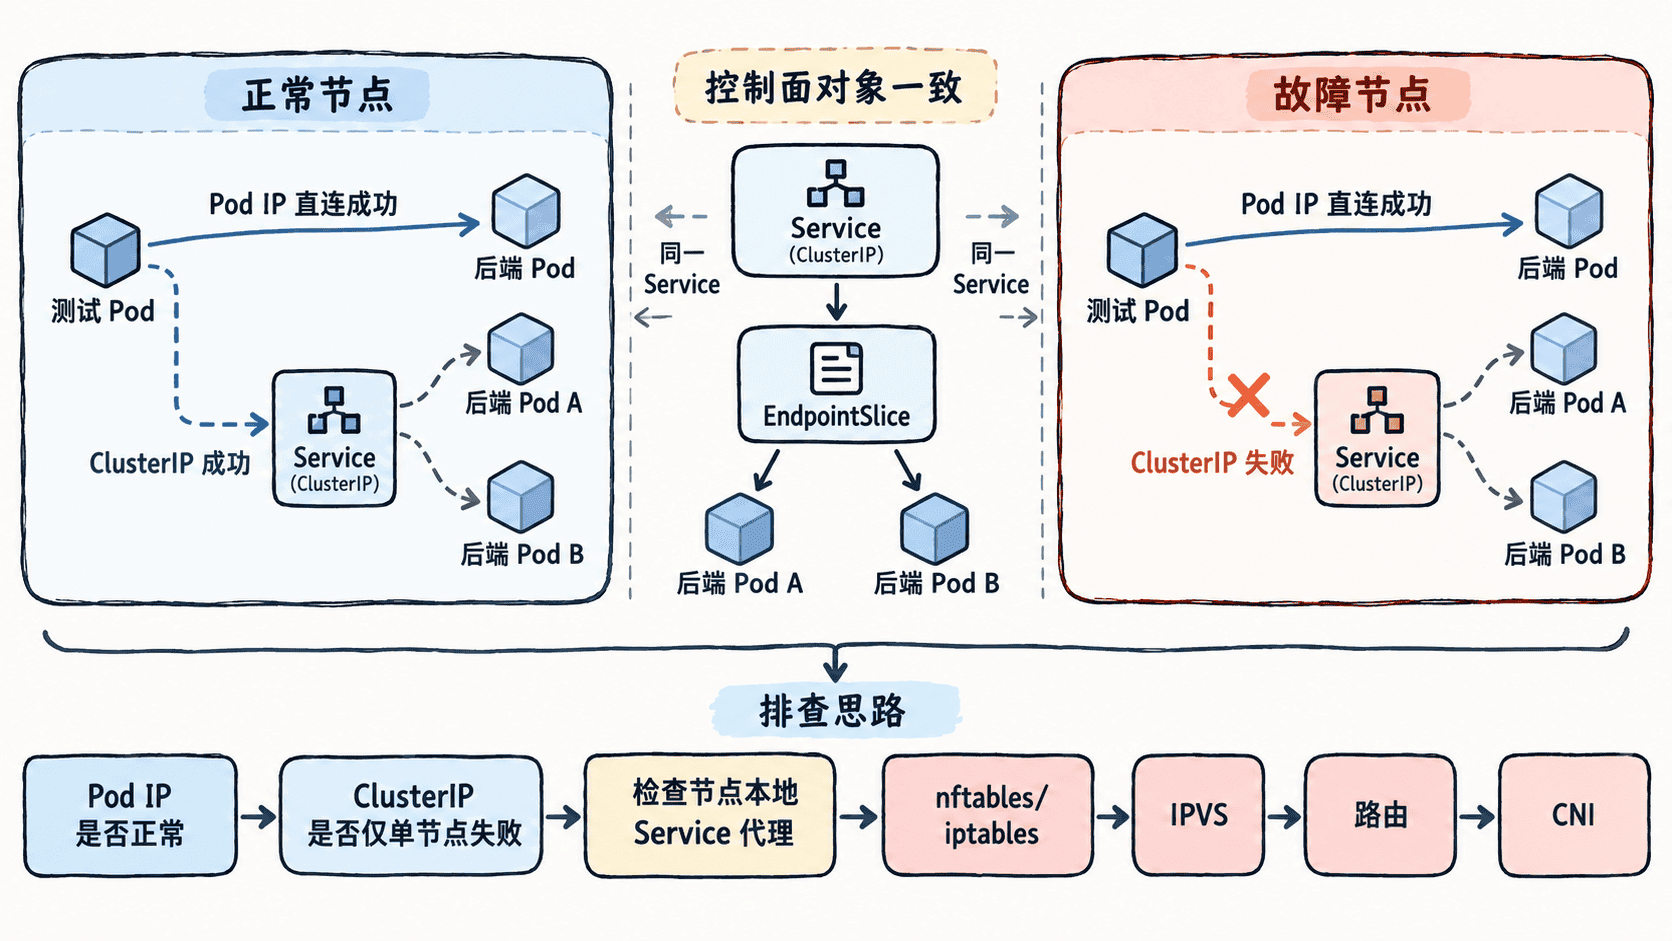
先确认实验规则只存在于故障节点,并检查计数器是否已经命中:
nft list chain ip anystack_lab output预期结果
table ip anystack_lab {
    chain output {
        type filter hook output priority -110; policy accept;
        ip daddr <SERVICE_IP> tcp dport 80 counter packets <COUNT> bytes <COUNT> reject with tcp reset
    }
}
<COUNT> 是动态值。完成一次失败的 ClusterIP 请求后,数据包计数应大于 0;这能证明故障确实由当前节点的实验规则触发。
再从控制面检查 <NODE_A> 上的 kube-proxy。如果集群使用替代 Service 代理而查不到 kube-proxy Pod,不要把“查不到”本身当成故障,应转查实际数据面组件。
# 这段命令在保留 NODE_A 变量的控制面终端执行。
kubectl -n kube-system get pod -l k8s-app=kube-proxy --field-selector spec.nodeName="$NODE_A" -o wide
KUBE_PROXY_POD="$(kubectl -n kube-system get pod -l k8s-app=kube-proxy --field-selector spec.nodeName="$NODE_A" -o name | head -n 1)"
if [ -n "$KUBE_PROXY_POD" ]; then
  kubectl -n kube-system logs "$KUBE_PROXY_POD" --tail=100
fi
预期结果
NAME                READY   STATUS    RESTARTS   NODE
kube-proxy-<ID>     1/1     Running   <VALUE>    <NODE_A>
<RECENT_KUBE_PROXY_LOG_LINES>
在本实验里,已知根因是独立的 anystack_lab 规则,所以 kube-proxy 完全可能保持 Ready 且没有异常日志。这说明定位必须依赖跨层证据,不能看到 ClusterIP 失败就直接重启代理。
恢复并重新验收
先在 <NODE_A> 的特权调试 shell 删除整张实验表,再确认规则已经不存在:
nft delete table ip anystack_lab
if nft list table ip anystack_lab >/dev/null 2>&1; then
  echo FAULT_RULE_STILL_PRESENT
else
  echo FAULT_RULE_REMOVED
fi
预期结果
FAULT_RULE_REMOVED最后从两个节点再次访问 Service ClusterIP。<SERVICE_IP> 仍替换为前面取得的实际值。
kubectl debug node/"$NODE_A" -it --image=ghcr.io/nicolaka/netshoot:v0.16 -- bash -lc 'curl -fsS --connect-timeout 2 http://<SERVICE_IP>:80'
kubectl debug node/"$NODE_B" -it --image=ghcr.io/nicolaka/netshoot:v0.16 -- bash -lc 'curl -fsS --connect-timeout 2 http://<SERVICE_IP>:80'
预期结果
node-fault-demo-<ID>
node-fault-demo-<ID>
恢复成功的标准不是“重启后看起来好了”,而是同一组证据重新一致:Pod IP 正常、EndpointSlice 未被改动、两个节点访问 ClusterIP 都恢复。真实故障也可以沿用同一原则:单节点失败先收敛到节点数据面;所有节点都失败,再扩大到 Service、EndpointSlice 与后端。