
容器与云原生 / 系统课时
从客户端现象开始采集证据
从客户端现象开始采集证据
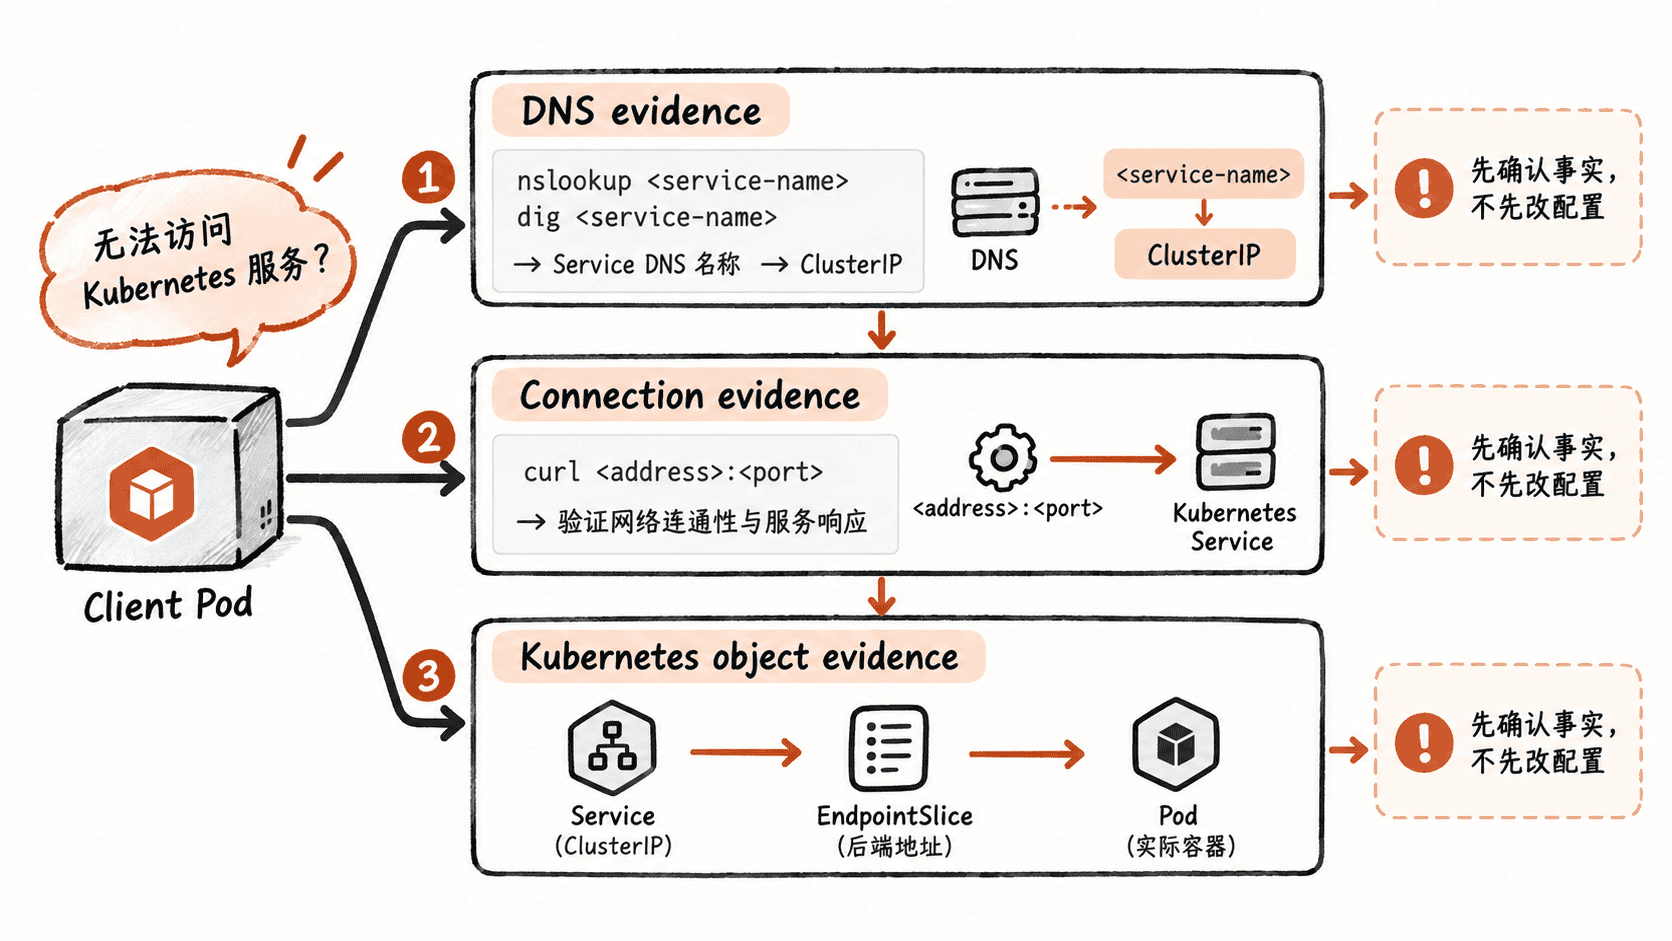
Service 或域名访问失败时,先把一次故障变成可复现的诊断产物:固定采集时间、客户端 Pod 与节点、目标 FQDN、DNS 与连接结果,再保存 Service 和 EndpointSlice 快照。这样下一步排查依据的是同一时刻的证据,而不是不断变化的现场印象。
学习目标
- 建立带时间、客户端位置和目标信息的固定证据记录格式
- 区分名称解析失败、连接失败与已进入 HTTP 层的异常
- 通过同格式诊断包比较不同 Pod、节点或时间点的差异
先固定一次故障的身份
同一个 Service 从不同 Pod、不同节点访问,结果可能不同。采集前先记录“何时、谁、从哪里、访问什么”,至少包含 UTC 时间、客户端 Pod、客户端节点、Pod IP、目标 FQDN 与端口。后续即使重复测试,也能明确是在比较两个不同时间点,还是两个不同客户端位置。
生成可复现的诊断包
下面的主示例从已经出现故障的客户端 Pod 发起探测,并创建一个独立目录。case.log 保存按时间顺序记录的探测结果,service.yaml 与 endpointslices.yaml 保存同一轮采集时的 Kubernetes 对象快照。前提是客户端容器内已有 nslookup 和 curl,本机终端可以正常使用 kubectl。
CLIENT_NAMESPACE="<CLIENT_NAMESPACE>"
CLIENT_POD="<CLIENT_POD>"
SERVICE_NAMESPACE="<NAMESPACE>"
SERVICE_NAME="<SERVICE_NAME>"
PORT="<PORT>"
FQDN="${SERVICE_NAME}.${SERVICE_NAMESPACE}.svc.cluster.local"
CASE_ID="$(date -u +%Y%m%dT%H%M%SZ)-${CLIENT_POD}"
CASE_DIR="svc-evidence-${CASE_ID}"

mkdir -p "$CASE_DIR"

{
  echo "case_id=${CASE_ID}"
  echo "captured_at=$(date -u +%Y-%m-%dT%H:%M:%SZ)"
  echo "client=${CLIENT_NAMESPACE}/${CLIENT_POD}"
  kubectl get pod "$CLIENT_POD" -n "$CLIENT_NAMESPACE"     -o custom-columns='NAME:.metadata.name,IP:.status.podIP,NODE:.spec.nodeName,PHASE:.status.phase'     --no-headers
  echo "target=${FQDN}:${PORT}"

  echo "=== DNS ==="
  kubectl exec -n "$CLIENT_NAMESPACE" "$CLIENT_POD" -- nslookup "$FQDN"
  echo "dns_exit=$?"

  echo "=== HTTP ==="
  kubectl exec -n "$CLIENT_NAMESPACE" "$CLIENT_POD" --     curl -sS --connect-timeout 3 --max-time 5 -o /dev/null     -w 'http_code=%{http_code} remote_ip=%{remote_ip} remote_port=%{remote_port} time_connect=%{time_connect}\n'     "http://${FQDN}:${PORT}/healthz"
  echo "curl_exit=$?"

  echo "=== SERVICE ==="
  kubectl get svc "$SERVICE_NAME" -n "$SERVICE_NAMESPACE"     -o jsonpath='service={.metadata.name} resourceVersion={.metadata.resourceVersion} clusterIP={.spec.clusterIP} port={.spec.ports[0].port} targetPort={.spec.ports[0].targetPort}{"\n"}'

  echo "=== ENDPOINTSLICE ==="
  kubectl get endpointslice -n "$SERVICE_NAMESPACE"     -l "kubernetes.io/service-name=${SERVICE_NAME}"     -o jsonpath='{range .items[*]}slice={.metadata.name} resourceVersion={.metadata.resourceVersion} addresses={.endpoints[*].addresses[*]} ports={.ports[*].port} ready={.endpoints[*].conditions.ready}{"\n"}{end}'
} 2>&1 | tee "$CASE_DIR/case.log"

kubectl get svc "$SERVICE_NAME" -n "$SERVICE_NAMESPACE" -o yaml   > "$CASE_DIR/service.yaml"

kubectl get endpointslice -n "$SERVICE_NAMESPACE"   -l "kubernetes.io/service-name=${SERVICE_NAME}" -o yaml   > "$CASE_DIR/endpointslices.yaml"

printf 'artifact_dir=%s\n' "$CASE_DIR"
预期结果
case_id=<TIME>-<CLIENT_POD>
captured_at=<TIME>
client=<CLIENT_NAMESPACE>/<CLIENT_POD>
<CLIENT_POD>   <POD_IP>   <NODE_NAME>   Running
target=<SERVICE_NAME>.<NAMESPACE>.svc.cluster.local:<PORT>
=== DNS ===
Name:    <SERVICE_NAME>.<NAMESPACE>.svc.cluster.local
Address: <CLUSTER_IP>
dns_exit=0
=== HTTP ===
http_code=200 remote_ip=<CLUSTER_IP> remote_port=<PORT> time_connect=<SECONDS>
curl_exit=0
=== SERVICE ===
service=<SERVICE_NAME> resourceVersion=<ID> clusterIP=<CLUSTER_IP> port=<PORT> targetPort=<TARGET_PORT>
=== ENDPOINTSLICE ===
slice=<ENDPOINTSLICE_NAME> resourceVersion=<ID> addresses=<BACKEND_POD_IP> ports=<TARGET_PORT> ready=true
artifact_dir=svc-evidence-<TIME>-<CLIENT_POD><TIME>、<PORT>、<ID>、<POD_IP> 等实际值会随环境变化,nslookup 的排版也可能因镜像内工具不同而不同。成功记录中,DNS 返回的 ClusterIP 应与 Service 快照一致,EndpointSlice 应包含后端地址;失败记录则保留对应命令的错误文本和退出码,不需要为了“得到完整输出”而修改现场后重跑。
按时间线定位最后一个成功事实
不要只摘录最后一条报错。case.log 的价值在于保留同一轮采集的顺序:先确认客户端位置,再看 DNS,再看连接,最后对照对象快照。排查时只需要找出“最后一个成功事实”,就能把故障边界压缩到下一层。
| 证据时间线 | 当前故障边界 | 下一步重点 |
|---|---|---|
dns_exit 非 0,或 curl_exit=6 |
名称解析 | 名称、命名空间、Pod DNS 配置、CoreDNS 路径 |
DNS 返回正确 ClusterIP,但 curl_exit=7 或 28 |
TCP 连接或 Service 转发 | Service 端口、EndpointSlice、目标端口、Pod 监听、节点网络 |
curl_exit=0 且收到非 000 HTTP 状态码 |
HTTP 已到达服务链路 | 请求路径、Host、鉴权、健康检查与应用日志 |
curl_exit=7 表示连接未建立,28 表示操作超时;两者都不能单独证明根因位于 kube-proxy、CNI 或后端 Pod,因此必须与同一诊断包中的 Service、EndpointSlice 和客户端节点信息一起判断。
用同一格式做横向比较
如果怀疑故障与节点相关,应从另一个客户端 Pod 再生成一份新的诊断目录,而不是临时换一套命令。比较两个 case.log 的 captured_at、节点、ClusterIP、退出码和连接目标,再对照对应的 YAML 快照。只有某个节点失败时,范围可以收缩到该节点及其网络路径;所有客户端在同一时间段都失败时,再优先检查共享的 Service、EndpointSlice 或 DNS 配置。
这种固定格式的诊断包把“访问不了”拆成可交接的事实:一次采集对应一个时间点、一个客户端位置和一组对象版本。后续无论继续排查还是交给其他同事,都能基于同一份证据复现当时的判断,而不是重新描述现场。