
容器与云原生 / 系统课时
排查 Service 无法访问
排查 Service 无法访问
Service 无法访问时,按 Service → EndpointSlice → Pod 监听 → 集群内请求 → 节点数据面的顺序检查,能最快把问题收敛到对象关联、端口监听或网络转发。每一步都先拿到可验证证据,再决定是否继续下钻,避免一开始就陷入节点级命令。
学习目标
- 能按 Service、EndpointSlice、Pod 与数据面逐层定位访问失败
- 能区分 selector 不匹配、后端未就绪、监听地址错误和 Service 转发异常
- 能用
kubectl与curl在修复后完成同路径验收
先确认 Service 与 EndpointSlice
先检查 Service 的类型、ClusterIP、port、targetPort 和 selector,再核对 EndpointSlice 是否包含预期 Pod。对于普通 selector 型 Service,selector 选错对象、后端端口映射错误,都会直接破坏 Service 与工作负载之间的关系。
kubectl get svc <SERVICE_NAME> -n <NAMESPACE> -o yaml
kubectl get pods -n <NAMESPACE> -l app=<APP> -o wide
kubectl get endpointslice -n <NAMESPACE> -l kubernetes.io/service-name=<SERVICE_NAME> -o yaml
预期结果
spec:
  clusterIP: <CLUSTER_IP>
  ports:
  - port: <PORT>
    targetPort: <TARGET_PORT>
  selector:
    app: <APP>

NAME         READY   STATUS    IP
<POD_NAME>   1/1     Running   <POD_IP>

endpoints:
- addresses:
  - <POD_IP>
  conditions:
    ready: true
ports:
- port: <TARGET_PORT><CLUSTER_IP>、<POD_IP>、<PORT> 等实际值会随环境变化。重点是三件事:selector 能选中预期 Pod,EndpointSlice 中有对应地址,EndpointSlice 端口与应用监听端口一致。Pod 未 Ready 时,EndpointSlice 仍可能保留该地址但标记 ready: false;除非显式使用 publishNotReadyAddresses,否则这类后端通常不会接收 Service 流量。
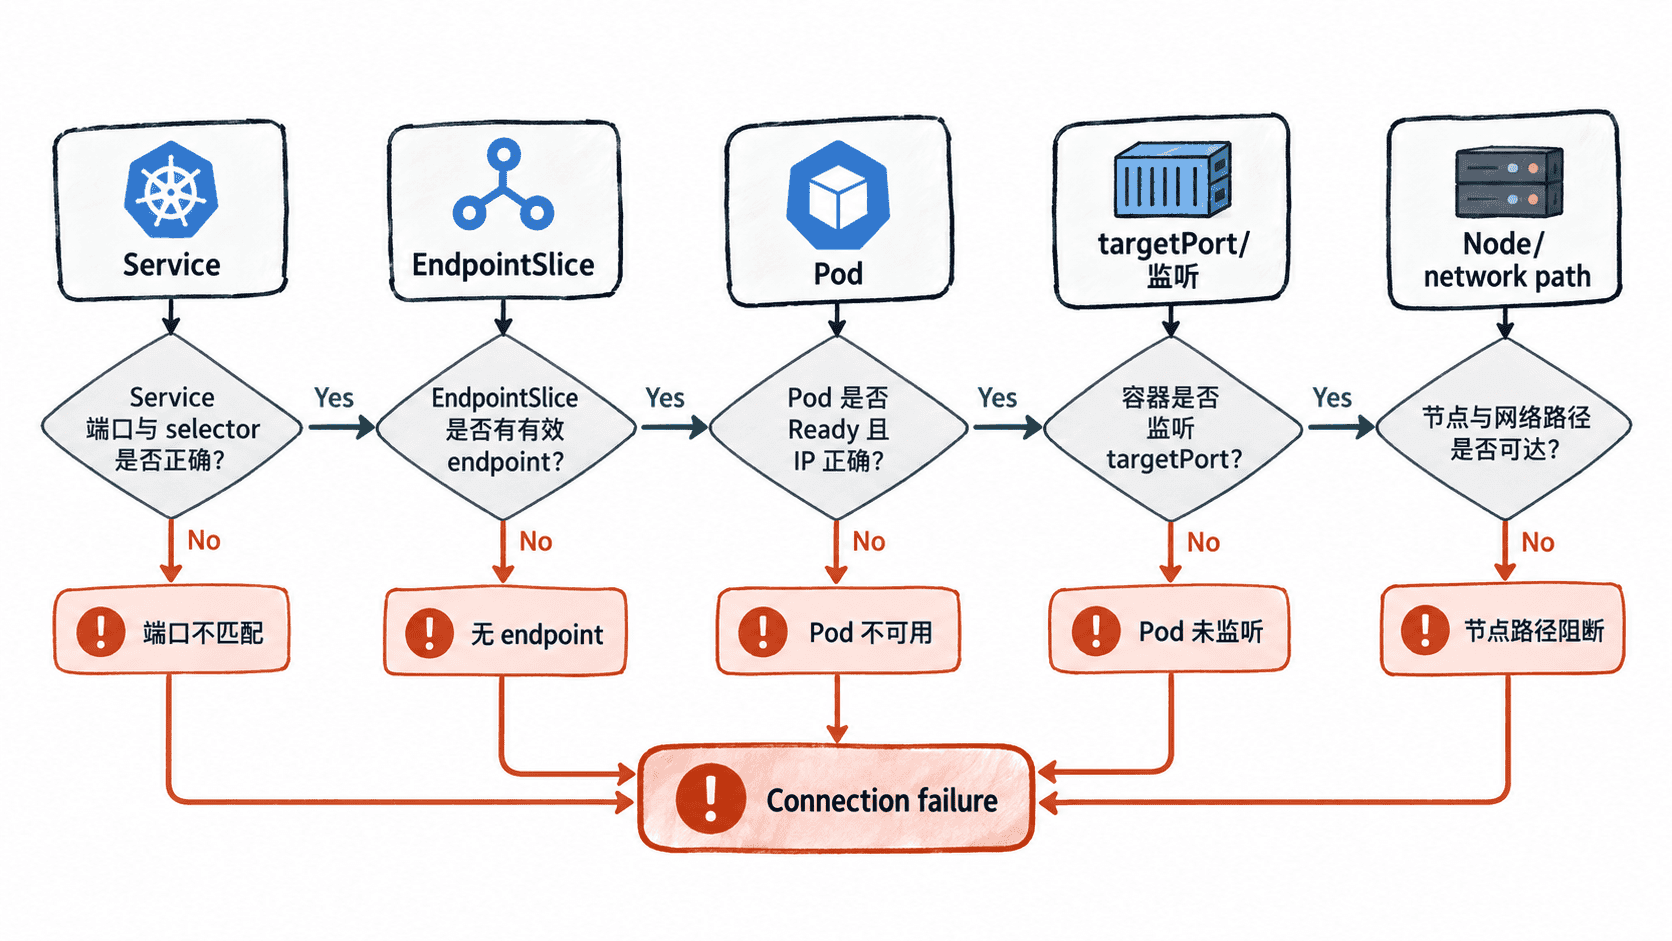
确认 Pod 真的在目标地址和端口监听
EndpointSlice 有 Pod IP,只能说明控制面发现了后端,不能证明容器进程真的对其他 Pod 开放端口。若应用只监听 127.0.0.1,容器内本地访问可能成功,但来自 Service 或其他 Pod 的连接仍会失败。
kubectl exec -n <NAMESPACE> <POD_NAME> -- sh -c 'ss -lnt || netstat -lnt'
kubectl exec -n <NAMESPACE> <POD_NAME> -- curl -fsS --connect-timeout 2 http://127.0.0.1:<TARGET_PORT>/healthz
kubectl exec -n <NAMESPACE> <CLIENT_POD> -- curl -fsS --connect-timeout 3 http://<POD_IP>:<TARGET_PORT>/healthz
预期结果
LISTEN 0 128 0.0.0.0:<TARGET_PORT> 0.0.0.0:*
ok
ok
如果监听结果只有 127.0.0.1:<TARGET_PORT>,应把应用改为监听 Pod 可达地址,例如 0.0.0.0。如果容器镜像没有 ss、netstat 或 curl,应使用应用自带诊断命令或已批准的调试容器完成同等验证,而不是据此判断网络正常。
从真实客户端验证 Service 路径
确认 Pod IP 可以从客户端访问后,再通过 Service DNS 名发起同样请求。不要用“直连 Pod IP 成功”代替 Service 验证,因为直连绕过了 ClusterIP 和 Service 数据面,只能证明后端与 Pod 网络可达。
kubectl exec -n <NAMESPACE> <CLIENT_POD> -- curl -v --connect-timeout 3 http://<SERVICE_NAME>.<NAMESPACE>.svc.cluster.local:<PORT>/healthz预期输出
* Connected to <SERVICE_NAME>.<NAMESPACE>.svc.cluster.local (<CLUSTER_IP>) port <PORT>
< HTTP/1.1 200 OK

ok
如果 DNS 不能解析,先处理 DNS 或命名空间问题;如果能解析出 ClusterIP,但连接超时或被拒绝,就重新核对 Service port、targetPort、EndpointSlice 端口和 Pod 实际监听端口。只有这些事实一致后,节点级排查才有意义。
最后检查节点与 Service 数据面
当 Service、EndpointSlice、Pod 监听和 Pod IP 直连都正确,而 ClusterIP 仍失败时,再检查客户端与后端所在节点以及 Service 数据面组件。不同集群可能使用 kube-proxy、eBPF 数据面或发行版自带实现,因此应先识别实际实现,再选择对应的日志、规则或诊断工具。
kubectl get pod -n <NAMESPACE> <CLIENT_POD> <POD_NAME> -o wide
kubectl get nodes -o wide
kubectl get pods -n kube-system -o wide
预期结果
NAME           READY   STATUS    NODE
<CLIENT_POD>   1/1     Running   <CLIENT_NODE>
<POD_NAME>     1/1     Running   <BACKEND_NODE>

NAME             STATUS   VERSION
<CLIENT_NODE>    Ready    <VALUE>
<BACKEND_NODE>   Ready    <VALUE>

NAME              READY     STATUS    NODE
<DATAPLANE_POD>   <VALUE>   Running   <VALUE>
若只有跨节点访问失败,而同节点访问正常,应优先检查 CNI、节点路由、防火墙和数据面组件;若多个无关 Service 同时失败,则更可能是节点级转发链路故障,而不是单个 Service 配置错误。
用同一客户端完成修复验收
修复后必须回到最初失败的客户端重新请求 Service,并同时确认 DNS、连接建立和应用响应。这样可以防止“Pod 已恢复,但 Service 路径仍异常”的假修复。
kubectl exec -n <NAMESPACE> <CLIENT_POD> -- sh -c 'getent hosts <SERVICE_NAME>.<NAMESPACE>.svc.cluster.local && curl -fsS --connect-timeout 3 http://<SERVICE_NAME>.<NAMESPACE>.svc.cluster.local:<PORT>/healthz'预期结果
<CLUSTER_IP> <SERVICE_NAME>.<NAMESPACE>.svc.cluster.local
ok
只有同一客户端能够解析 Service 名称、连接 ClusterIP,并收到预期业务响应,才说明这条 Service 访问路径真正恢复。