
大数据与流处理 / 系统课时
看懂增量位点从哪里来
看懂增量位点从哪里来
CDC 能在快照结束后继续读取新增变化,关键在于它必须知道“日志读到哪里”。这个位置并不是每次启动都重新猜测:首次启动会建立初始日志位置,正常运行后由 checkpoint 保存进度,故障恢复时则优先使用已保存的状态继续读取。
学习目标
- 理解数据库变更日志位点在 CDC 中承担的职责
- 区分首次启动、checkpoint 恢复和重新启动作业时的位点来源
- 能判断为什么随意删除状态可能改变 CDC 的启动行为
位点描述的是日志读取进度
以 MySQL 为例,数据变化会进入 binary log。CDC Source 持续解析这些日志,需要保存能够标识读取进度的元数据,例如 binlog 文件名与文件内位置;使用 GTID 的环境还可能涉及 GTID 集合。具体表示形式取决于连接器、数据库配置和版本,但目的相同:确定哪些变化已经处理,以及下一次应该从哪里继续。
可以在有权限的 MySQL 8.4 环境查看当前 binary log 状态:
SHOW BINARY LOG STATUS;预期结果
File                 Position    Binlog_Do_DB    Binlog_Ignore_DB    Executed_Gtid_Set
<LOG_FILE> <POSITION> <VALUE> <VALUE> <GTID_SET><LOG_FILE>、<POSITION>、<VALUE> 和 <GTID_SET> 都是动态值,实际结果可能不同。这里的命令用于理解数据库当前日志坐标,并不意味着应该把查询结果手工填写成 Flink CDC 的恢复位点;正常恢复依赖连接器维护的状态。
首次启动需要建立快照与日志的衔接点
首次执行增量快照时,Source 不只是读取表中现有行,还必须把快照期间发生的修改与后续日志正确衔接。连接器会维护快照切片及对应日志范围所需的元数据,使快照数据和并发产生的变更最终能够形成一致的数据流。
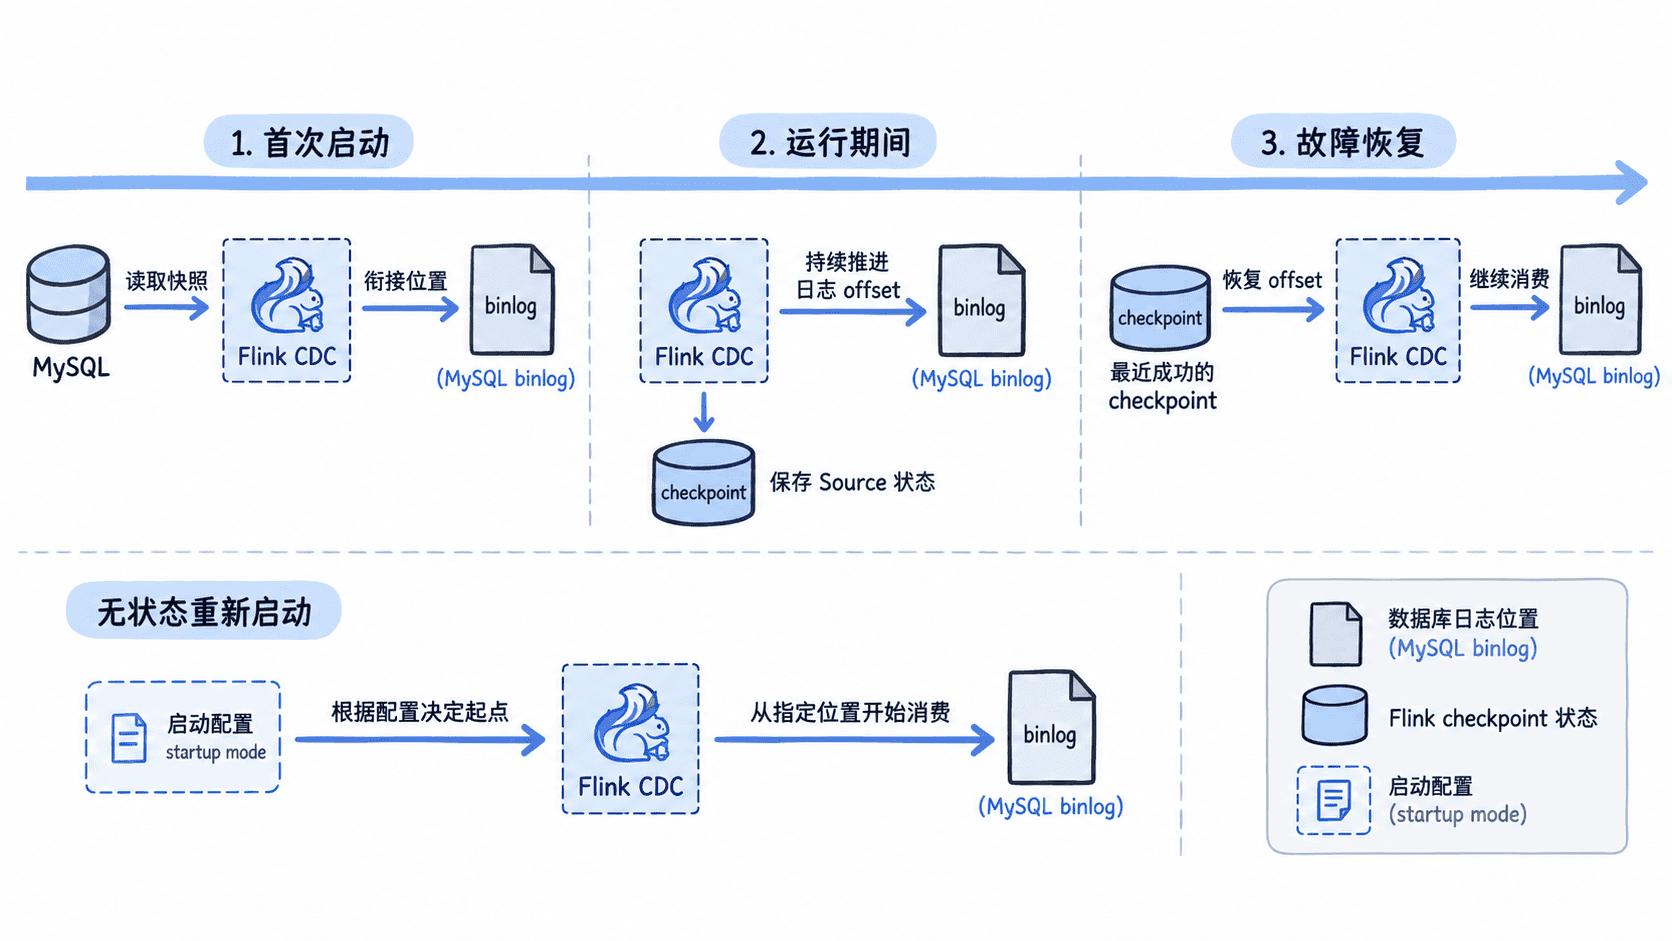
因此,“快照读完以后从当前 binlog 开始”是过度简化的理解。快照可能持续较长时间,期间数据库仍在写入;连接器必须跟踪相应日志区间,才能避免简单切换造成的遗漏或错误衔接。
checkpoint 才是运行后恢复的重要依据
作业进入持续增量读取后,Source 的日志进度属于 Flink 状态的一部分。成功 checkpoint 会保存当时可恢复的 Source 状态。发生 TaskManager 故障、作业失败等情况并从 checkpoint 恢复时,Source 使用该状态中的进度继续消费,而不是直接从数据库“此刻最新的位置”重新开始。
这也是端到端一致性依赖 checkpoint 的原因之一。故障发生前可能已经读取了比最近成功 checkpoint 更靠后的日志;恢复后再次读取其中一段属于正常现象,Flink 会把整个作业恢复到一致的 checkpoint 状态,而不是只恢复 Source 的某一个数字。
没有恢复状态时才重新执行启动策略
需要把“重启”拆成两种情况。从 checkpoint 或 savepoint 恢复时,已有 Source 状态通常决定继续读取的位置;没有携带旧状态重新提交作业时,连接器无法使用之前 checkpoint 中的进度,只能按照新作业的启动配置建立读取起点,并在需要时重新执行快照。
因此,修改 startup mode 并重新提交并不等于它一定覆盖已有恢复状态。反过来,删除 checkpoint、改变作业身份或不携带 savepoint,也不能被当成普通重启操作,因为这可能让 Source 按首次启动逻辑重新确定数据范围。
位点失效时要检查日志是否仍然存在
checkpoint 保存了位置,并不代表数据库会永久保留对应日志。如果作业停机很久,而 MySQL 已经清理恢复位置所需的旧 binlog,Source 即使知道原来的 offset,也可能无法继续读取。这类问题的根因不是“Flink 忘记位点”,而是位点指向的日志已经不可用了。
排查时应同时确认最近可用 checkpoint、作业实际采用的恢复方式,以及数据库日志保留情况。只有把这三部分放在一起,才能解释一次启动到底从哪里开始。生产环境因此需要让 binlog 保留周期覆盖预期的最长停机与恢复窗口,并持续验证 checkpoint 能够成功完成。