
大数据与流处理 / 系统课时
主键变化为什么更危险
主键变化为什么更危险
普通字段变化通常只影响一列数据,而主键决定一条变更记录代表“哪个业务对象”。在 Flink CDC 链路中修改主键,会同时影响 CDC 事件语义、Flink 的键控状态、Upsert 更新方式和下游表的唯一性约束,因此不能把它当成普通 DDL 直接在线执行。
学习目标
- 理解主键与 CDC 更新、删除事件之间的关系
- 判断新增、删除和修改主键可能破坏哪些状态与下游语义
- 掌握更安全的主键迁移思路和验证方法
主键不只是数据库约束
在增量同步链路中,主键承担的是记录身份。例如订单表以 id 为主键,下游收到同一个 id 的多次变化时,才能把它们理解为同一订单的连续更新,而不是多条互不相关的数据。
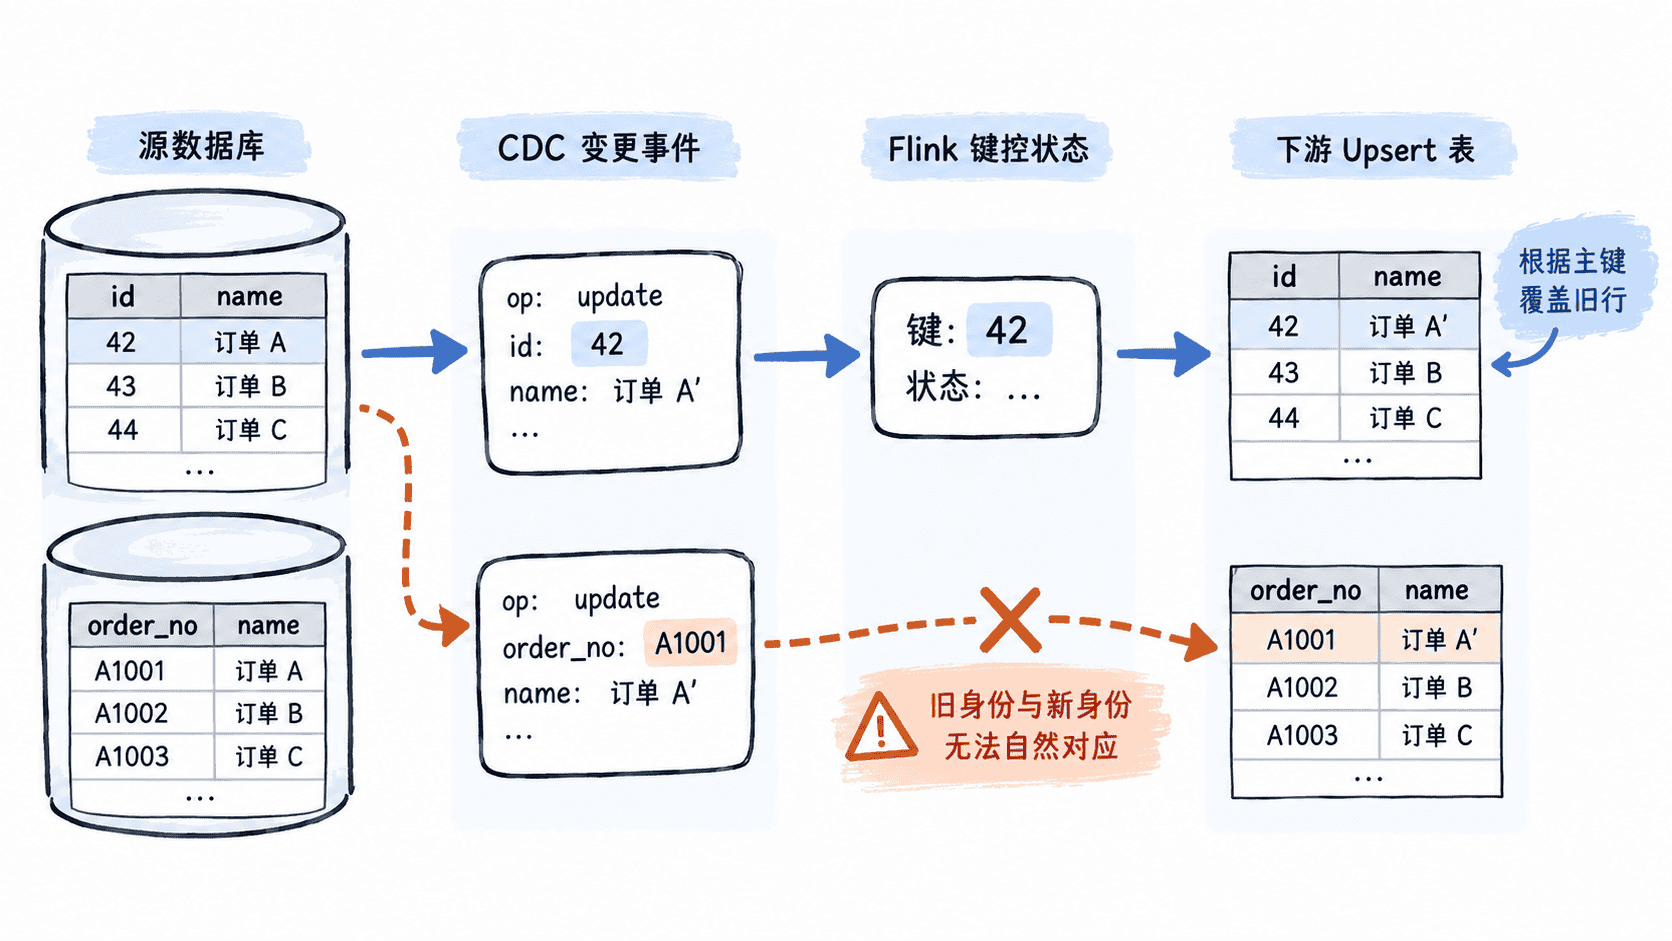
以最小表结构观察这种关系。下面的 SQL 可以在支持 MySQL 语法的测试数据库中执行:
CREATE TABLE orders (
    id BIGINT NOT NULL,
    order_no VARCHAR(32) NOT NULL,
    status VARCHAR(16) NOT NULL,
    PRIMARY KEY (id),
    UNIQUE KEY uk_order_no (order_no)
);

INSERT INTO orders (id, order_no, status)
VALUES (42, 'ORD-2026-00042', 'CREATED');

UPDATE orders SET status = 'PAID' WHERE id = 42;

SELECT id, order_no, status FROM orders WHERE id = 42;
预期输出:
42 ORD-2026-00042 PAID实际客户端的列框线和提示文字可能不同,但结果应只有一条 id=42 且状态为 PAID 的记录。CDC 系统捕获这些操作后,需要持续知道更新对应的是哪个逻辑对象。
三类主键变化分别危险在哪里
新增主键意味着原来允许重复的记录突然需要满足唯一性。历史数据若存在重复值或 NULL,DDL 本身就可能失败;即使源库成功,下游原先按追加方式写入的数据也未必能直接切换为 Upsert 模型。
删除主键会失去稳定的行身份。对于依赖主键生成更新键或删除键的同步链路,下游可能无法可靠判断应该覆盖或删除哪一行。某些连接器或目标系统还会直接要求表存在主键。
把主键从 A 改成 B最危险,因为记录身份体系发生了切换。已有状态可能以旧键组织,而新事件开始使用新键;如果迁移边界没有被明确控制,同一个业务对象就可能在状态和下游中表现成两条记录。
为什么 Upsert 和状态最容易出问题
Upsert 的核心可以概括为“相同键覆盖,不同键新增”。假设历史记录使用 id=42,迁移后改用 order_no=ORD-2026-00042。两个值虽然指向同一个订单,但对按键组织的系统而言,它们并不是天然相等的键。
Flink 的 keyed state 也具有类似约束:状态属于某个键。如果作业逻辑、表主键或分区键随 Schema 演进发生改变,旧 checkpoint 中保存的状态结构不会因为业务上“它们是同一订单”就自动完成身份映射。
因此风险不只是报错。更难发现的情况是作业继续运行,但下游出现重复行、旧行残留、删除失效或聚合结果重复计算。
更安全的迁移方式
涉及主键重构时,应优先把它当成数据模型迁移,而不是普通在线 DDL。常见做法是先引入新键并保持旧键,在源端完成回填和唯一性校验,再建立使用新键的新同步链路或新目标表。
迁移前至少验证新键是否满足唯一且非空。例如计划把 order_no 升级为主键候选时,可以先检查:
SELECT
    COUNT(*) AS total_rows,
    COUNT(order_no) AS non_null_rows,
    COUNT(DISTINCT order_no) AS distinct_rows
FROM orders;
预期结果是在迁移条件满足时,三个计数完全相等:
total_rows  non_null_rows  distinct_rows
<N>         <N>            <N>
其中 <N> 取决于实际数据量。如果三个值不相等,应先处理空值或重复值,而不是继续切换主键。
随后通过全量校验或双写观察确认新链路的数据量、唯一性以及更新和删除行为正确,再切换消费者。旧链路和旧表应保留到回滚窗口结束。这样即使新键模型出现问题,也不必尝试把运行中的状态强行解释成另一套主键语义。
主键变化真正危险的地方,是它改变了“谁是同一条记录”这一基础规则。只要同步链路已经依赖该规则维护状态或执行 Upsert,就应把主键新增、删除和替换视为需要迁移方案、数据校验与回滚路径的高风险变更。