
大数据与流处理 / 系统课时
同步多张表时怎么组织
同步多张表时怎么组织
多表 CDC 的难点通常不是把更多表接进 Flink,而是确保每条变更都能明确回答“来自哪张源表、应该进入哪个目标对象”。本课从命名、路由和目标表映射入手,设计一套可扩展的多表同步方式,并用 Flink CDC Pipeline 配置验证路由结果。
学习目标
- 能区分一对一映射、同构表汇聚和异构表转换三类场景
- 能设计不会丢失来源信息的表命名与路由规则
- 能验证多张源表最终进入了预期的目标表
先确定源表与目标表的关系
多表同步应先画清映射关系,再决定是否使用通配规则。最简单的是一对一:shop.orders 写入 dw.orders,shop.customers 写入 dw.customers。这种方式边界明确,适合表结构和业务含义不同的场景。
另一类是分库分表汇聚,例如 shop_01.orders、shop_02.orders 都表示相同的订单实体,需要汇入统一的 dw.orders。此时可以路由,但必须确认主键在所有分片之间仍然全局唯一;否则不同分片的相同主键会在目标端发生覆盖。
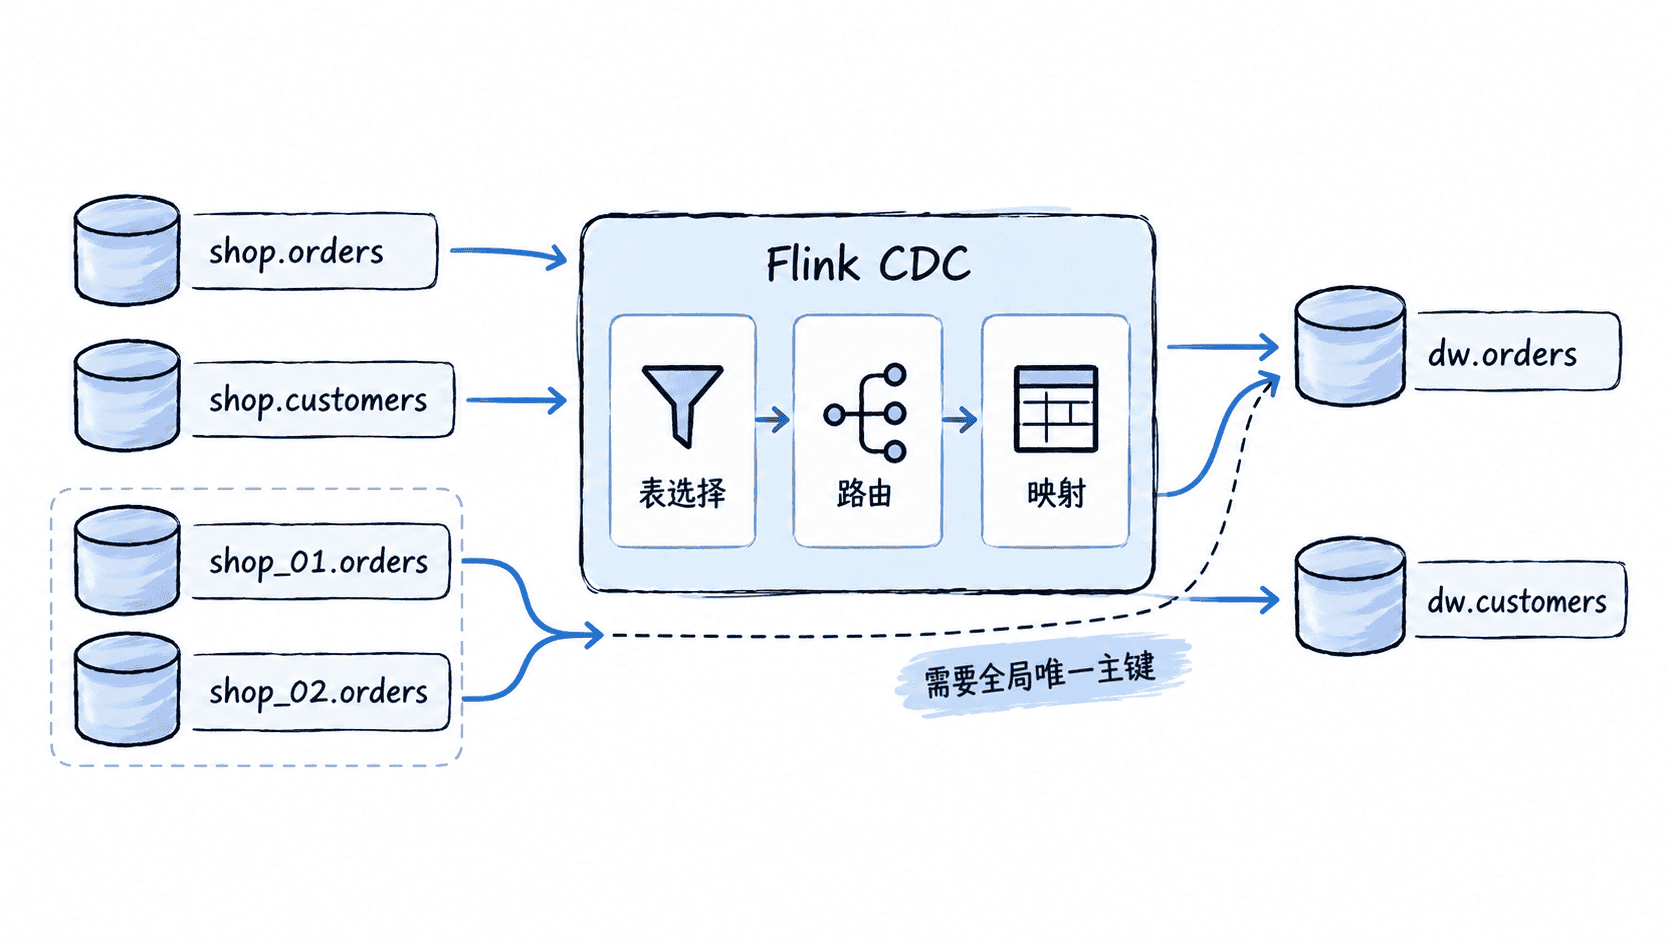
异构表不要仅因为字段名字相似就强行汇入同一目标表。例如订单和退款都有 id、amount,但它们的业务身份、生命周期和字段语义不同。将它们直接路由到一个目标对象,会让主键冲突和 Schema 演进都变得难以解释。
给表建立可追踪的命名规则
命名至少应保留业务域和对象含义。源端存在多库或多租户时,还要判断库名是不是业务身份的一部分。目标表名不必机械复制源端,但映射规则应能从配置中直接审计。
推荐把规则分成三层理解:源表选择负责回答“哪些表进入作业”,路由负责回答“源表改叫什么目标表”,Schema 与数据变更处理负责回答“目标表如何创建和持续更新”。不要把这三个职责都塞进一个复杂正则表达式。
配置多表路由
下面是 Flink CDC Pipeline YAML 的片段示例,依赖已经安装并配置对应版本的 MySQL Source 与目标 Sink 连接器。它选择两个订单分片和一张客户表,并把订单分片汇聚到统一目标表;连接参数中的占位符需要替换为实际值。
source:
  type: mysql
  hostname: <HOST>
  port: <PORT>
  username: flink
  password: <PASSWORD>
  tables: shop_01.orders|shop_02.orders|shop.customers

sink:
  type: values

route:
  - source-table: shop_0[1-2].orders
    sink-table: dw.orders
    description: Merge order shards into one logical table
  - source-table: shop.customers
    sink-table: dw.customers
    description: Route customers independently
这是配置片段,不包含完整的作业运行参数;具体连接器支持的配置项应以所使用的 Flink CDC 版本为准。values Sink 适合在教学或测试环境观察经过路由后的事件,不应把它当成生产持久化目标。
验证方法是运行 Pipeline 后观察 Sink 输出中的表标识,确认订单分片事件指向 dw.orders,客户事件指向 dw.customers。
预期结果
shop_01.orders  -> dw.orders
shop_02.orders  -> dw.orders
shop.customers  -> dw.customers
实际日志格式会随 Flink CDC 版本和连接器实现不同;这里的结果表达需要验证的映射关系,而不是要求日志逐字一致。
汇聚前检查主键和 Schema
把多张表路由到同一个目标对象前,至少检查两件事。第一是主键空间:两个分片都存在 id=1001 时,它们究竟是同一个订单还是两个不同订单。如果是后者,就不能直接把 id 当作统一目标表的唯一键,通常需要源端保证全局 ID,或在建模阶段引入能够区分来源的业务键。
第二是 Schema 兼容性。同构分表应该拥有相同或可兼容的列定义;如果一个分片把 amount 改成字符串,另一个仍是数值类型,汇聚后会把局部 Schema 问题扩大成统一目标表的问题。字段新增、删除和类型变化也需要按目标 Sink 的 Schema Evolution 能力分别验证。
用最小数据集验收路由
测试时不要一次灌入大量历史数据。分别向每张源表写入一条具有明显来源特征的记录,再检查目标表名、主键和字段值。对于汇聚表,还应故意测试两个分片出现相同主键的情况,确认系统是拒绝、覆盖还是按设计区分。
多表同步的核心不是“一个作业能接多少张表”,而是每条事件都有唯一、可解释的去向。源表选择保持边界清晰,路由规则保持可审计,只有业务语义和 Schema 真正一致的表才汇聚,后续扩表和 Schema 演进才不会变成隐式冲突。