
大数据与流处理 / 系统课时
升级时如何避免断档
升级时如何避免断档
CDC 作业升级最怕的不是短暂停机,而是恢复位置丢失、状态不兼容或新旧作业同时消费造成重复。本节建立一套从检查点、Savepoint、配置兼容性到灰度和回滚的升级路径,让升级后能够从已确认的位置继续处理变更。
学习目标
- 理解升级、Flink 状态与 CDC 读取位置之间的关系
- 能在升级前保存可恢复状态并检查关键配置变化
- 能设计带验证和回滚点的生产升级流程
为什么升级可能造成断档
Flink CDC Source 不只是维护业务计算状态,还需要记录增量读取进度。生产升级如果直接停止旧作业并以空状态启动新作业,新实例可能按照新的启动策略选择读取位置,而不是自动继承旧作业已经处理到的位置。
升级链路中需要同时保持三个对象连续:旧作业最后可靠状态、升级后的作业代码与配置、外部数据库仍然保留的增量日志。任何一环不兼容,都可能表现为漏读、重复读取或恢复失败。
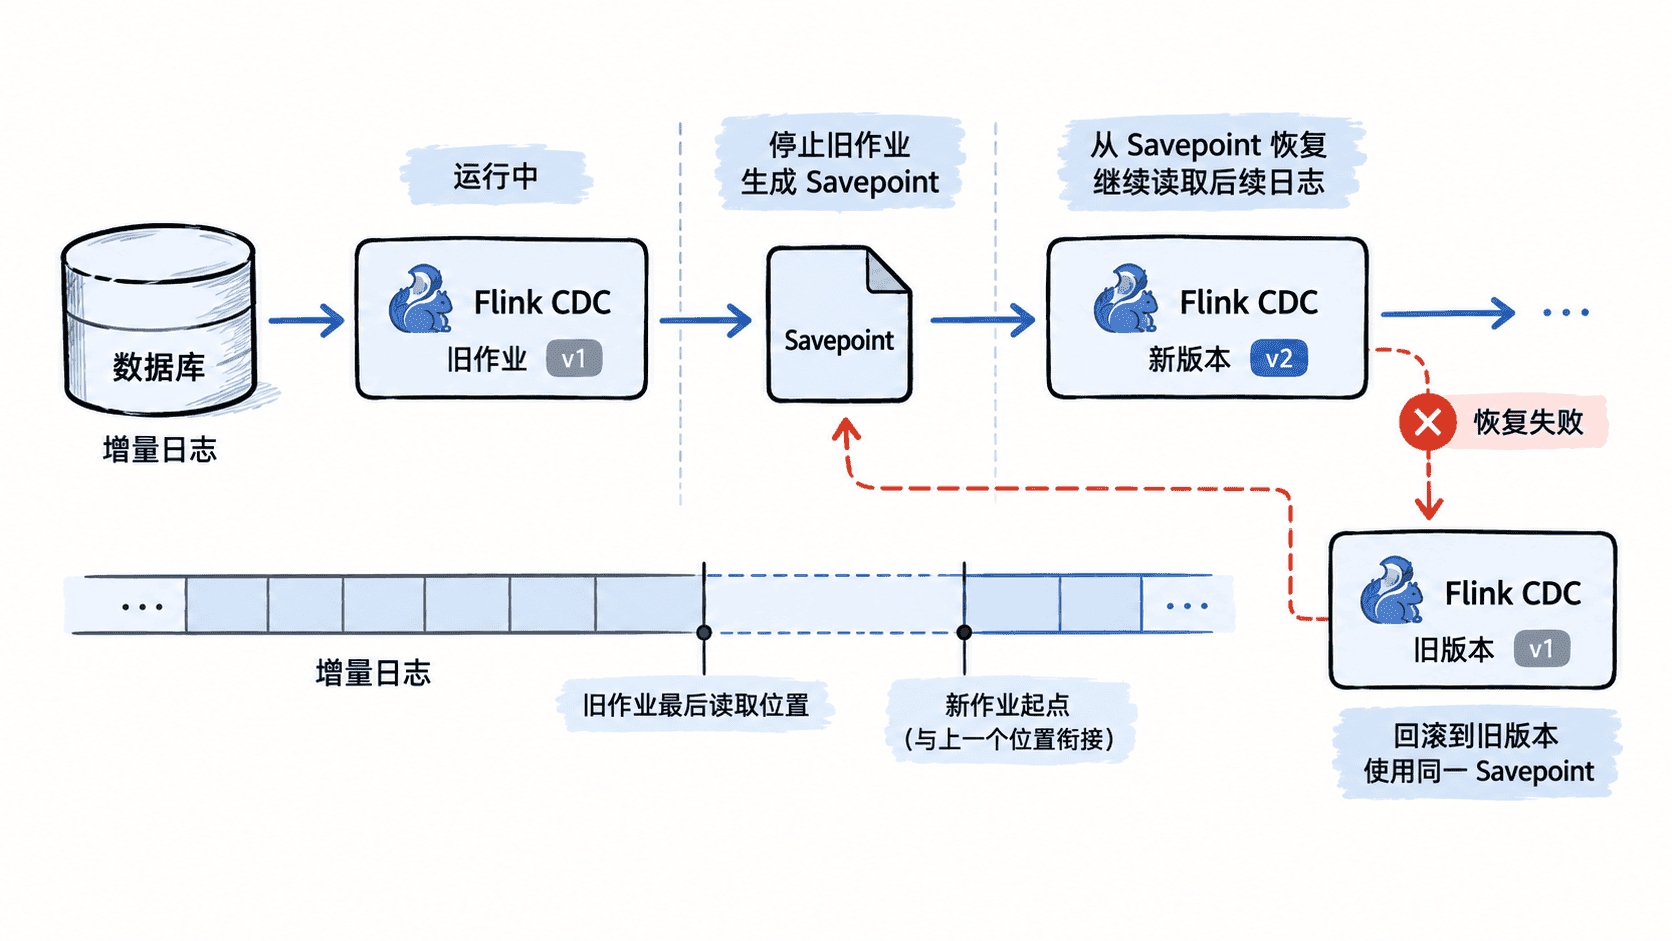
升级前固定恢复点
计划停机升级时,可以先用 Flink CLI 停止作业并生成 Savepoint。stop --savepointPath 会触发一次 Savepoint,并在成功后停止作业,比直接取消作业更适合作为有状态升级的交接点。
flink stop --savepointPath <PATH> <ID>预期输出
Savepoint completed. Path: <PATH><ID> 是实际 Job ID,<PATH> 是集群可访问的 Savepoint 目录,实际输出措辞会随 Flink 版本略有不同。升级前应记录最终 Savepoint 的完整路径,而不是只确认命令退出成功。
检查哪些变化会影响恢复
升级前先比较新旧作业,而不是先发布再试。需要重点检查 Source 表范围、连接目标、主键与表结构、并行度、算子拓扑以及状态相关配置。若代码调整了有状态算子的结构,还要确保用于状态映射的算子标识保持稳定。
对于 SQL 或配置驱动的 CDC 作业,还应特别检查启动模式。恢复已有状态时,读取位置应来自恢复状态;不要为了升级随意改成重新做全量快照或从最新位置启动,否则会改变数据覆盖范围。
可以先在提交前检查 Savepoint 是否存在并可由作业集群访问:
hadoop fs -ls <PATH>预期输出
-rw-r----- <ID> <ID> <ID> <TIME> <PATH>这里的所有动态字段仅表示占位,实际权限、所有者、时间和路径会不同。若使用对象存储或其他文件系统,应改用对应存储的检查方式。
从保存状态启动新版本
确认新版本制品和配置后,从记录的 Savepoint 提交新作业。下面以普通 Flink JAR 作业为例:
flink run -s <PATH> -d <PATH>/cdc-job.jar预期输出
Job has been submitted with JobID <ID>第一个 <PATH> 代表 Savepoint 路径,第二个 <PATH> 代表作业制品所在目录。提交成功只说明 JobManager 接受了作业,不能证明 CDC 已经恢复正常;随后还要检查作业是否持续处于运行状态、Source 是否开始推进,以及下游是否继续收到新变更。
灰度验证时,应选取可核对的测试变更或业务低峰期变更,确认升级前已有数据没有异常重放,升级后产生的新记录能够抵达目标端。对于严格要求不停写的系统,还应比较源端提交顺序和目标端消费结果,而不能只看作业状态为 RUNNING。
把回滚设计在升级之前
回滚条件应在发布前确定,例如恢复失败、持续重启、Source 无法读取保存位置,或者下游出现不可接受的数据差异。此时停止新版本,恢复旧版本制品和旧配置,再从升级时保存的恢复点启动。
不要让新旧两个实例在未设计高可用接管机制的情况下长期并行读取同一 CDC 数据源。升级窗口中应明确唯一活动作业、恢复点和制品版本,并保留旧版本直到新版本完成端到端验证。
真正可靠的升级不是保证一次发布绝不失败,而是让“旧版本停在哪里、新版本从哪里接、失败后退回哪里”都可验证。只要恢复状态、上游日志和版本制品同时保留,CDC 升级就能从一次冒险操作变成可控制的状态迁移。