
大数据与流处理 / 系统课时
字段不一致怎么定位
字段不一致怎么定位
CDC 任务出现字段缺失、错位或类型冲突时,问题可能发生在源表定义、CDC 捕获、Flink 类型转换、序列化或目标表写入中的任意一层。有效排查方法不是直接改 Sink,而是选定一条异常记录,沿字段经过的每个边界逐层比对。
学习目标
- 沿 Schema 与数据转换链路定位字段不一致的位置
- 区分字段缺失、字段映射错误和类型不兼容
- 用源表定义和中间事件验证修复是否正确
建立逐层比对链路
先固定一条能够稳定复现问题的记录,并记录其主键 <ID>。随后依次检查源表 Schema、CDC 事件、Flink 内部字段或序列化结果,以及目标表 Schema。只有找到“上一层正确、下一层错误”的边界,才能确定真正需要修改的位置。
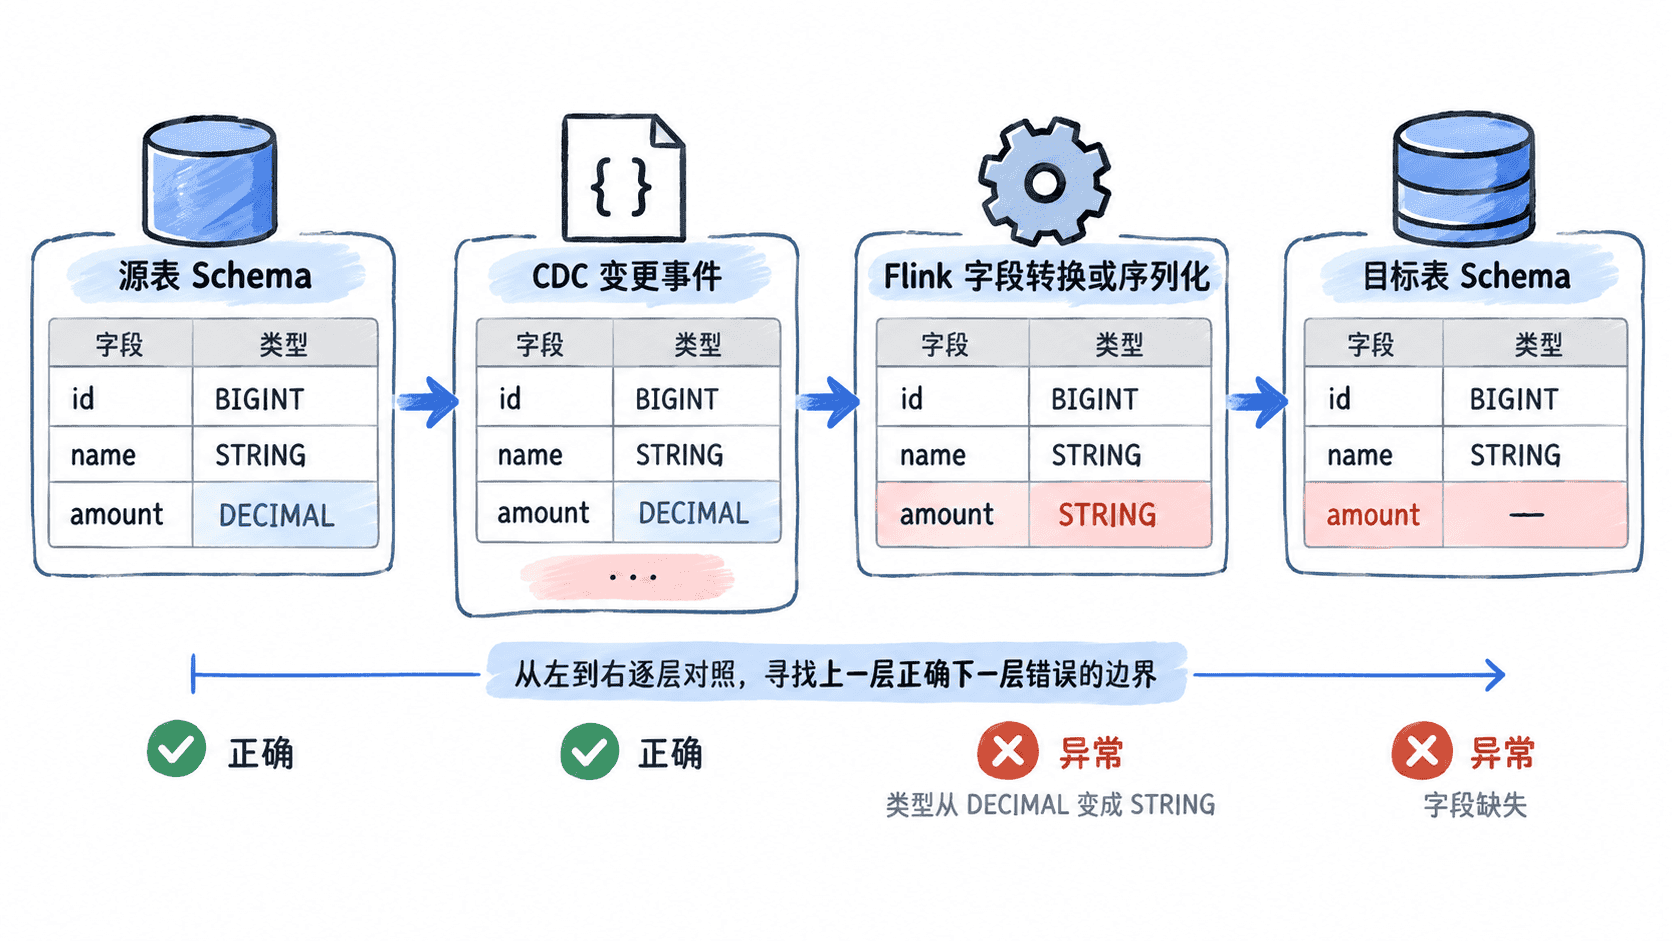
不要同时拿多条不同异常记录比较。字段问题可能来自不同原因,例如旧记录缺字段、新记录类型变化或特定值转换失败,混在一起会让故障边界变得模糊。
先确认源表真实 Schema
以 MySQL 为例,可以直接查看源表当前定义。假设异常字段是 amount,先确认字段是否存在、类型是否已经发生变更,以及 NULL 属性等约束是否符合预期。
SHOW CREATE TABLE orders;预期结果中的关键部分例如:
CREATE TABLE `orders` (
  `id` bigint NOT NULL,
  `amount` decimal(12,2) DEFAULT NULL,
  PRIMARY KEY (`id`)
)
如果这里已经不是预期类型,说明问题首先是源表 Schema 发生了变化;此时应继续核对 DDL 变更时间与 CDC 任务支持的 Schema Evolution 行为。若源表定义正确,再向 CDC 事件层移动。
检查 CDC 事件是否已经丢字段
排障环境中可以临时把相关数据输出到可观察的中间 Sink,或查看任务已有的调试日志,确认 CDC Source 实际产生的变更记录。重点比较字段名、值、逻辑类型,以及 DDL 发生前后的事件。
下面是一段用于比对的事件形态示例,属于片段示例;实际结构取决于所使用的 Flink CDC Source、反序列化器和任务定义:
{"id":<ID>,"amount":"125.30"}该片段本身不是独立可执行程序,因此不要求控制台输出。验证时应选择主键为 <ID> 的源记录,对照实际 CDC 事件。如果源表有 amount,但事件中完全没有该字段,排查重点就在 Source 的 Schema 获取、DDL 处理或反序列化配置,而不是目标表。
检查转换和目标表边界
如果 CDC 事件正确,而 Sink 收到的数据错误,就检查中间的 SQL、Table API 映射、字段投影、重命名和序列化逻辑。尤其要注意使用位置映射时,上游新增字段可能导致错误假设;使用字段名映射也要检查大小写和重命名规则。
目标表同样需要查看真实定义,而不是只依据建表脚本。以 MySQL 目标表为例:
SHOW CREATE TABLE orders_sink;预期结果应包含与同步契约兼容的字段,例如:
CREATE TABLE `orders_sink` (
  `id` bigint NOT NULL,
  `amount` decimal(12,2) DEFAULT NULL,
  PRIMARY KEY (`id`)
)
若事件中的 amount 已经是正确的 DECIMAL 语义,而目标列却是整数、长度不足的字符串或其他不兼容类型,问题就在 Sink Schema 边界。修复时应根据业务语义调整目标 Schema 或显式转换,避免依赖隐式类型转换掩盖问题。
用单条记录完成闭环验证
修复后仍使用最初记录的主键 <ID> 做验证:源表值正确、CDC 事件字段完整、转换后的字段名与类型正确,最终目标表值也一致。对于刚发生过 DDL 的场景,还应分别验证变更前已有数据和变更后新写入的数据,避免只验证一种事件形态。
如果只有历史数据异常而新数据正常,还需要判断是否应执行补数或重放;如果新事件仍持续错误,则说明在线链路尚未修复。字段不一致排障的核心是保存每一层的证据,并找到字段第一次发生变化的位置,而不是在链路末端不断增加类型转换。