
大数据与流处理 / 系统课时
看懂一次 CDC 数据流转
看懂一次 CDC 数据流转
本节解决数据库变更如何被捕获、处理并同步到目标系统的问题。通过理解一次 CDC 链路中的各个角色,能够定位数据从哪里产生、如何移动以及快照和增量事件分别处于什么位置。
学习目标
- 理解 CDC 从源库到目标端的完整数据流转过程
- 区分快照阶段与增量变更事件的职责
- 能够根据链路判断数据同步问题发生的位置
CDC 链路中的核心角色
CDC(Change Data Capture)用于捕获数据库中的数据变化,并将变化转换为可消费的事件。典型链路包含源数据库、日志捕获组件、Flink CDC 作业以及目标存储。
一次数据更新并不是直接从数据库复制到目标端,而是经过多个阶段:数据库产生变更日志,CDC 组件读取日志,将变化转换成事件,Flink 根据任务逻辑处理事件,最后写入目标系统。
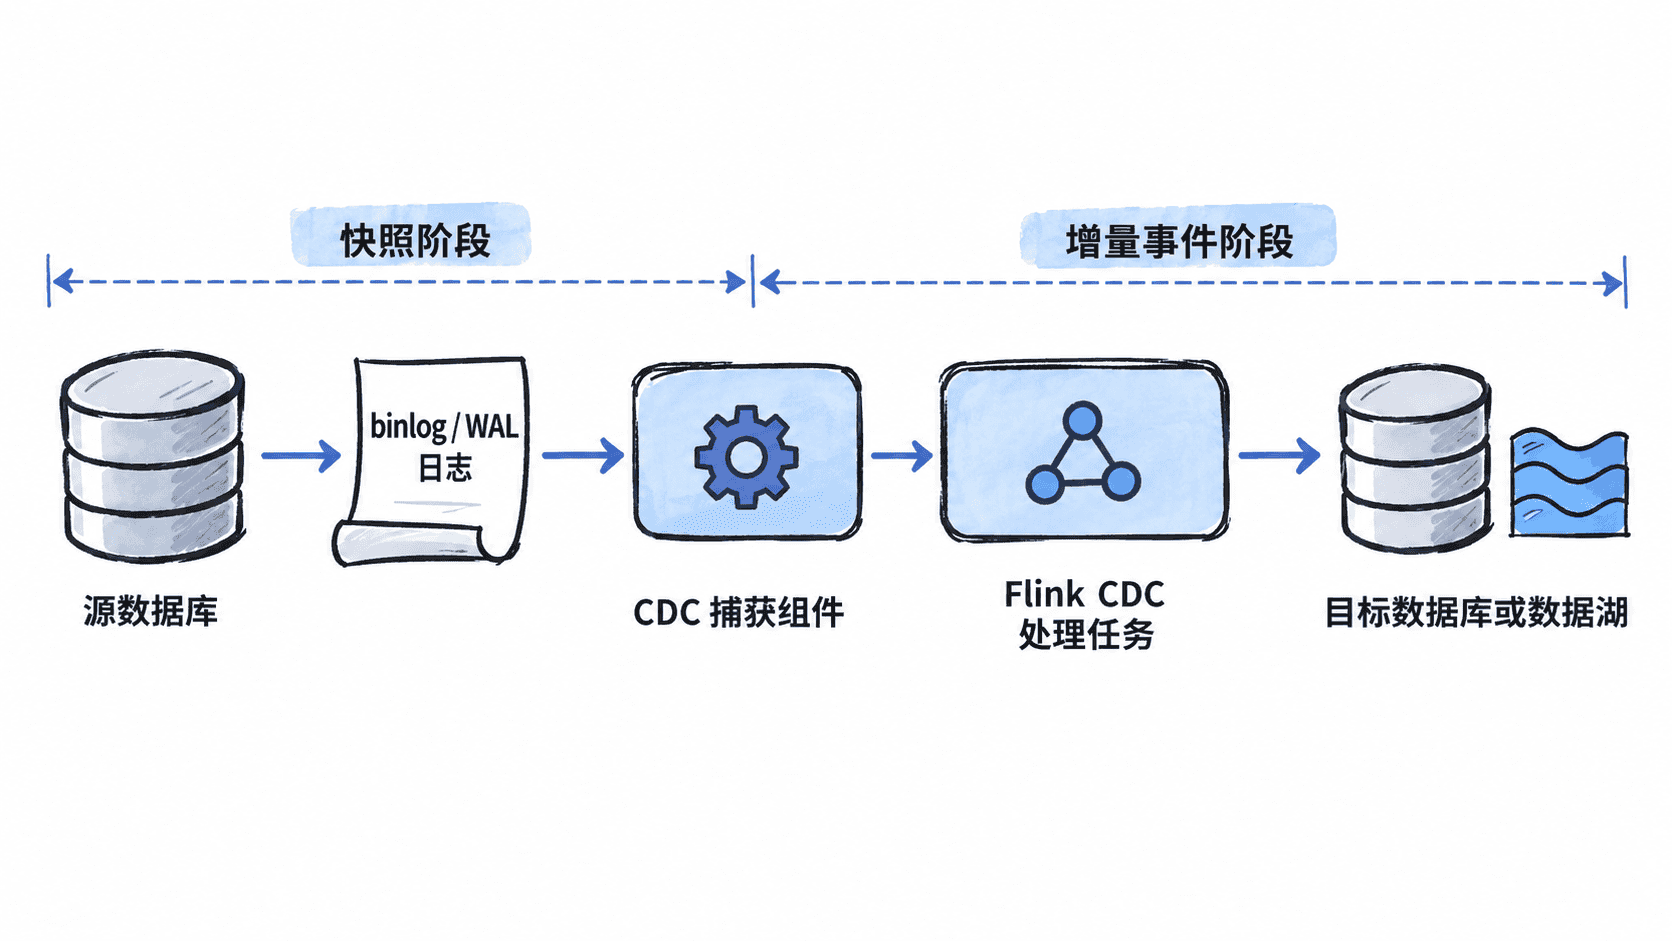
源数据库负责产生真实业务数据。例如 MySQL 中一次 INSERT、UPDATE 或 DELETE 会记录到 binlog。CDC 读取这些日志,而不是直接扫描业务表,因此能够持续获得变化信息。
快照与增量事件的位置
首次同步通常需要先获得已有数据,这个过程称为快照(Snapshot)。快照阶段会读取当前表中的历史数据,将已有状态发送到下游。
快照完成后,系统进入增量阶段。此时 CDC 不再读取旧数据,而是持续监听数据库日志,将新的变化转换成事件。
一次完整同步流程可以理解为:
- 连接源数据库并检查元数据。
- 执行初始快照,读取已有记录。
- 切换到日志位置,捕获后续变化。
- 将事件交给 Flink 处理并写入目标端。
例如用户修改订单状态:
text
数据库 UPDATE
    ↓
binlog 记录变化
    ↓
CDC 读取 UPDATE 事件
    ↓
Flink 转换数据
    ↓
目标表更新订单状态
Flink 在链路中的职责
Flink CDC 不负责产生数据变化,它负责消费 CDC 产生的事件,并完成计算、转换和写入。
一个简单的 Flink CDC SQL 示例:
sql
CREATE TABLE orders_source (
    id BIGINT,
    status STRING,
    amount DECIMAL(10, 2)
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '<HOST>',
    'port' = '<PORT>',
    'username' = '<USER>',
    'password' = '<PASSWORD>',
    'database-name' = '<DATABASE>',
    'table-name' = 'orders'
);

SELECT * FROM orders_source;
这段配置表示 Flink 从 MySQL CDC Source 读取订单变化事件。实际连接参数需要替换为实验环境中的值。
预期结果
text
Flink 作业启动后持续接收 orders 表的新增、修改和删除事件。常见链路误区
很多同步异常并不是目标数据库写入失败,而是前面的阶段没有产生正确事件。
常见定位方向包括:
| 现象 | 可能位置 |
|---|---|
| 历史数据没有同步 | 快照阶段 |
| 新修改的数据没有出现 | 日志捕获阶段 |
| 事件数量正确但结果错误 | Flink 转换逻辑 |
| 数据延迟持续增加 | Source、网络或 Sink 瓶颈 |
理解 CDC 数据流转后,排查问题时可以沿着数据经过的路径逐段确认,而不是只检查目标数据库。
按自己的节奏,确认真正理解。