
大数据与流处理 / 系统课时
区分快照和增量阶段
区分快照和增量阶段
Flink CDC 第一次启动时通常不会只等待新的 binlog,而是先读取启动前已经存在的数据,再持续捕获后续变更。理解这两个阶段,才能判断大量首次输出究竟是正常初始化,还是发生了重复同步。
学习目标
- 区分初始快照与持续增量捕获各自处理的数据
- 用可控实验从运行结果判断作业何时进入增量阶段
- 理解为什么不能只靠
+I、+U等行类型判断事件来自哪个阶段
两个阶段解决不同问题
假设 MySQL 表在 CDC 作业启动前已经有 10 万行。如果只从作业启动后的 binlog 位置开始读取,那么这 10 万行历史状态不会进入目标端;如果每次启动都重新全表复制,又无法高效地持续追踪变化。
Flink CDC 因此需要把“当前状态”和“之后发生的变化”衔接起来。初始快照负责读取启动时已经存在的数据,增量阶段随后持续消费数据库变更日志。二者共同构成一条连续的数据同步链路。
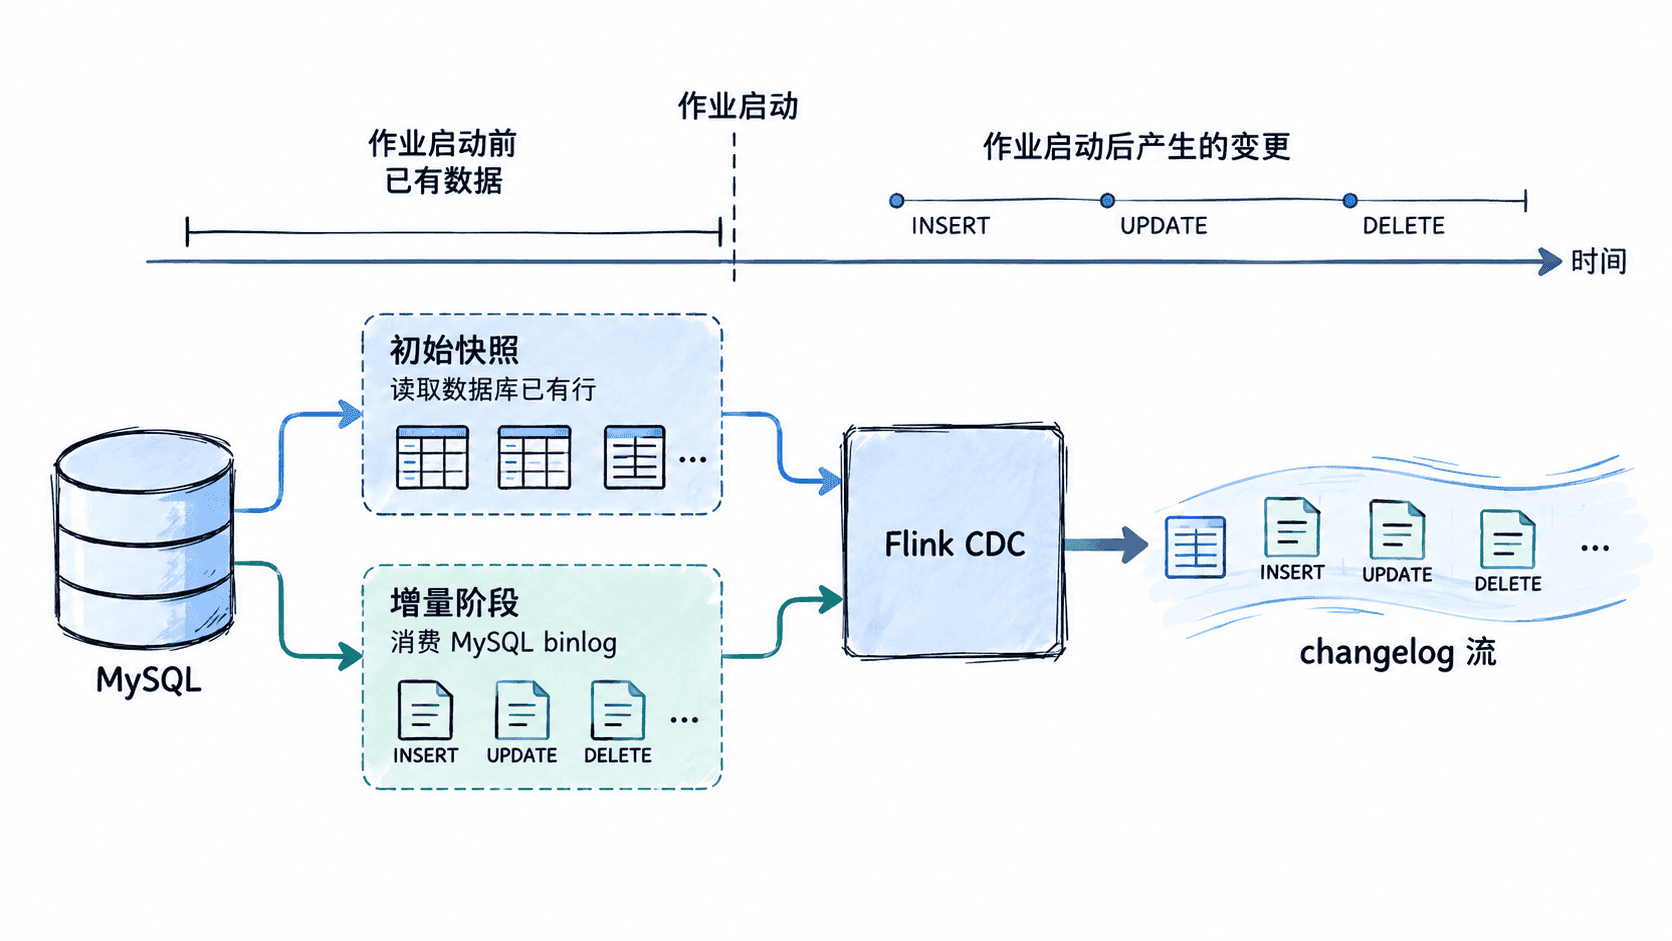
用基线数据观察阶段切换
最可靠的学习方法不是猜日志,而是人为控制事件发生时间。先在 CDC 作业启动前准备两行数据。
CREATE DATABASE IF NOT EXISTS cdc_demo;
USE cdc_demo;

CREATE TABLE phase_test (
    id BIGINT PRIMARY KEY,
    value_text VARCHAR(64) NOT NULL
);

INSERT INTO phase_test VALUES
    (1, 'before-start-a'),
    (2, 'before-start-b');
预期结果
Query OK, 2 rows affected然后在 Flink SQL Client 中建立 CDC 源表和 Print 目标表,并启动持续同步任务。连接参数需要替换成实际环境值。
CREATE TABLE mysql_phase_test (
    id BIGINT,
    value_text STRING,
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '<HOST>',
    'port' = '<PORT>',
    'username' = '<USER>',
    'password' = '<PASSWORD>',
    'database-name' = 'cdc_demo',
    'table-name' = 'phase_test'
);

CREATE TABLE print_phase_test (
    id BIGINT,
    value_text STRING,
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'print'
);

INSERT INTO print_phase_test
SELECT id, value_text FROM mysql_phase_test;
SQL Client 提交成功后会返回环境生成的 Job ID。
预期结果
Job ID: <ID>作业首次运行时,id=1 和 id=2 已经存在,因此会通过初始读取进入结果流。等这两行已经出现后,再修改源库。
USE cdc_demo;

INSERT INTO phase_test VALUES (3, 'after-start');
UPDATE phase_test SET value_text = 'after-update' WHERE id = 1;
DELETE FROM phase_test WHERE id = 2;
预期结果
Query OK, 1 row affected
Query OK, 1 row affected
Query OK, 1 row affected
此时后发生的三次操作来自持续变更捕获。Print connector 的典型 changelog 可以表现为下面这些行;实际日志可能带有任务编号等前缀,输出时序也会受到并行执行影响。
+I[1, before-start-a]
+I[2, before-start-b]
+I[3, after-start]
-U[1, before-start-a]
+U[1, after-update]
-D[2, before-start-b]
不要把行类型当成阶段标记
+I 表示插入语义的 changelog 行,但它并不等于“快照事件”。快照读取一条已有记录时可以表现为 +I,增量阶段捕获新的 INSERT 同样可以表现为 +I。因此只看到 +I 无法判断它来自哪个阶段。
区分阶段时应结合事件发生时间和可控基线:作业启动前已经存在的 id=1、id=2 属于初始数据;确认初始数据已经出现后才执行的 id=3 INSERT,以及后续 UPDATE、DELETE,则明确属于增量变化。生产环境还可以结合作业指标、checkpoint 和 source 日志辅助定位,但不要依赖某一条普通业务记录的 RowKind 猜测阶段。
首次大量输出为什么通常正常
首次部署 CDC 作业时,目标端短时间收到大量数据,往往是初始快照正在建立目标端基线,而不是数据库突然产生了同等数量的新 INSERT。真正需要警惕的是作业异常重建、状态丢失或启动策略改变后,目标端是否能够正确处理再次到达的数据。
判断 CDC 是否工作正常时,应先问这条记录是在作业启动前已经存在,还是在基线建立后才发生变化。把时间边界和 changelog 语义分开理解,就不会把首次快照误判成实时新增,也不会漏掉真正的增量捕获问题。