
大数据与流处理 / 系统课时
处理日志位点失效
处理日志位点失效
CDC 作业长时间停机后,即使 Checkpoint 仍然存在,也可能因为数据库已清理对应的 binlog、WAL 等增量日志而无法恢复。本课建立一条安全处理路径:先确认保存位点与日志保留范围,再决定恢复、重新初始化或补数,避免直接重启造成数据缺口。
学习目标
- 判断恢复失败是否由源端日志位点失效引起
- 按“检查位点—确认日志—选择恢复路径”的顺序处理故障
- 理解重新初始化前必须保护的数据一致性边界
为什么 Checkpoint 在却恢复不了
Flink Checkpoint 保存的是 Source 已消费到哪里以及算子状态,并不会替源数据库永久保存变更日志。以 MySQL CDC 为例,恢复状态可能指向某个已经被数据库清理的 binlog 文件。此时状态本身没有损坏,但恢复所依赖的外部历史已经不存在。
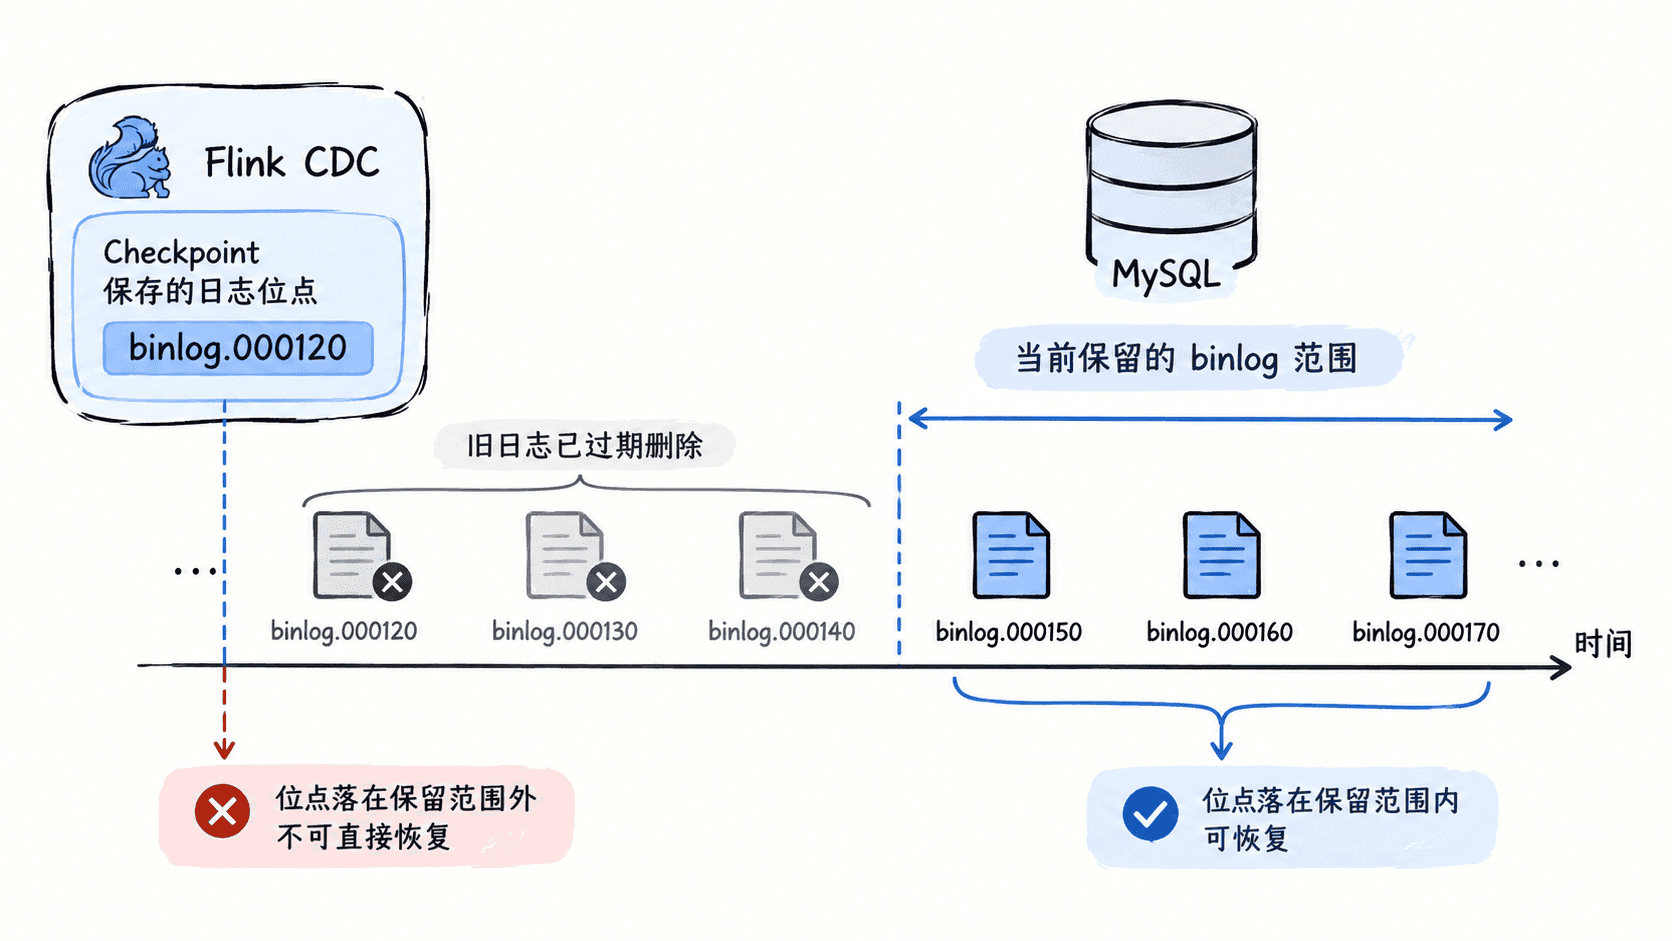
因此排查时要同时回答两个问题:Flink 想从哪里继续读取,以及源端现在最早还能提供哪里的日志。只有前者落在后者的有效范围内,增量恢复才成立。
先确认源端还保留哪些日志
MySQL 场景可以先查看当前 binlog 清单,而不是反复重启 Flink 作业。下面的 SQL 可在具有相应权限的 MySQL 会话中执行。
SHOW BINARY LOGS;预期结果类似下面这样,实际文件名和大小会不同:
Log_name        File_size  Encrypted
binlog.000150   <SIZE>     No
binlog.000151   <SIZE>     No
如果恢复状态要求从 binlog.000120 继续,而 SHOW BINARY LOGS 的最早文件已经是 binlog.000150,说明所需日志不在源端,不能通过普通的状态恢复补回这段历史。还应结合 TaskManager/JobManager 日志确认错误确实指向日志文件或位点不可用,而不是网络、权限或反序列化失败。
根据检查结果选择恢复路径
处理路径可以分为三类。所需日志仍完整时,优先修复连接、权限等真正故障并从原状态恢复;日志已经失效但下游可以整体重建时,可以重新执行一致的全量初始化,再进入增量阶段;下游不能清空时,则需要先确定缺失时间窗或主键范围,通过可审计的补数流程修复,再建立新的连续增量起点。
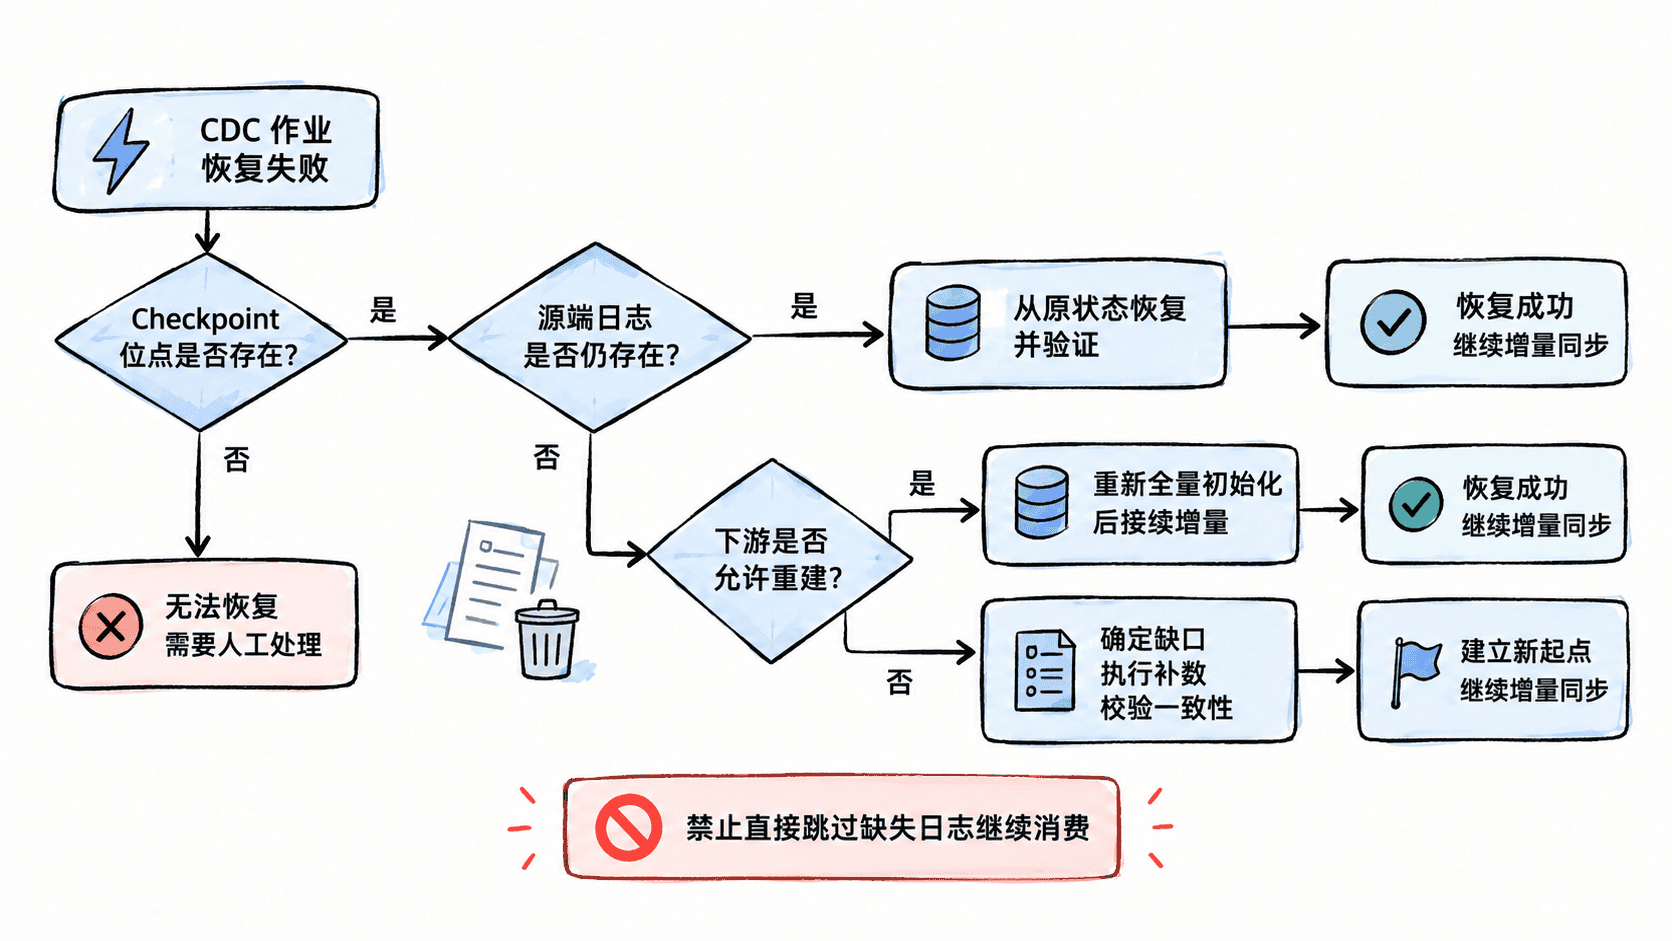
最危险的做法是直接指定一个较新的日志位置启动,然后把“作业能运行”当作恢复成功。这样虽然绕过了启动错误,但旧位点与新位点之间的变更会永久缺失。
重新初始化时保护一致性
重新初始化不是简单地“重新跑一次全量”。需要先明确目标表如何处理旧数据,以及初始化期间产生的新变更如何与快照衔接。Flink CDC 的具体启动模式和配置应按所用连接器版本确认,不要在故障现场凭记忆修改启动参数。
执行恢复前至少记录:最后可信的 Checkpoint、源端当前最早日志、故障时间窗、下游最后可信数据范围以及准备采用的初始化方式。若需要清理下游数据,应先确认其没有被其他业务作为唯一数据源使用。
恢复完成后的验证也不能只看 Job 进入 RUNNING。应选择故障窗口前后具有代表性的主键,比较源端与下游数据,并继续观察新的 Checkpoint 能否成功完成。只有日志链路重新连续、数据抽查一致且 Checkpoint 正常推进,才算完成恢复。