
大数据与流处理 / 系统课时
新增列后下游怎么跟
新增列后下游怎么跟
新增字段看似是最简单的 Schema 变化,但一次真实 CDC 实验至少要确认三件事:源表新列是否生效、CDC 是否产生带新 Schema 的数据,以及目标表最终能否接收新字段。本篇用一套可重复的实验顺序定位变化究竟停在哪一层。
学习目标
- 执行新增列实验并验证源表结构和新数据
- 检查 CDC 事件或序列化结果是否已经包含新增字段
- 判断目标端需要自动演进、预先扩列还是显式字段映射
先建立可观察的实验
不要只执行 DDL 后观察作业有没有报错。实验应同时准备一条变更前记录和一条变更后记录,这样才能区分旧数据、新数据以及 Schema 变化带来的影响。
下面以 MySQL 源表 orders 为例。假设 Flink CDC 作业已经在读取该表,先新增一个允许为空的 remark 字段,再写入一条明确携带该字段的数据。
ALTER TABLE orders
ADD COLUMN remark VARCHAR(255) NULL;

INSERT INTO orders (id, amount, remark)
VALUES (1002, 88.50, 'priority');

SELECT id, amount, remark
FROM orders
WHERE id = 1002;
预期结果是源库能够返回新字段和值。金额的显示格式可能因客户端设置而略有差异。
id    amount  remark
1002  88.50   priority
这一步只证明源库修改成功,还没有证明 CDC 和目标端已经跟上。
沿数据链路逐层检查
新增列后的验证顺序应该固定为“源 Schema → CDC 事件 → 序列化结果 → 目标 Schema → 目标数据”。这样出现问题时,可以确定变化在哪个边界停止,而不是直接重启整个作业碰运气。
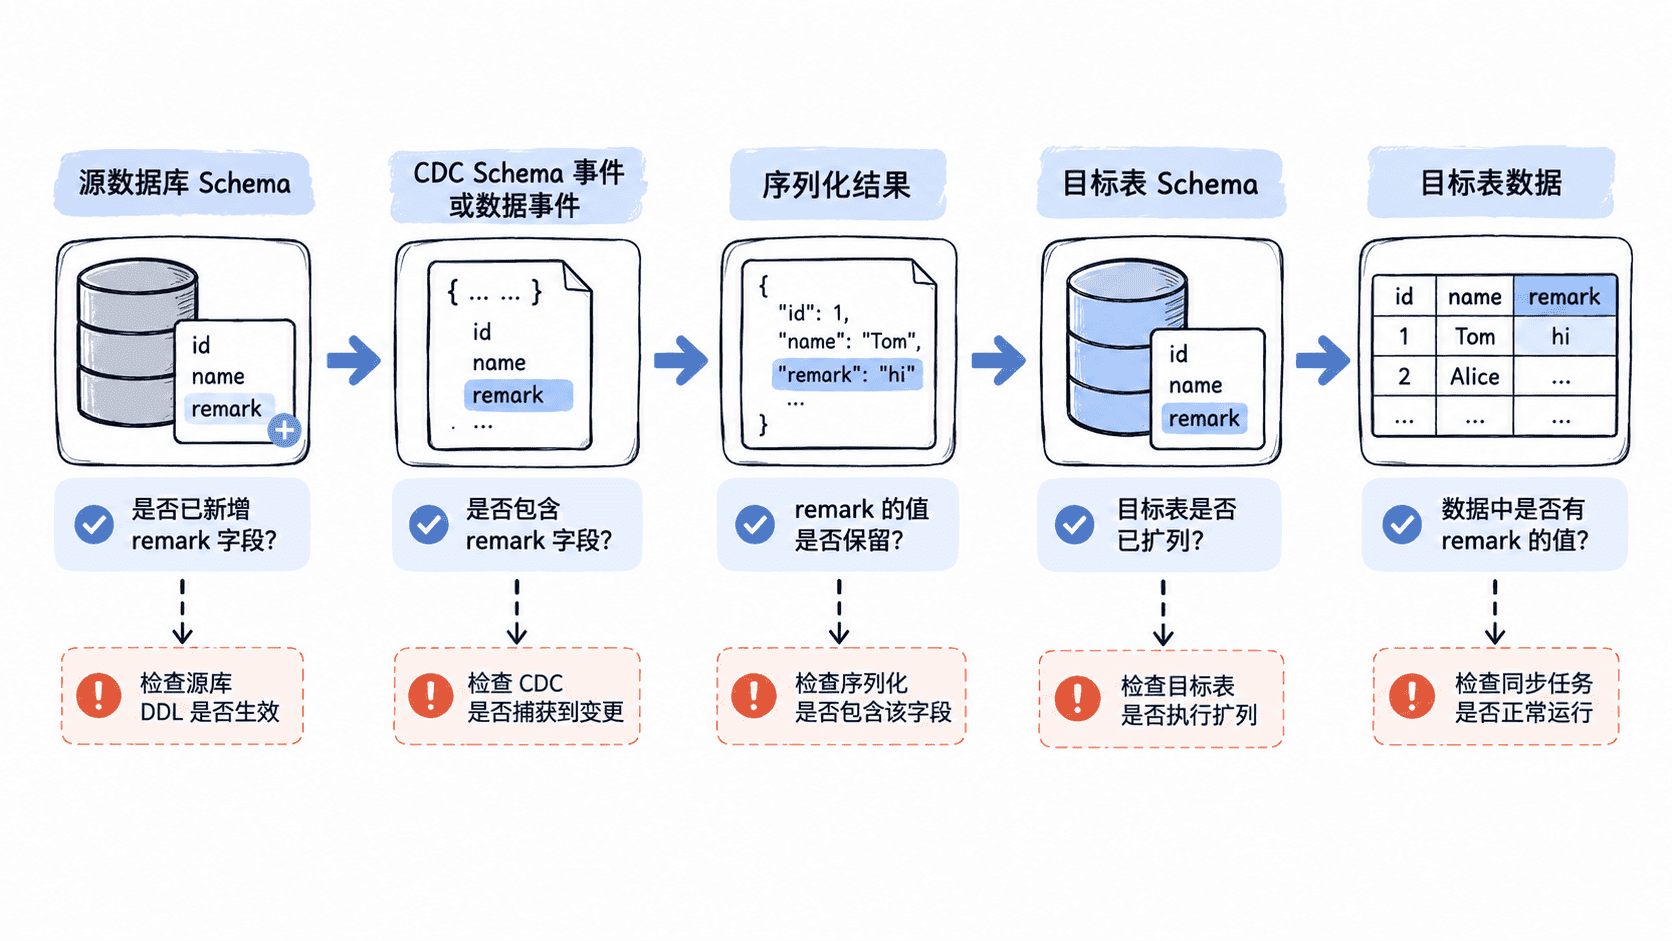
如果作业把 CDC 记录转换为 JSON,可以重点检查变更后的记录是否出现 remark。实际事件外层结构取决于所使用的 CDC API、反序列化器和配置,因此不要用某一种 JSON 外形作为所有 Flink CDC 作业的固定标准。
例如,自定义反序列化结果若约定输出业务对象,新增后的记录可以验证为下面这种业务字段集合。该内容是片段示例,依赖你的作业已经把 CDC 内部事件转换为业务 JSON。
{"id":1002,"amount":88.50,"remark":"priority"}验证重点不是字段排列顺序,而是新记录中能够找到 remark,且值没有在反序列化或字段投影阶段丢失。
目标表不会天然自动扩列
CDC 事件里已经出现新字段,并不意味着任意 Sink 都会执行 ALTER TABLE。目标端能否自动跟随取决于所采用的 Flink CDC 方案、版本、Sink 连接器及其 Schema Evolution 支持能力。
如果当前链路不支持自动演进,应在允许新字段写入之前显式修改目标表。例如目标也是 MySQL,可以先执行:
ALTER TABLE orders_sink
ADD COLUMN remark VARCHAR(255) NULL;

SHOW COLUMNS FROM orders_sink LIKE 'remark';
预期输出应确认目标列已经存在并允许接收对应值。
Field   Type          Null  Key  Default  Extra
remark  varchar(255)  YES        NULL
配置文件或 SQL 中如果显式列出了字段,还必须同步检查字段投影。源端和目标端都已经扩列,但中间仍使用固定的 SELECT id, amount,新字段同样不会抵达 Sink。
用目标数据完成验收
最后查询目标表,确认结构变化和业务值都已落地。只有看到目标端的新字段和值,才能证明这次新增列真正穿过了完整链路。
SELECT id, amount, remark
FROM orders_sink
WHERE id = 1002;
预期结果应与源端测试记录在业务字段上保持一致。
id    amount  remark
1002  88.50   priority
如果源库有 remark、CDC 输出也有 remark,但目标端没有,排查重点就在 Sink 的字段映射和 Schema Evolution;如果 CDC 输出本身已经缺少该字段,则应向前检查连接器的 Schema 变化处理、反序列化逻辑和固定字段投影。按边界逐层验证,比单纯观察作业是否 RUNNING 更能证明新增列已经安全落到下游。