
大数据与流处理 / 系统课时
看懂 checkpoint 保存什么
看懂 checkpoint 保存什么
CDC 作业重启后能继续消费,并不是因为数据库日志自己记住了 Flink 的处理进度。真正的恢复依据来自 Flink checkpoint:它把算子状态、键控状态以及 Source 的读取进度组织成一致快照,使各组件能够从同一个逻辑进度恢复。
学习目标
- 理解 checkpoint 中与 CDC 恢复有关的状态分别承担什么职责
- 说清 checkpoint 与数据库 binlog、WAL 等外部日志位点的关系
- 能通过 checkpoint 信息判断作业是否具备可恢复基础
checkpoint 保存的是一致状态快照
Flink checkpoint 不是简单保存“当前读到了哪一行”。一次成功 checkpoint 会协调参与作业的数据源和算子,把恢复所需的托管状态持久化到配置的 checkpoint 存储中。
对于 CDC 作业,可以把恢复信息理解成两部分:Source 需要保存能够重新定位外部变更流的读取进度;有状态算子需要保存已经计算出的 keyed state 或 operator state。具体状态内容取决于使用的 Source、连接器版本和作业逻辑,不能假设所有 CDC 连接器都保存完全相同的字段。
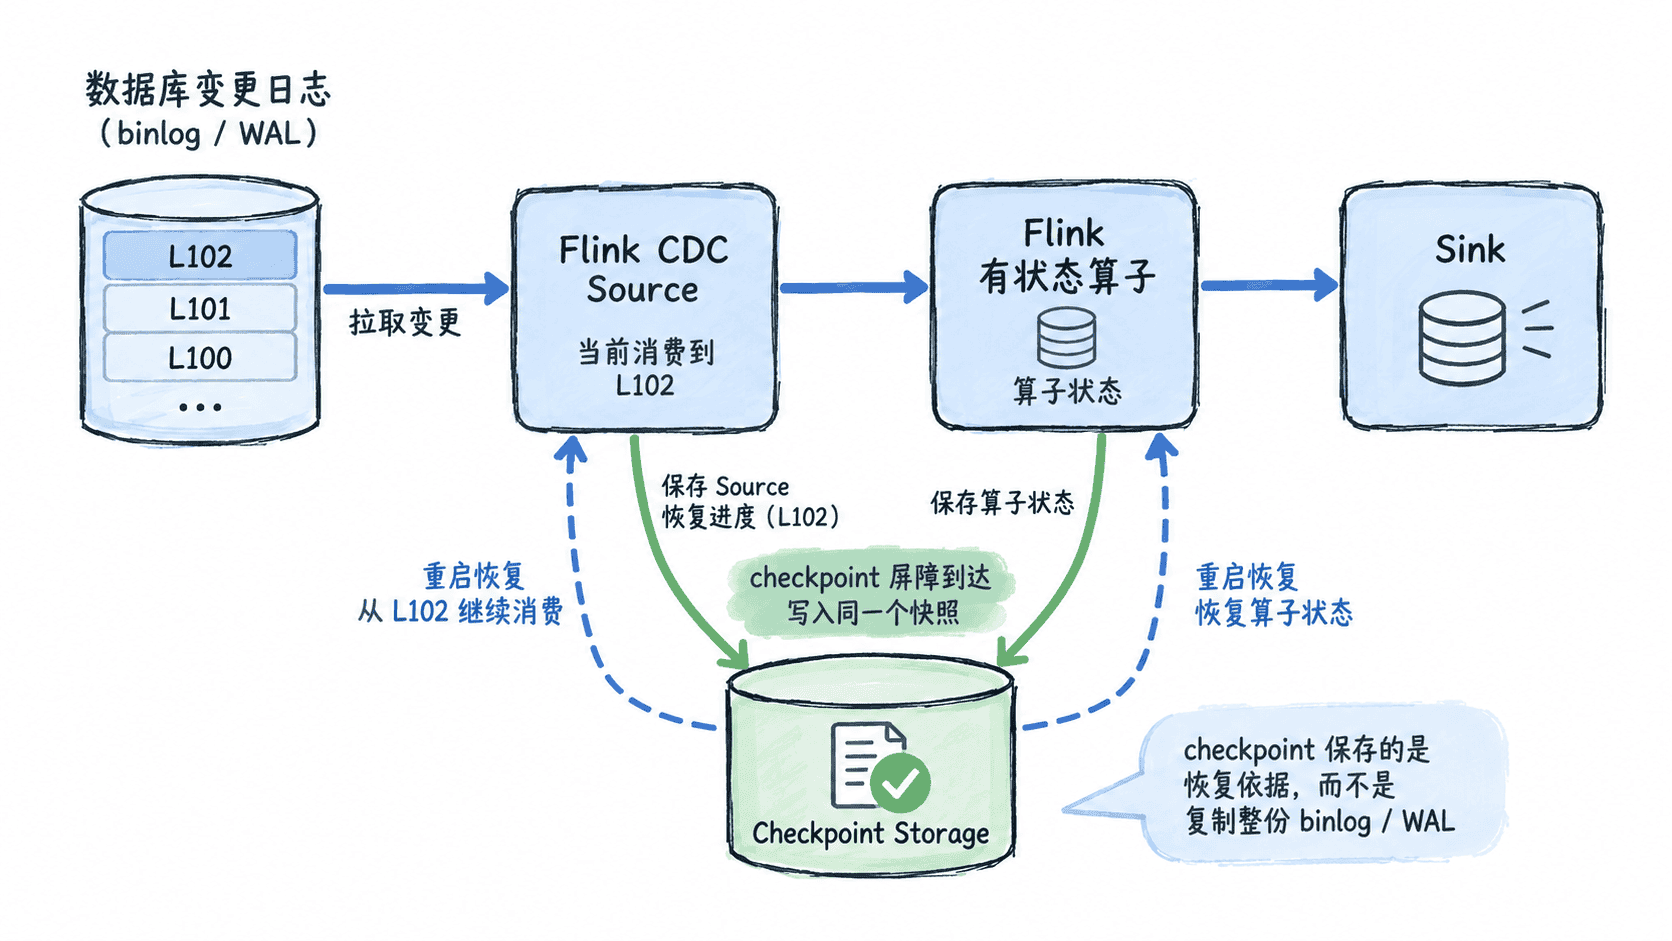
外部日志位点和 checkpoint 是两层概念
MySQL binlog、PostgreSQL WAL 等日志存在于数据库侧。CDC Source 必须能够描述自己消费到哪里,例如某种日志位置或等价的恢复进度;Flink checkpoint 则负责把 Source 的这部分状态与作业其他状态放进一次一致快照。
因此不能把二者理解成“checkpoint 复制了一份数据库日志”。数据库仍负责保存日志本体,checkpoint 保存的是恢复作业所需的状态。恢复时,Source 根据已恢复的进度重新连接外部系统,并从仍然可用的日志位置继续读取。
这也解释了一个重要边界:即使 checkpoint 文件完好,如果数据库已经清理了恢复所需的旧日志,Source 仍可能无法从该位置继续消费。日志保留策略必须覆盖可能的故障和恢复窗口。
用配置建立可恢复基础
下面是 Flink 配置文件中的片段示例,依赖已经可用且具备持久性的 checkpoint 存储路径;实际生产环境应选择适合部署方式的持久化文件系统或对象存储,而不是容器临时目录。
execution.checkpointing.interval: 60 s
execution.checkpointing.mode: EXACTLY_ONCE
execution.checkpointing.timeout: 10 min
execution.checkpointing.min-pause: 10 s
execution.checkpointing.max-concurrent-checkpoints: 1
execution.checkpointing.externalized-checkpoint-retention: RETAIN_ON_CANCELLATION
execution.checkpointing.storage: filesystem
execution.checkpointing.dir: <CHECKPOINT_URI>
这段配置的生效行为是周期性触发 checkpoint,并把 checkpoint 数据写入 <CHECKPOINT_URI>。实际 URI 需要替换为集群能够访问的持久化位置。
可以在运行中的作业上查看 checkpoint 概况:
flink list -r预期输出会包含正在运行的作业,格式类似:
<TIME> : <ID> : <JOB_NAME> (RUNNING)<TIME>、<ID> 和 <JOB_NAME> 随实际环境变化。作业处于 RUNNING 只能证明当前正在运行,不能证明 checkpoint 已成功完成;还需要通过 Flink Web UI 的作业 Checkpoints 页面或监控指标确认最近存在成功 checkpoint。
一次恢复实际依赖什么
假设某次成功 checkpoint 记录了 Source 的恢复进度 P,同时算子状态也对应处理到 P 的一致视图。之后作业继续处理到 Q,但还没有完成下一次 checkpoint 就发生故障,那么从该 checkpoint 恢复时,托管状态回到 P,Source 也从与该快照一致的进度恢复,而不是简单从故障前内存中的 Q 继续。
从 P 之后重新读取的数据可能再次经过数据流,因此端到端结果还受到 Source、Sink 以及 checkpoint 语义共同影响。不能只看到 EXACTLY_ONCE 配置,就假定任意外部 Sink 都天然获得端到端 exactly-once;Sink 必须具备相应的一致性机制。
重启前后应该验证什么
测试环境中可以主动做一次恢复演练:先确认至少有一个成功 checkpoint,再记录下游已同步的数据范围,然后让作业发生可控重启。恢复后继续向源表写入测试数据,观察旧数据是否异常重复、后续变更是否继续到达,以及有状态计算是否保持正确。
如果恢复失败,应按顺序检查三个位置:成功 checkpoint 是否仍可访问、Source 保存的恢复进度对应的数据库日志是否仍存在、下游 Sink 是否能正确承接重放的数据。这样可以把“checkpoint 坏了”“日志被清理了”和“Sink 无法保证一致性”区分开来。
理解 checkpoint 时最重要的心智模型是:数据库日志提供可重新读取的历史,Source 状态记录从哪里恢复,Flink checkpoint 再把这个进度与算子状态绑定成一致快照。三者同时成立,CDC 作业才真正具备经得住重启的恢复基础。