
大数据与流处理 / 系统课时
判断重复数据从哪产生
判断重复数据从哪产生
CDC 作业故障恢复后出现重复数据,不能直接归因于 Source。一次事件可能因为恢复而重新读取,也可能只是 Sink 将同一业务变更重复写成了两条记录。本课用可追踪的故障实验,把 Source 重放、状态恢复和 Sink 幂等三个环节拆开定位。
学习目标
- 能区分事件重放与目标端重复记录
- 能用 Checkpoint 边界定位重复发生在哪个阶段
- 能判断 Sink 是否具备适合业务语义的幂等能力
先区分重复事件和重复结果
Flink 的故障恢复会回到最近一次成功 Checkpoint 的一致状态。Checkpoint 之后已经处理、但尚未包含在成功 Checkpoint 中的工作可能再次执行,因此下游算子有机会再次看到相同业务变更。是否最终形成重复记录,还取决于 Sink 的提交协议以及目标系统的写入语义。
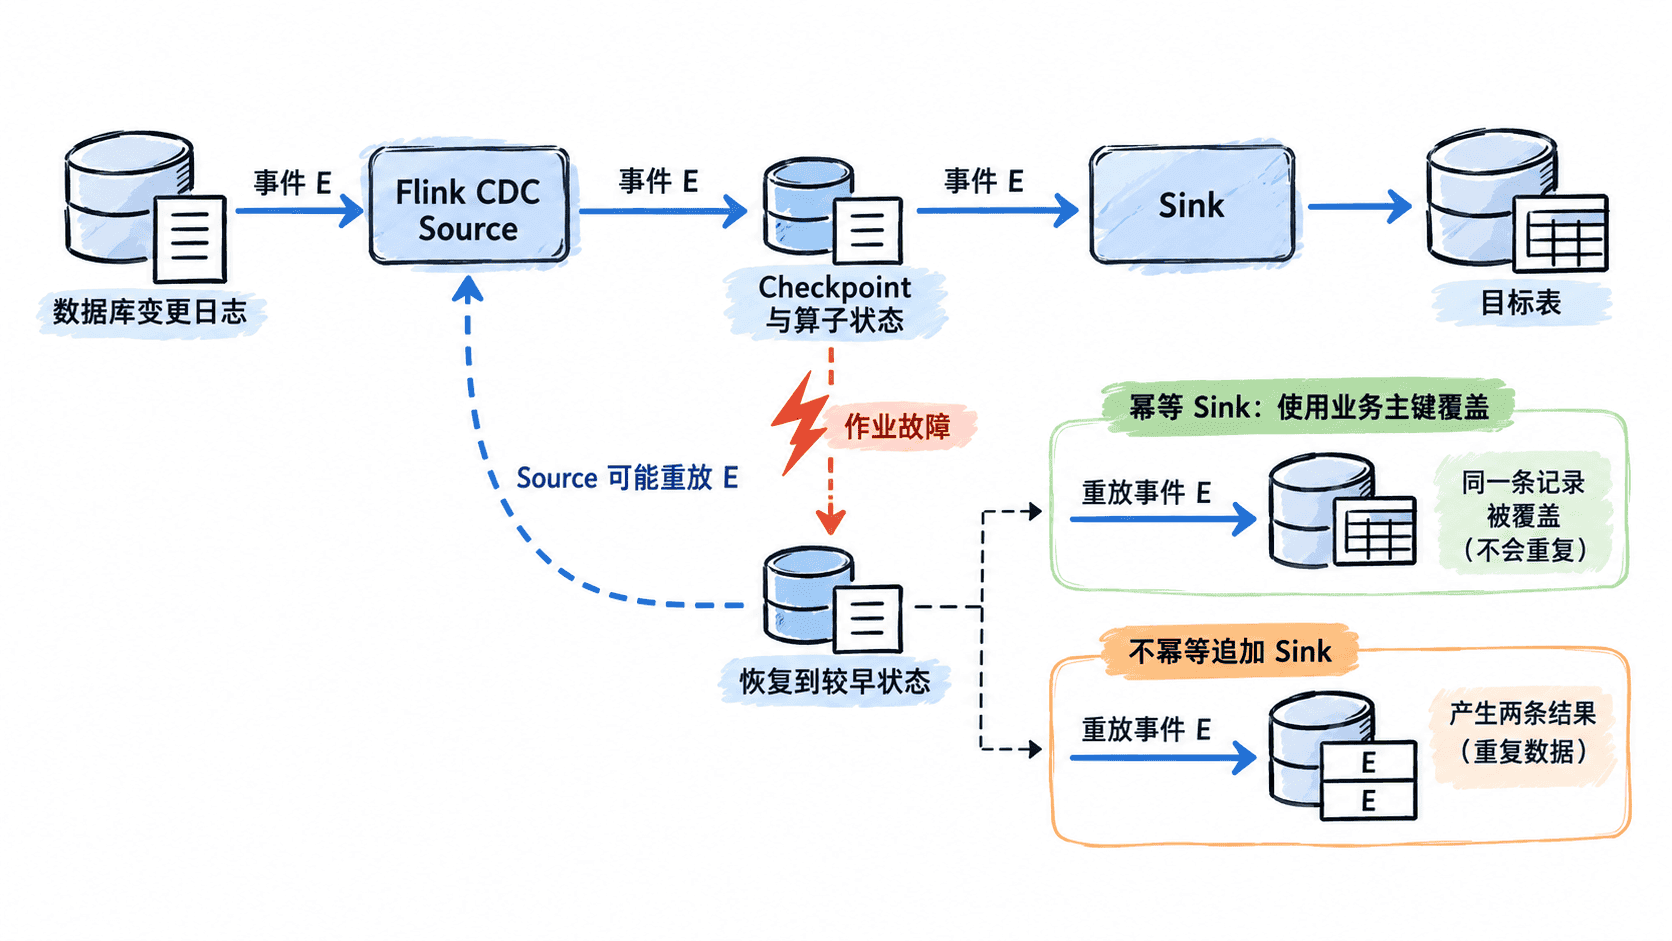
排查时应分别回答三个问题:Source 是否重新发出了某个变更;恢复后的算子状态是否来自预期 Checkpoint;Sink 对相同业务事件再次到达时会覆盖、拒绝还是追加。只有最后一个问题决定了重放是否表现为目标端可见的重复行。
用唯一测试记录制造故障
先准备一个能明确识别的业务键。以下示例假设源端 MySQL 已存在 orders 表,并以 id 作为业务主键。
INSERT INTO orders (id, status) VALUES (91001, 'CREATED');
UPDATE orders SET status = 'PAID' WHERE id = 91001;
预期结果
Query OK, 1 row affected
Query OK, 1 row affected
在事件进入流水线后制造一次故障,并让 Flink 从最近一次成功 Checkpoint 自动恢复。实验环境可以通过取消 TaskManager 进程等方式制造故障,但不要在生产环境为了验证而随意终止进程。恢复后继续观察 id = 91001 对应事件和目标记录。
判断是不是 Source 重放
如果作业日志或测试 Sink 能记录业务主键、操作类型和事件顺序,可以检查 91001 的同一变更是否在恢复前后各出现一次。不要只依赖数据库生成的日志时间,因为重放后的处理时间天然不同;应优先使用业务主键以及 CDC 事件携带的源端位置信息进行关联。
可以先确认作业确实经历了恢复,而不是被无状态重新提交:
./bin/flink list -r预期输出
<TIME> : <ID> : <JOB_NAME> (RUNNING)随后在 Flink Web UI 的 Checkpoints 页面核对恢复所对应的成功 Checkpoint。若故障后作业没有从预期状态恢复,先修复状态恢复问题,再分析 Sink;否则两个变量同时变化,很难得到可信结论。
检查 Sink 是否把重放变成重复行
最直接的判断方式是查询目标端同一业务键的记录数量。假设目标表同样以 id 表示订单标识:
SELECT id, COUNT(*) AS row_count
FROM orders
WHERE id = 91001
GROUP BY id;
预期结果
+-------+-----------+
| id    | row_count |
+-------+-----------+
| 91001 |         1 |
+-------+-----------+
如果目标表对 id 有主键或唯一键,并且 Sink 使用 upsert 语义,相同业务键再次到达通常会更新既有记录,而不是追加一行。若目标是纯追加表、消息消费者再次落库时没有去重,或者写入逻辑每次都生成新的目标主键,那么 Source 的一次重放就可能变成用户可见的重复数据。
按证据定位根因
如果 Source 观察到同一变更再次出现,但目标端最终只有一条正确记录,说明发生了重放,但 Sink 的幂等或事务语义吸收了它。如果 Source 没有重复而目标端出现两条记录,应继续检查 Sink 重试、应用侧二次写入或目标端触发器等写入路径。
如果重复总发生在故障恢复之后,还应核对 Checkpoint 是否持续成功、作业是否真的从状态恢复,以及 Sink 是否参与了与 Checkpoint 协调的提交过程。相反,如果没有任何故障也持续产生重复,优先检查源库本身的业务写入、主键设计和下游写入逻辑,而不是把问题归因于恢复机制。
排查重复数据的核心不是寻找一个“不会重复”的单点,而是建立完整证据链:先确认恢复点,再确认 Source 是否重放,最后检查 Sink 如何处理重放。只有把事件层重复和结果层重复分开,才能决定应该修状态恢复、调整 Sink 语义,还是给目标表增加可靠的业务唯一约束。