
大数据与流处理 / 系统课时
删除和重命名列怎么处理
删除和重命名列怎么处理
删除列会让字段消失,重命名列则会改变字段身份;对 CDC 链路而言,两者都可能破坏下游映射、历史数据解释和消费契约。本课从变更窗口出发,设计可验证、可回退的删除与重命名策略。
学习目标
- 区分删除列与重命名列对增量同步链路的不同风险
- 设计兼容新旧字段名的过渡窗口
- 验证 Source、转换逻辑和 Sink 在字段退出后的行为
删除和重命名不是同一种变化
删除列的核心问题是字段不再存在。如果转换 SQL、Sink 映射或下游任务仍引用它,Schema 变化传播后就可能失败。重命名则更复杂:业务人员认为字段还是同一个含义,但技术链路可能把“旧列删除、新列出现”或一个专门的重命名 Schema 事件作为变化来处理,具体行为取决于连接器、版本和目标端能力。
因此不能只看源数据库最终表结构。真正需要检查的是从 Source 到 Sink 的每一处字段引用,以及目标端如何保存旧字段的历史语义。
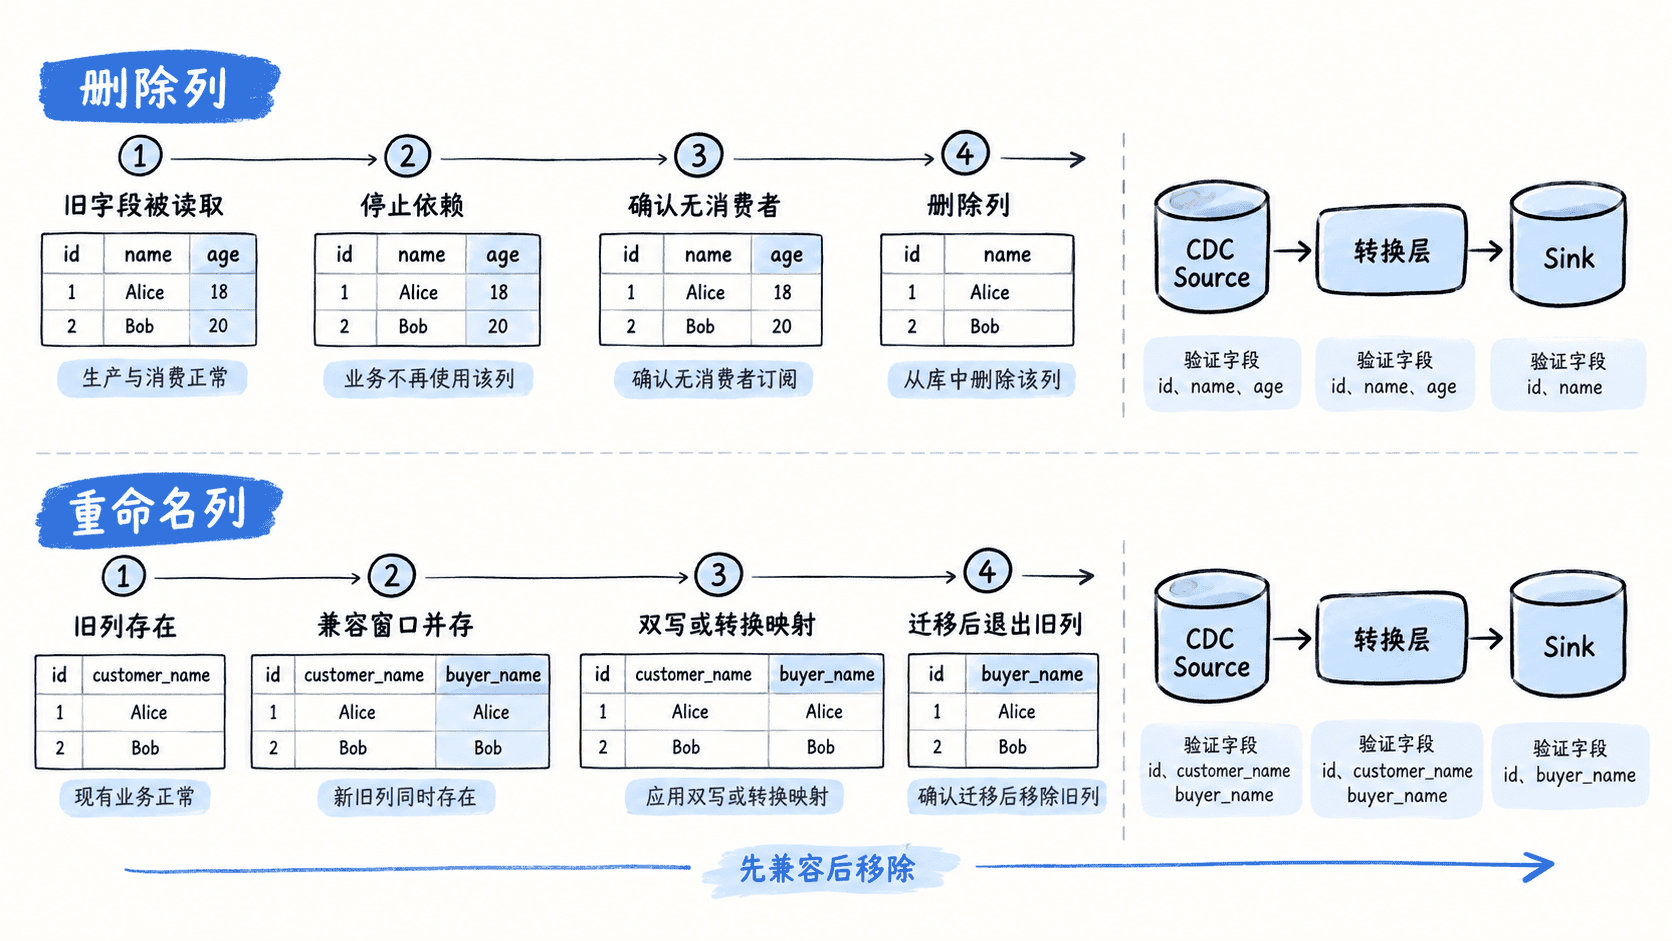
删除前先找依赖
假设准备从 orders 删除已经废弃的 legacy_code。执行 DDL 前,应检查作业 SQL、转换规则、Sink 字段映射以及其他消费者是否仍依赖它,并确认历史查询是否还需要该字段。
确认进入删除窗口后,源端 DDL 可以是:
ALTER TABLE orders
DROP COLUMN legacy_code;
预期结果
DDL 执行成功后,源表 orders 的新 Schema 不再包含 legacy_code。这并不保证 CDC 作业自动适配。若 Sink 不支持删除列,或者作业仍按固定 Schema 读取 legacy_code,应先修改下游,再执行源端删除。对于需要保留历史字段的分析表,也可以选择让目标端继续保留该列,只是不再从新的源记录更新它,但必须明确旧值与新记录缺失值分别代表什么。
重命名优先采用兼容窗口
直接执行重命名虽然简洁,却要求 Source、Schema Evolution、转换层和 Sink 都正确理解这次变化。例如在支持相应语法的 MySQL 环境中,可以执行:
ALTER TABLE orders
RENAME COLUMN customer_name TO buyer_name;
预期结果
DDL 执行成功后,源表使用 buyer_name,customer_name 不再作为列名存在。生产链路不能仅依据这条 DDL 的结果推断目标端也会原地改名。若目标系统把变化表现为旧字段退出、新字段加入,直接切换可能导致历史查询断裂,甚至出现两个字段分别承载变更前后数据的情况。
更稳妥的做法是建立兼容窗口:先新增 buyer_name,在业务写入或受控转换中让新旧字段保持一致;再让 CDC 目标和消费者逐步切换到新字段;确认没有旧字段读者后,最后删除 customer_name。这样每个阶段都存在明确的回退点。
验证不能只看作业是否 Running
Schema 变更后,应写入一条新记录并从目标端按主键查询,验证字段名称和值都符合预期。还要抽查变更前的历史记录,确认旧字段数据没有因为目标端重建、映射调整或默认值处理而被错误解释。
如果目标端保留新旧两列,验收条件应明确到字段级:兼容期内新写数据两列是否一致;消费者是否已经全部读取新列;旧列停止更新后是否仍有查询依赖。只有这些条件满足,才进入最终删除阶段。
删除列适合“先消除依赖,再删除”,重命名列则更适合“先建立新名字,再迁移依赖,最后退出旧名字”。这种分阶段方式虽然比一次 DDL 多几步,却能把不可见的 Schema 兼容问题变成每一步都可验证的迁移过程。