
大数据与流处理 / 系统课时
调节快照读取并行度
调节快照读取并行度
增量快照可以把大表拆成多个数据块并行读取,从而缩短首次全量阶段,但并行度越高,对数据库连接、磁盘 I/O 和 Flink 资源的压力也越大。本课通过一个 MySQL CDC 表理解并行快照怎样工作,并建立从低并行度开始调优的策略。
学习目标
- 理解增量快照拆分数据块并并行读取的基本机制
- 能配置并验证快照读取所需的并行度
- 能结合源库压力、数据规模和 Flink 资源逐步调整参数
并行快照并不是多线程扫同一段数据
启用增量快照后,Flink CDC 会按照可用于切分的键把表划分为多个 chunk。多个 Source Reader 可以分别读取不同 chunk,随后再进入持续读取变更日志的阶段。这样做的关键不是让多个任务重复扫描整张表,而是把可独立处理的数据范围分配给不同读取任务。
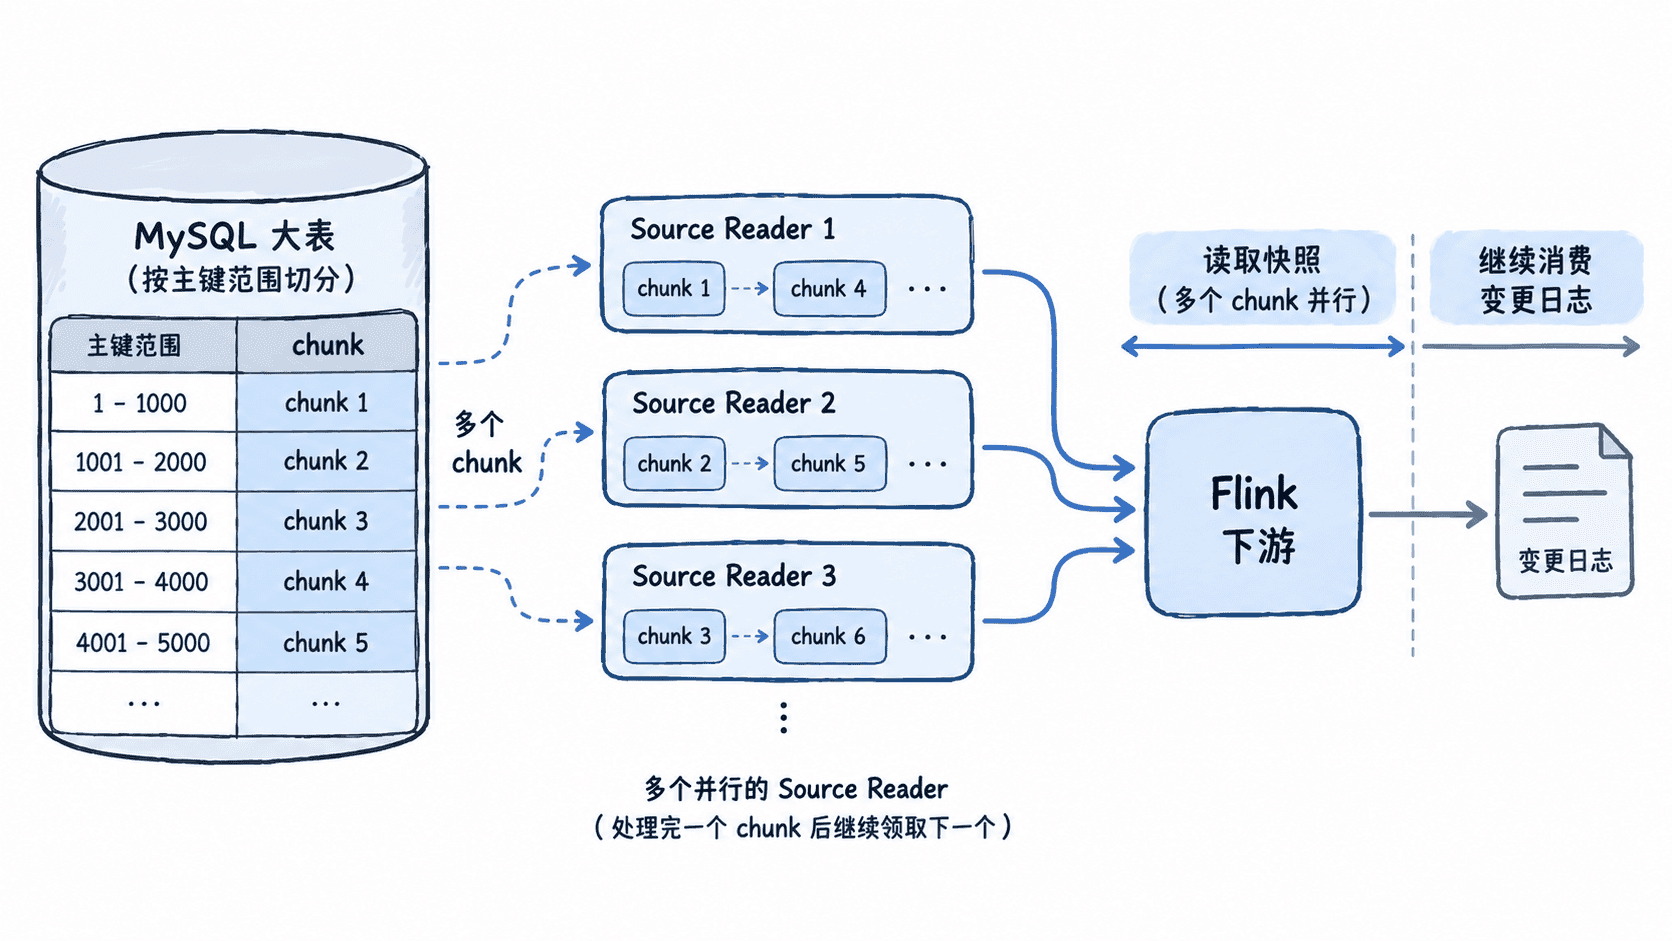
并行度因此决定的是同时有多少读取任务工作,chunk 大小决定的是单个切片包含多少行附近的数据量。两者不能混为一个参数:增加并行度可能提高吞吐,而减小 chunk 则主要改变任务粒度、单次查询范围和调度数量。
配置一个可并行读取的 CDC Source
下面以 Flink SQL 的 MySQL CDC Source 为例。scan.incremental.snapshot.enabled 开启增量快照,scan.incremental.snapshot.chunk.size 控制切片大小。实际并行任务数量由作业并行度决定,因此示例先把默认并行度设为 4。
SET 'parallelism.default' = '4';

CREATE TABLE orders_source (
    id BIGINT,
    customer_id BIGINT,
    amount DECIMAL(12, 2),
    updated_at TIMESTAMP(3),
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '<HOST>',
    'port' = '3306',
    'username' = 'flink_cdc',
    'password' = '<PASSWORD>',
    'database-name' = 'shop',
    'table-name' = 'orders',
    'scan.incremental.snapshot.enabled' = 'true',
    'scan.incremental.snapshot.chunk.size' = '8096'
);

SELECT COUNT(*) FROM orders_source;
预期结果
<count>
<ROW_COUNT><HOST>、<PASSWORD> 和 <ROW_COUNT> 需要替换或以实际环境结果为准。CDC 查询是持续运行的动态查询,控制台是否立即展示最终计数取决于客户端执行方式;更可靠的验证方法是同时查看 Flink Web UI 中 Source 算子的并行子任务以及源库连接和负载变化。
并行度应该从数据库承受能力反推
快照阶段的瓶颈不一定在 Flink。四个 Reader 同时扫描 MySQL,意味着源库可能同时承担更多查询、连接、磁盘读取和缓冲池竞争。如果数据库本身已经接近 I/O 或连接上限,把并行度从 4 提到 16 可能让业务 SQL 延迟上升,CDC 自身反而更慢。
调节时可以先选择较低并行度,例如 2~4,记录快照耗时以及源库 CPU、磁盘 I/O、活跃连接和业务查询延迟。如果数据库仍有明显余量,再逐级提高并行度并重复观察。只有快照吞吐确实随并行度提升且业务负载仍稳定,增加并行度才有收益。
表大小也不是唯一依据。一个数亿行但存储性能充足、业务低峰运行的表可以承受较高并发;一个数据量较小却处于高峰期的核心交易库,反而应该保守读取。
chunk 大小和并行度要分开调整
如果单个 chunk 很大,Reader 完成一次扫描需要较长时间,任务之间可能出现明显长尾;如果 chunk 过小,则会产生更多切片和查询调度开销。应先使用合理的 chunk 大小保证切分粒度,再调整 Reader 并行度,而不是同时大幅修改两个变量,否则很难判断吞吐变化来自哪里。
当提高并行度后快照耗时不再明显下降,或者源库 I/O、连接数、查询延迟已经显著上升,就应停止继续加并行度。合理策略不是追求最大的并发数字,而是在可接受的源库影响下完成足够快的初始快照。