
大数据与流处理 / 系统课时
给 CDC 作业设并行度
给 CDC 作业设并行度
CDC 作业的并行度不是越高越快。Source 能否并行读取、表的数量与变更速率、转换算子的成本以及 Sink 的写入能力都会形成不同瓶颈。本课建立一套从吞吐和背压出发的设置方法,让扩容发生在真正受限的阶段。
学习目标
- 区分 Source、处理中间算子和 Sink 的并行度约束
- 根据表数量、变更速率和下游吞吐定位需要扩容的位置
- 使用 Flink 指标与执行计划验证并行度调整是否有效
不要把全链路设成同一个数字
一个典型 CDC 数据链路至少包含 Source、转换算子和 Sink。三段承担的工作不同:Source 受连接器读取模型和源数据库能力约束,中间算子受反序列化、计算和网络 Shuffle 影响,Sink 则受目标数据库、消息系统或存储服务吞吐限制。
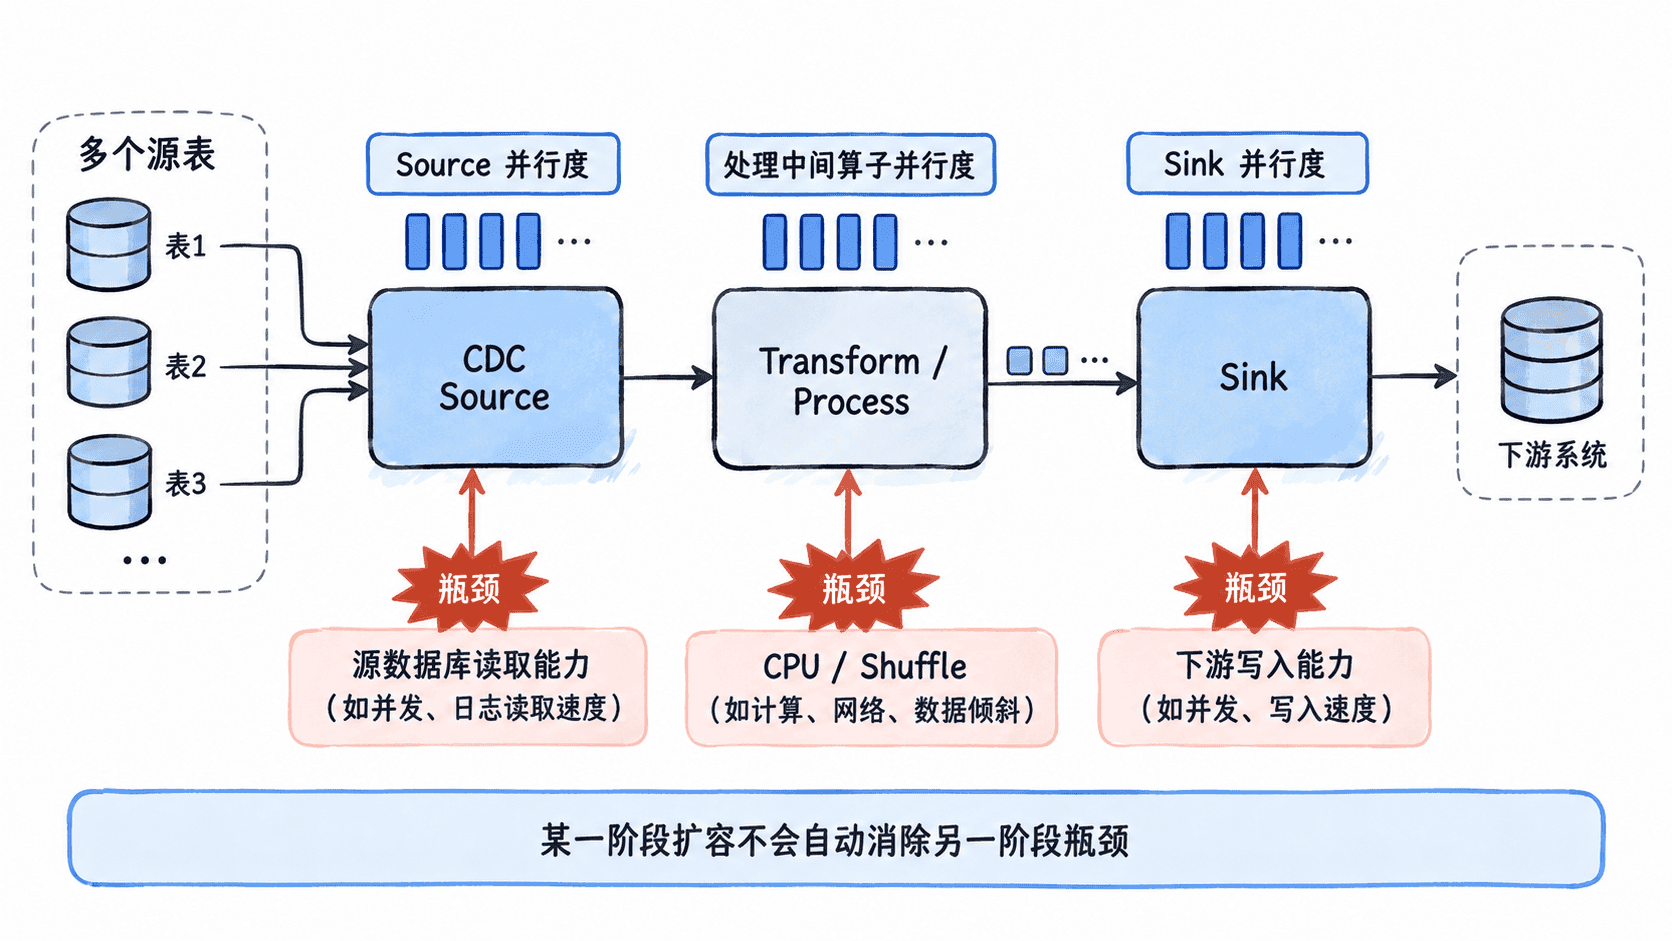
因此,全局 parallelism.default 适合作为默认值,却不能代替逐段容量判断。尤其是 CDC Source,实际可利用的并发能力取决于具体连接器、读取阶段以及版本支持;把作业并行度从 4 改成 16,并不意味着数据库日志读取吞吐会变成四倍。
从基线并行度开始运行
生产调优前应先建立可比较的基线。下面用 Flink CLI 提交一个已经打包的 CDC 作业,并显式指定默认并行度。-p 是 Flink 作业提交时的并行度参数;JAR 路径按实际部署替换。
flink run -p 4 <PATH>/cdc-job.jar预期输出会包含提交成功的 Job ID,实际 ID 不同:
Job has been submitted with JobID <ID>这个数字只是起点。运行后要观察每个算子的吞吐、忙碌程度、背压、输入输出速率以及 Sink 写入延迟。如果 Source 输入速率没有提高而 Sink 已持续背压,继续增加 Source 相关并行度通常没有意义。
用瓶颈决定扩哪里
表数量多并不直接等于需要同等数量的 Source 并行实例。应先看这些表能否由连接器并发执行快照、增量阶段是否具备相同的并发模型,以及源数据库能够承受多少读取压力。大量低频表和少量高频表对资源的需求完全不同。
处理中间算子如果长期处于高忙碌状态,而上下游仍有余量,可以提高该阶段并行度。涉及 keyBy 等重分区时,还要关注热点键;热点无法仅靠增加并行实例解决,因为大量记录仍可能落到少数 Subtask。
Sink 出现持续背压时,应先确认目标端是否已经接近写入上限。若目标数据库的连接数、事务提交或磁盘已经饱和,提高 Sink 并行度只会制造更多并发请求,甚至降低整体稳定性。
| 观察现象 | 优先检查 | 调整方向 |
|---|---|---|
| Source 忙且下游空闲 | 源端读取能力、连接器并发模型 | 在连接器支持范围内提高 Source 能力 |
| 中间算子忙、CPU 高 | 计算成本、数据倾斜 | 增加算子并行度或消除热点 |
| Sink 持续背压 | 目标端吞吐、批量和连接能力 | 先解除下游瓶颈,再评估扩容 |
| 全链路利用率低 | 输入变更速率 | 不为闲置吞吐盲目扩容 |
调整后验证是否真的变快
一次只调整一个主要变量,并在相同业务负载下比较前后指标。重点不是“并行度数字变大”,而是输入积压能否下降、端到端延迟能否稳定、Checkpoint 是否仍能按预期完成,以及源端和目标端有没有出现新的资源压力。
如果提高并行度后吞吐几乎不变,应回到执行图定位限制点,而不是继续翻倍扩容。并行实例增加还意味着更多网络连接、状态实例和 Checkpoint 数据,资源成本会同步上升。