
大数据与流处理 / 系统课时
同步延迟突然升高怎么查
同步延迟突然升高怎么查
CDC 延迟突然升高时,不要先调并行度或重启任务。真正要解决的是判断数据堵在源库读取、Flink 算子、checkpoint,还是 Sink。沿数据链路逐段观察吞吐、反压和 checkpoint,可以把“任务变慢”缩小成一个可验证的故障点。
学习目标
- 按数据链路定位 CDC 延迟发生在哪一段
- 区分源端读取、反压、checkpoint 与 Sink 吞吐问题
- 用 Flink REST API 和任务指标验证定位结果
先确定延迟发生在哪里
排查前先明确“延迟”的口径。业务看到目标库数据晚到,只能证明端到端延迟增加,并不能直接证明 CDC Source 读取慢。一次典型链路至少包含源数据库、CDC Source、Flink 算子、checkpoint 协调以及 Sink。
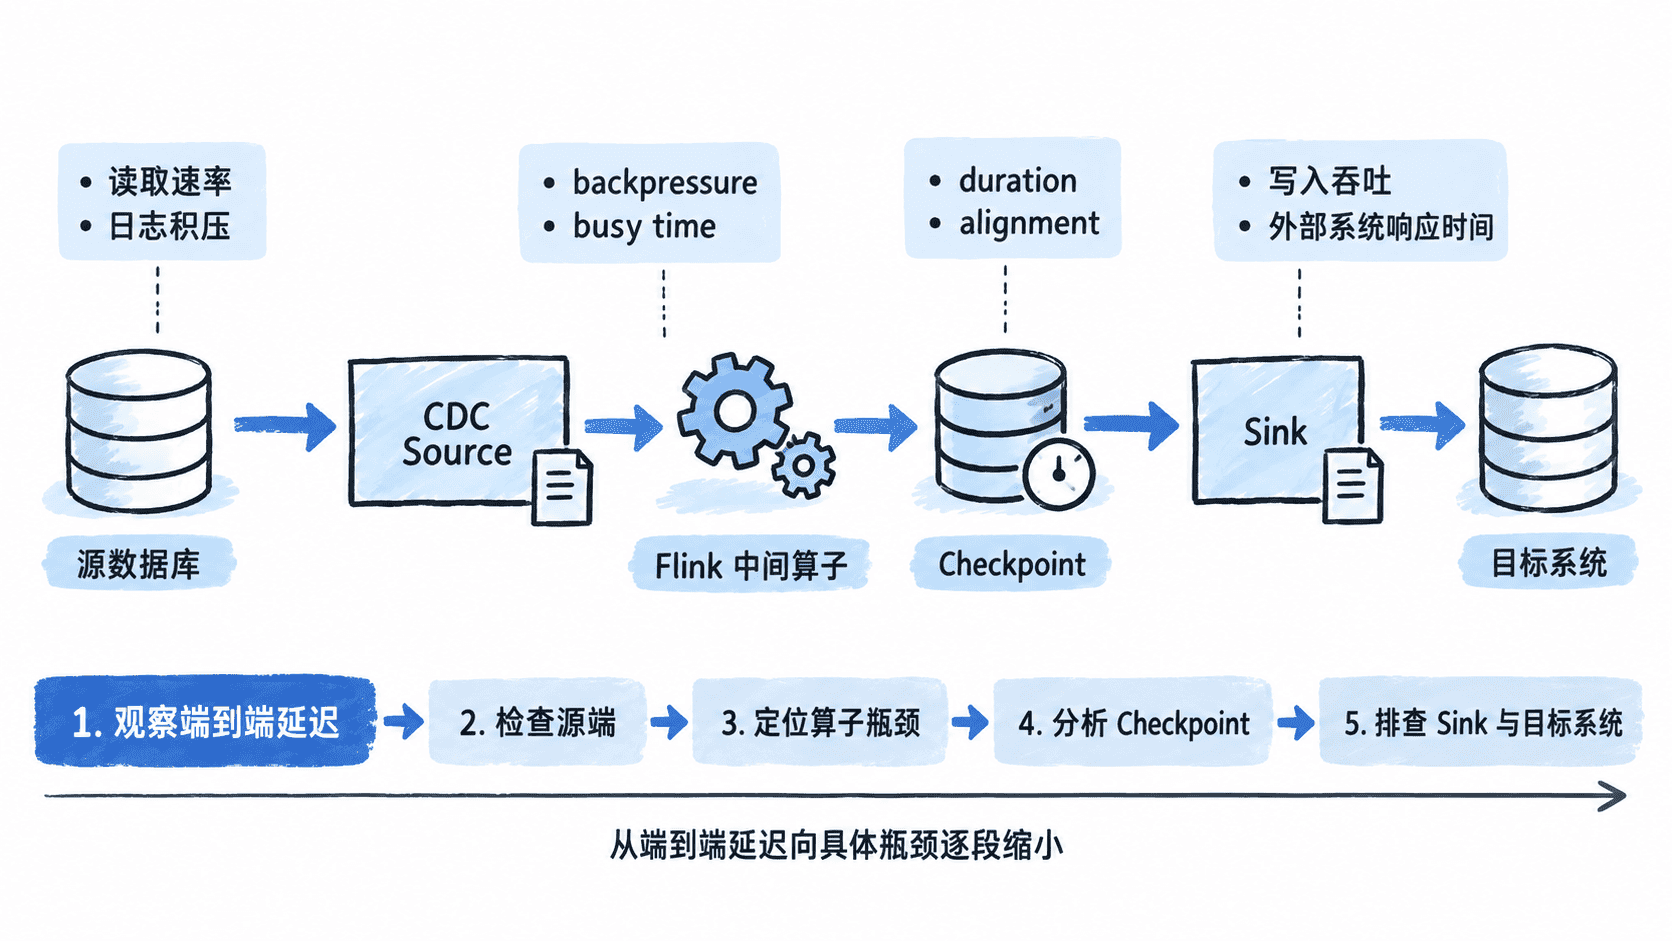
先记录延迟开始升高的时间 <TIME>,再对齐源库负载、Flink 指标和目标系统监控。如果只有 Sink 写入速率下降而 Source 仍持续消费,问题通常在下游;如果 Source 自身读取速率已经下降,则应优先检查源库和日志读取链路。
用反压确定是否堵在 Flink 内部
Flink Web UI 可以直接观察算子的 Back Pressure,也可以通过 REST API 查询指定 Job 的反压状态。下面的命令适合在能够访问 JobManager REST 地址时快速检查;<HOST>、<PORT> 和 <ID> 替换为实际值。
curl -s "http://<HOST>:<PORT>/jobs/<ID>/vertices/<ID>/backpressure"预期输出
{"status":"ok","backpressure-level":"low","end-timestamp":<TIME>}实际响应还会包含各 subtask 的反压信息,具体字段会随 Flink 版本有所差异。如果下游算子持续高反压,而上游吞吐随之下降,应沿算子链向下寻找第一个处理能力不足的节点。Sink 高反压尤其常见于目标数据库写入变慢、连接池不足、批量参数不合理或外部服务限流。
把 checkpoint 抖动单独检查
checkpoint 变慢会增加状态持久化成本,严重时还可能与反压相互放大。应重点比较故障前后的 checkpoint duration、失败次数,以及存在对齐阶段时的 alignment 指标,而不是只看任务是否仍为 RUNNING。
可以通过 REST API 查看 checkpoint 概况:
curl -s "http://<HOST>:<PORT>/jobs/<ID>/checkpoints"预期结果是返回包含 checkpoint 计数、最近 checkpoint 和历史 checkpoint 信息的 JSON;具体耗时和 ID 属于动态值,例如:
{"counts":{"restored":0,"total":<ID>,"in_progress":0,"completed":<ID>,"failed":0}}如果延迟升高与 checkpoint duration 同时突增,应继续检查状态大小、checkpoint 存储性能、网络以及反压。如果 checkpoint 指标稳定,则不要把时间耗在 checkpoint 参数调优上。
区分源库慢和 Sink 慢
源库侧重点检查事务日志产生速度、CDC 读取位置是否持续推进,以及数据库自身的 CPU、I/O、锁等待和复制相关负载。若日志持续产生但 Source 读取位置推进明显变慢,同时 Flink 下游没有反压,才更像源端读取链路问题。
Sink 侧则看写入吞吐、请求耗时、失败重试和目标系统资源。如果 Sink 的处理时间上升,并伴随上游反压,优先检查目标数据库慢 SQL、锁竞争、连接数、批量写入大小或外部接口限流,而不是盲目增加 Source 并行度。
修复后验证是否真正恢复
修复不能只以 Job 恢复 RUNNING 为标准。至少观察一个稳定窗口,确认积压持续下降、Source 与 Sink 吞吐重新匹配、反压恢复正常,并且 checkpoint duration 回到正常区间。若只是延迟不再增长但历史积压没有减少,说明系统当前吞吐只能追平新增数据,还没有能力消化积压。
排查 CDC 延迟的关键不是猜哪个组件“最可能慢”,而是沿源库读取、Flink 处理、checkpoint 和 Sink 写入逐段建立证据。找到第一个异常环节后再调整资源或参数,才能避免一次延迟问题演变成无效扩容和反复重启。