
大数据与流处理 / 系统课时
重启后数据对不上怎么办
重启后数据对不上怎么办
CDC 任务重启后出现源端与目标端数据不一致,不应直接归因于“丢数据”。需要先确定 checkpoint 恢复位置,再区分重复消费、目标端重复写入、业务仍在变化以及核对窗口错误,最后用固定时间窗口验证修复结果。
学习目标
- 建立从 checkpoint、日志位点到目标端写入的定位顺序
- 区分少数据、多数据和同主键内容不一致的不同根因
- 使用冻结时间窗口和主键级核对验证恢复结果
先把“不一致”分类
重启后的数据差异至少分成三类:目标端记录少于源端、目标端记录多于源端、记录数相同但字段值不同。三类现象对应的排查重点不同,先分类可以避免一开始就翻大量日志。
如果任务启用了 checkpoint,正常恢复会从最近一次成功 checkpoint 保存的状态继续处理。checkpoint 之后已经读取但尚未形成可恢复状态的事件可能被再次消费,因此 CDC 链路通常需要目标端写入具备幂等或可安全重放能力。
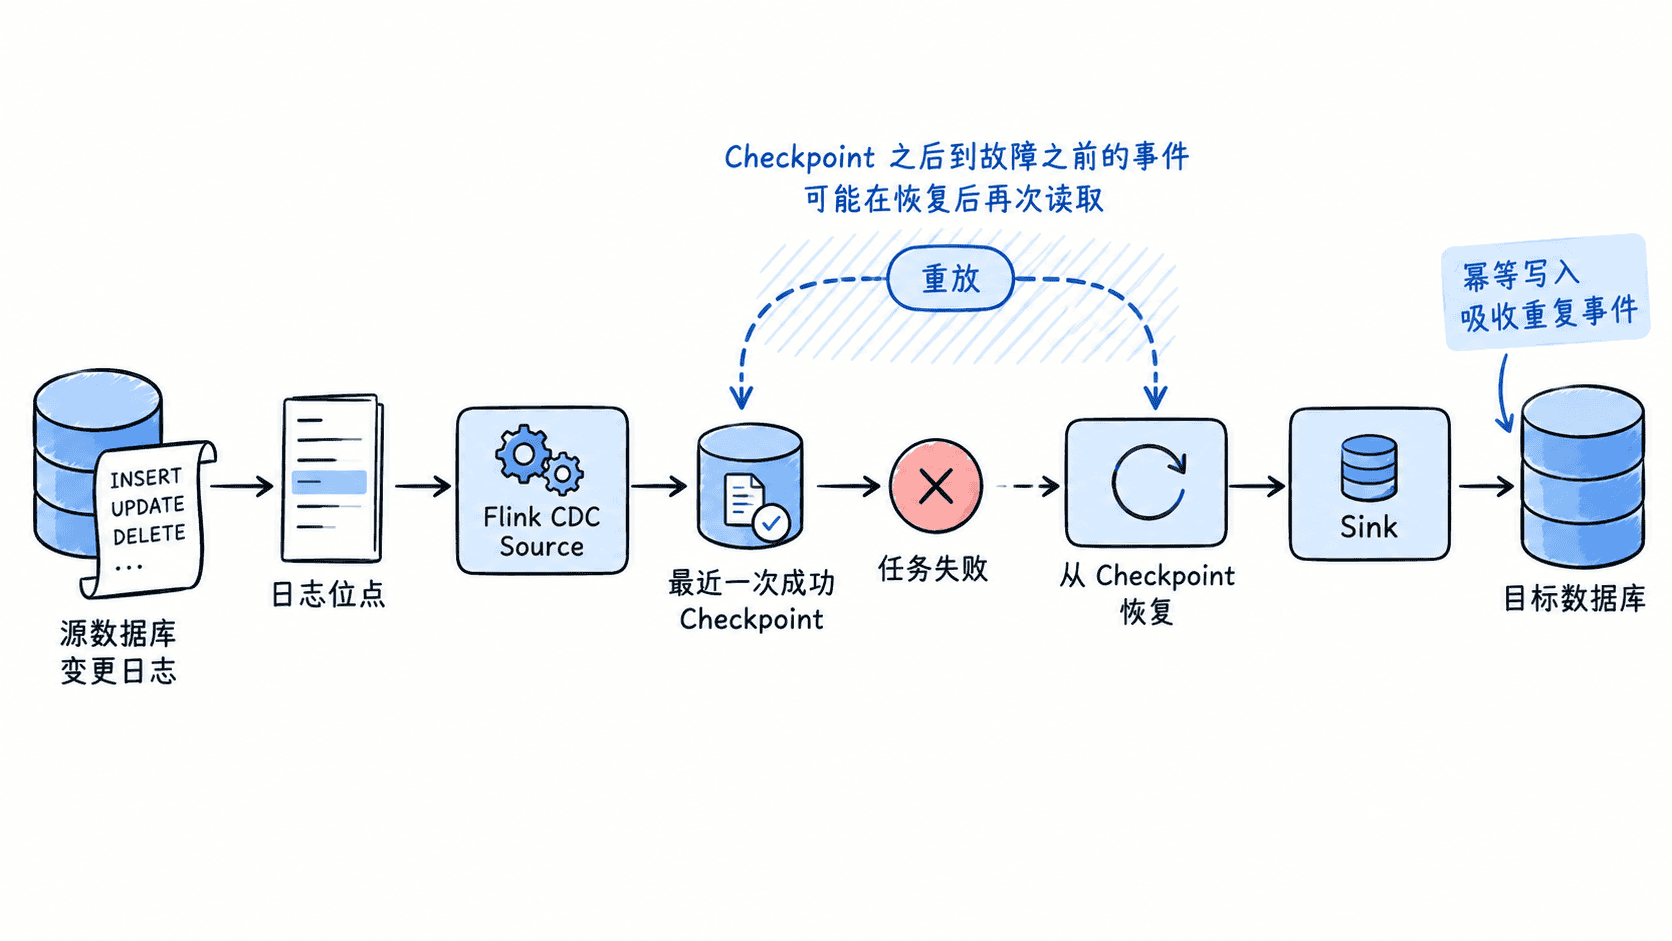
先确认实际恢复点
第一步不是比较总行数,而是确认任务是否真的从预期 checkpoint 恢复。使用 Flink CLI 查看作业状态,再结合 JobManager 日志确认恢复信息。下面命令中的 <ID> 和 <PATH> 应替换为实际值。
./bin/flink list -a
./bin/flink info <PATH>
grep -Ei "checkpoint|restore|recover" <PATH>/jobmanager.log | tail -n 50
预期输出
<ID> : <JOB_NAME> (RUNNING)
...
<恢复相关日志,实际内容因 Flink 版本和部署方式不同而不同>
flink list -a 用于确认任务是否已经运行;日志用于确认是否发生 checkpoint 恢复。不要依赖示例中的日志文本做精确匹配,因为不同 Flink 版本、State Backend 和部署环境的恢复日志并不完全一致。
如果没有从预期 checkpoint 恢复,而是重新执行初始快照或从其他保存点启动,核对范围必须重新定义。此时首先修正恢复方式,再讨论数据差异,否则后续比对没有统一基准。
按差异方向寻找根因
目标端“少数据”时,重点检查恢复位点是否越过了尚未成功落库的事件、Sink 是否持续失败,以及目标表是否存在过滤或约束拒绝。还要确认任务恢复后是否已经追平源端日志,不能在仍有明显延迟时提前核对。
目标端“多数据”通常与重放和非幂等写入有关。例如同一业务事件恢复后再次到达 Sink,如果目标端采用普通 INSERT 且没有唯一键约束,就可能生成第二条记录。若按主键 UPSERT,相同主键的重放通常只会覆盖已有行。
记录数一致但字段不同,则应检查更新事件的顺序、转换逻辑以及核对期间源表是否仍在变化。用“现在的源表”与“几分钟前的目标表”直接比较,本身就可能得到假差异。
固定窗口再做数据核对
可靠核对需要建立一致的业务窗口。例如选择已经不会再变化的历史时间段,按主键比较数量、缺失集合和关键字段。以下 SQL 是片段示例,假设源端和目标端都能访问结构一致的 orders 表,并存在业务时间 updated_at。
SELECT COUNT(*) AS row_count
FROM orders
WHERE updated_at >= '<TIME_START>'
  AND updated_at < '<TIME_END>';
预期结果
源端与目标端在同一固定时间窗口得到可比较的 row_count;具体数值取决于实际数据。仅数量相同还不够。生产排障应进一步按主键找缺失记录,并抽查金额、状态、更新时间等关键字段。数据量较大时可以分时间段或主键范围核对,避免一次全表扫描影响在线数据库。
修复后验证恢复能力
定位完成后,应在可控环境主动制造一次重启:等待 checkpoint 成功,写入一组具有明确主键的测试数据,重启任务,再等待任务追平。随后检查这些主键是否恰好形成预期最终状态,并观察 checkpoint 是否重新持续成功。
如果重复消费发生但目标结果仍正确,说明链路具备预期的重放容忍能力;如果每次重启都会新增重复行,就应优先修复 Sink 的幂等语义,而不是试图假设 CDC 永远不会重放。最终的数据核对应建立在“相同恢复基准、相同业务窗口、相同主键集合”之上。