
大数据与流处理 / 系统课时
设计一套订单同步拓扑
设计一套订单同步拓扑
订单 CDC 上线前,先把“同步哪些表、写到哪里、如何覆盖更新、失败后从哪里恢复”设计清楚。本篇以订单主表和明细表为例,形成一套可实施、可验证且支持故障恢复的 Flink CDC 拓扑。
学习目标
- 根据业务边界确定 CDC 表范围与目标模型
- 为订单数据选择与主键匹配的写入语义
- 把 Checkpoint、源端日志保留和恢复路径纳入拓扑设计
先确定同步边界
假设源库 shop 有 orders 与 order_items 两张核心表。订单状态、金额在创建后仍会更新,明细也可能发生修正,因此不能把 CDC 当成只追加的数据导入任务。
目标端采用与业务实体对应的 dw_orders、dw_order_items。两张目标表都保留稳定主键,使同一业务记录的 INSERT、UPDATE 和重复事件能够落到同一行,而不是不断追加副本。
CREATE TABLE dw_orders (
    id BIGINT PRIMARY KEY,
    customer_id BIGINT NOT NULL,
    status VARCHAR(32) NOT NULL,
    total_amount DECIMAL(12, 2) NOT NULL,
    updated_at TIMESTAMP NOT NULL
);

CREATE TABLE dw_order_items (
    id BIGINT PRIMARY KEY,
    order_id BIGINT NOT NULL,
    product_id BIGINT NOT NULL,
    quantity INT NOT NULL,
    updated_at TIMESTAMP NOT NULL
);
预期结果:目标库成功创建两张具有稳定主键的表,后续 Sink 可以依据主键执行更新或 Upsert。具体数据库显示文本可能不同。
dw_orders created
dw_order_items created把数据流和恢复路径放在同一张图里
完整拓扑不只是“数据库到数据库”。运行期间至少要同时考虑源数据库、CDC Source、Flink 作业、状态存储和目标端;恢复时还必须保证 Checkpoint 中保存的日志位置仍能在源端找到。
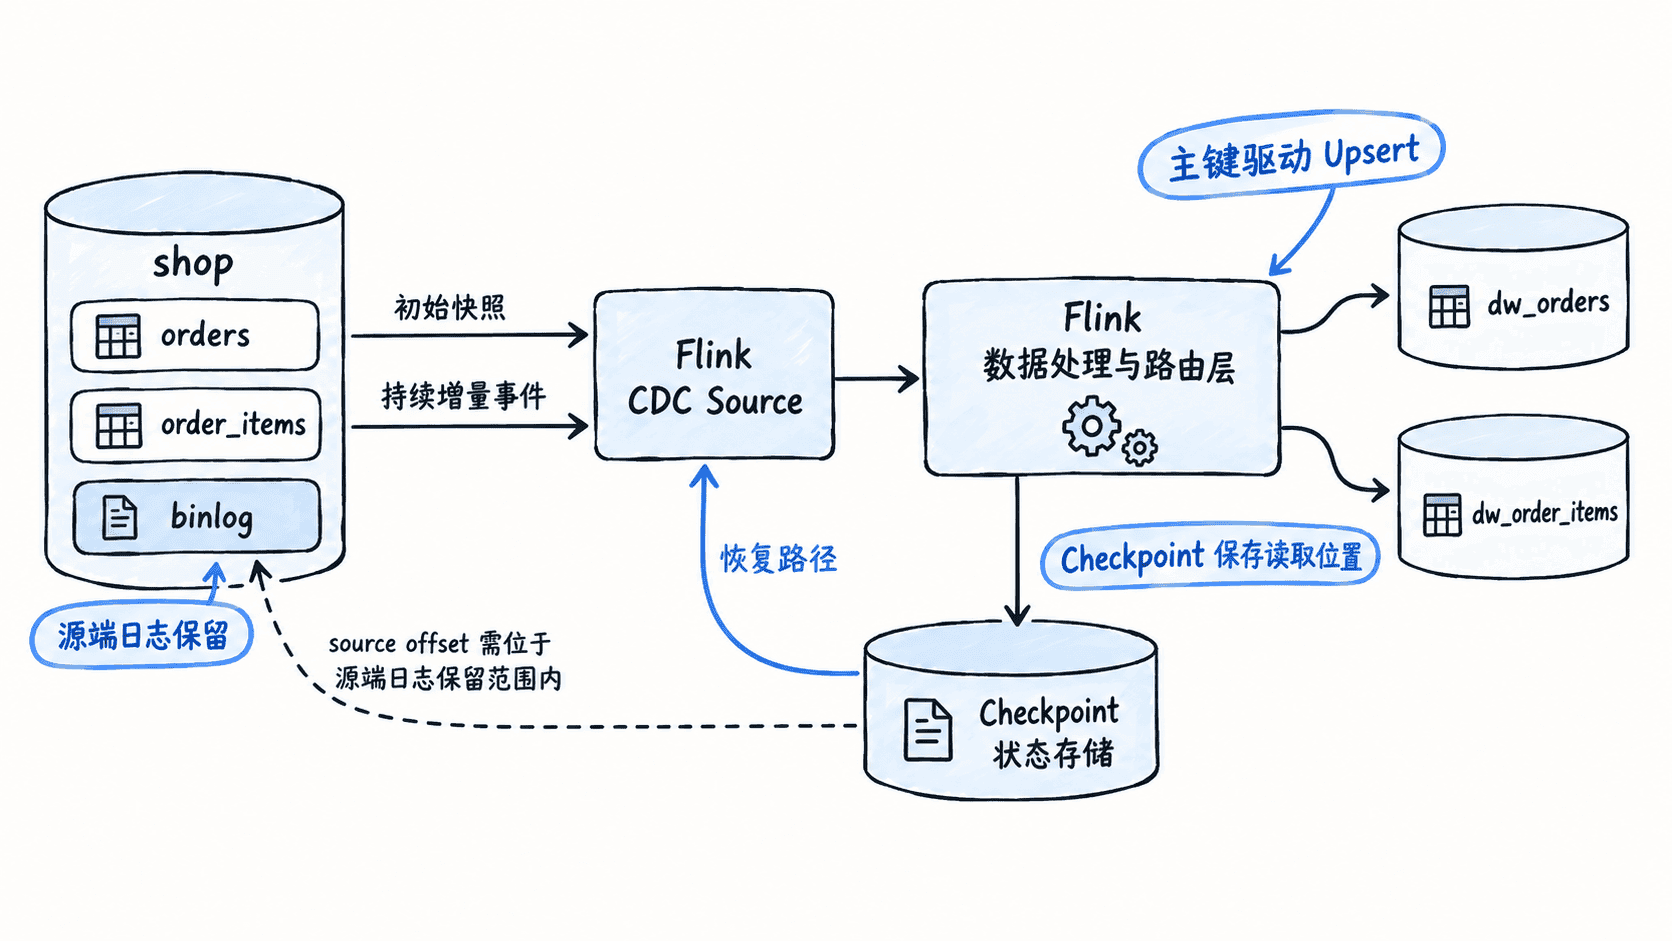
这里有两个不同的持久化对象。目标数据库保存业务同步结果;Checkpoint 保存 Flink 作业状态和 Source 读取位置。只备份目标表并不能让 CDC 在故障后知道应该从哪一条增量日志继续读取。
选择与变更模型匹配的写入语义
订单属于典型的可变实体。假设 id=1001 的订单状态从 CREATED 更新为 PAID,目标端应该覆盖同一主键的当前状态。若 Sink 采用纯追加语义,就可能同时留下两个版本,破坏“当前订单表”的含义。
因此设计时要明确三种变化:INSERT 创建目标行,UPDATE 按稳定主键更新现有行,DELETE 根据业务要求删除目标行或转换成软删除状态。具体 Sink 是否原生支持 Upsert 和 DELETE,需要按实际连接器能力确认。
把恢复条件写进设计
开启 Checkpoint 后,Flink CDC 可以把读取位置随状态一起持久化。故障恢复时,从最近成功的 Checkpoint 恢复,比无状态重新启动更容易保持增量连续性。但这个能力有一个外部前提:源数据库不能已经清理恢复点所需的 binlog。
设计阶段应同时确定 Checkpoint 存储的持久化位置、可接受的恢复时间,以及源端日志保留窗口。日志保留时间至少应覆盖预期最长停机与人工处置时间,并留出安全余量。
验收时不要只看作业是否显示 Running。应插入一条订单、更新其状态,再确认目标端同一主键只有一条最新记录;随后制造一次可恢复故障,从最近成功状态恢复,并再次更新订单。最终目标表应保持连续且不存在因重放产生的重复主键记录。
一套真正可恢复的订单 CDC 拓扑,需要同时闭合四件事:明确同步边界、保持稳定记录身份、使用正确的更新语义,以及让 Checkpoint 中的读取位置与源端日志保留策略相互匹配。