
大数据与流处理 / 系统课时
模拟失败后继续同步
模拟失败后继续同步
这一课通过一次可控的故障实验验证 Flink CDC 的恢复能力:先制造增量数据并建立恢复点,再停止作业、产生新的数据库变更,最后从保存的状态恢复,确认增量事件没有因为重启而从错误位置重新消费或永久丢失。
学习目标
- 能设计一次可重复的 Flink CDC 故障恢复实验
- 能区分无状态重启与从 Checkpoint、Savepoint 恢复
- 能从源表、目标表和作业状态共同判断恢复是否正确
先明确要验证什么
CDC 作业能否“重新启动”并不是关键,关键是恢复后 Source 的读取位置和算子状态是否来自一致的恢复点。对于支持 Checkpoint 的 Flink CDC Source,恢复状态会记录继续读取增量日志所需的信息;作业重新部署时若没有使用对应状态,就不能把它视为原作业的连续恢复。
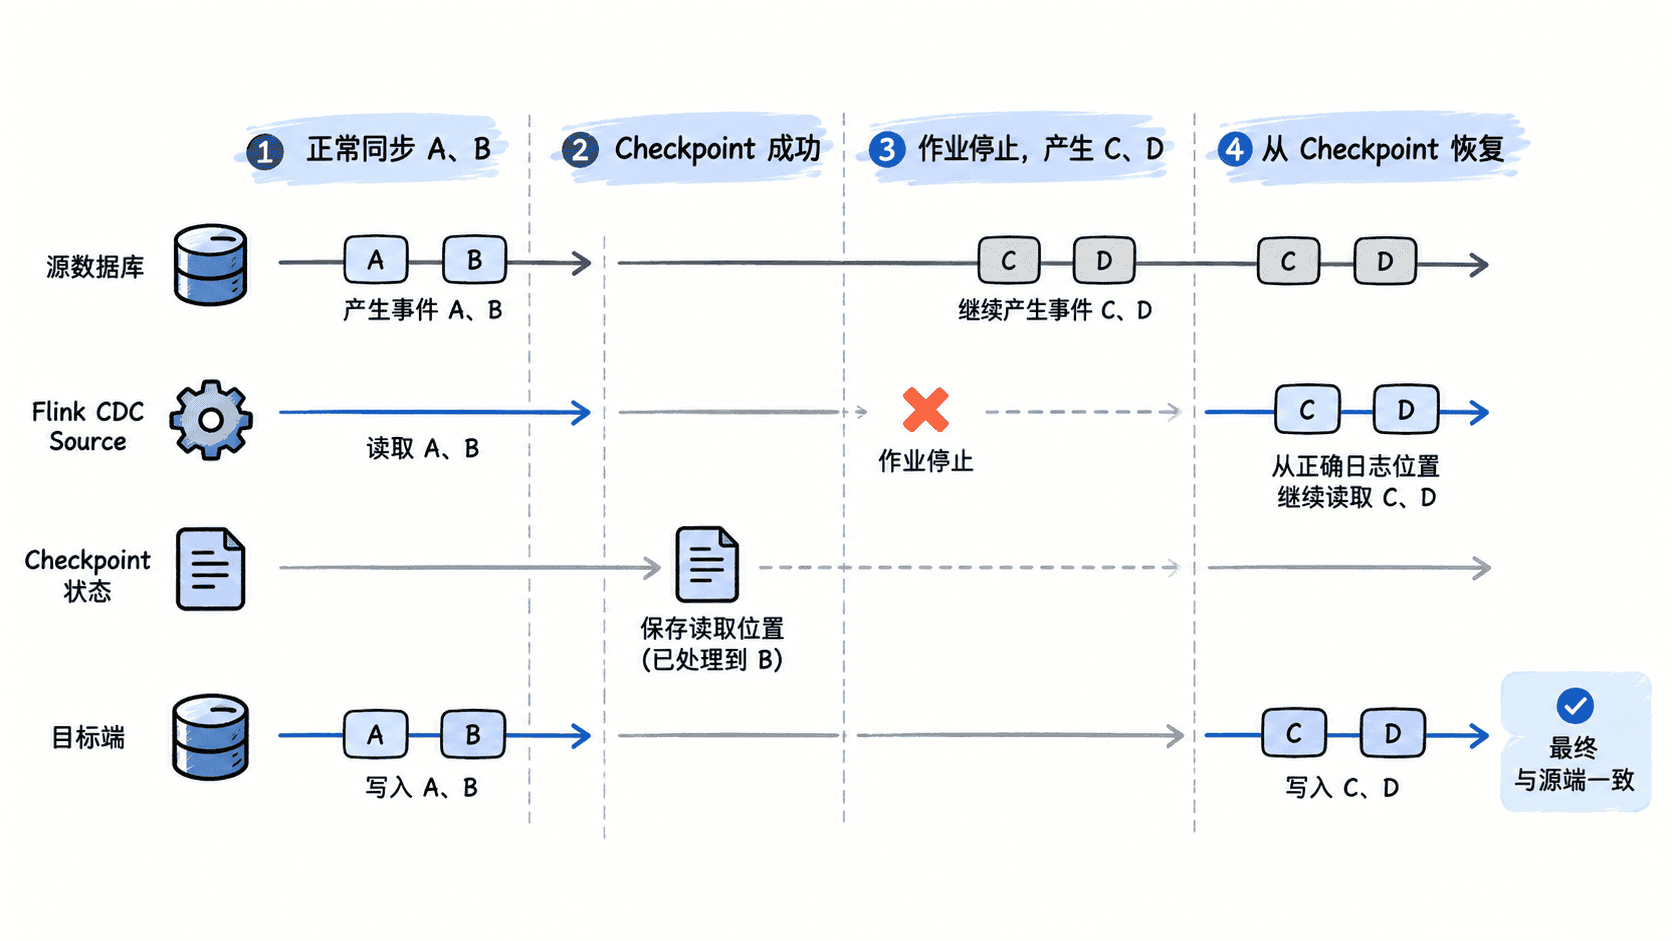
实验前应保证 Checkpoint 已启用,并使用持久化的 Checkpoint 存储。下面以 Flink CLI 为例查看正在运行的作业,实际 Job ID 会不同。
./bin/flink list -r预期输出
<TIME> : <ID> : <JOB_NAME> (RUNNING)记录 <ID> 后,再通过 Flink Web UI 或配置的 Checkpoint 存储确认最近一次 Checkpoint 已成功。时间、ID 和存储路径属于动态值,以实际环境为准。
制造一个可恢复的停止点
为了让实验边界清晰,可以使用 stop --savepointPath 让流作业先生成 Savepoint 再停止。Savepoint 是人工触发、用于受控运维的状态快照,比直接杀掉进程更适合第一次验证恢复流程。
./bin/flink stop --savepointPath <PATH> <ID>预期输出
Savepoint completed. Path: <PATH><PATH> 应替换为集群可访问的持久化存储位置。命令成功后,记录最终返回的 Savepoint 路径;恢复时必须使用实际生成的路径,而不是仅使用父目录。
接着在源数据库插入一条能唯一识别的测试记录。以下以 MySQL 表 orders 为例,表和字段需要替换为实验环境中实际存在的对象。
INSERT INTO orders (id, status) VALUES (90001, 'CREATED');预期结果
Query OK, 1 row affected此时作业已经停止,所以目标端不应立即出现 id = 90001。这条记录用于判断恢复后是否继续读取停机期间产生的增量日志。
从保存状态恢复作业
使用原作业 JAR 和刚才生成的 Savepoint 重新提交。下面命令假定 JAR 的入口和参数已经包含在作业包或提交配置中。
./bin/flink run -d -s <PATH> <JOB_JAR>预期输出
Job has been submitted with JobID <ID>这是恢复操作而不是一次全新的无状态启动。若算子 UID、并行度约束或作业拓扑发生了不兼容变化,Flink 可能拒绝恢复;此时不应为了让作业启动而直接丢弃状态,因为那会改变本次实验要验证的条件。
验证恢复后的增量位置
恢复完成后,先等待作业进入 RUNNING,再查询目标端是否出现停机期间写入的数据。假设目标也是支持 SQL 查询的数据库,可以执行:
SELECT id, status FROM orders WHERE id = 90001;预期结果
+-------+---------+
| id    | status  |
+-------+---------+
| 90001 | CREATED |
+-------+---------+
还要检查这条记录只出现一次,并继续在源端执行一次更新,确认恢复后新产生的事件也能继续流动。仅看到作业状态为 RUNNING 不能证明恢复正确;真正的验收条件是停机前的数据保持正确、停机期间的增量被补上、恢复后的新增量继续到达目标端。
一次可靠的恢复实验应同时保留 Savepoint 或 Checkpoint 标识、故障前后的测试记录以及目标端查询结果。这样即使随后发现重复或缺失,也能把问题定位到恢复点、Source 重放还是 Sink 写入阶段。