
大数据与流处理 / 系统课时
监控延迟和吞吐变化
监控延迟和吞吐变化
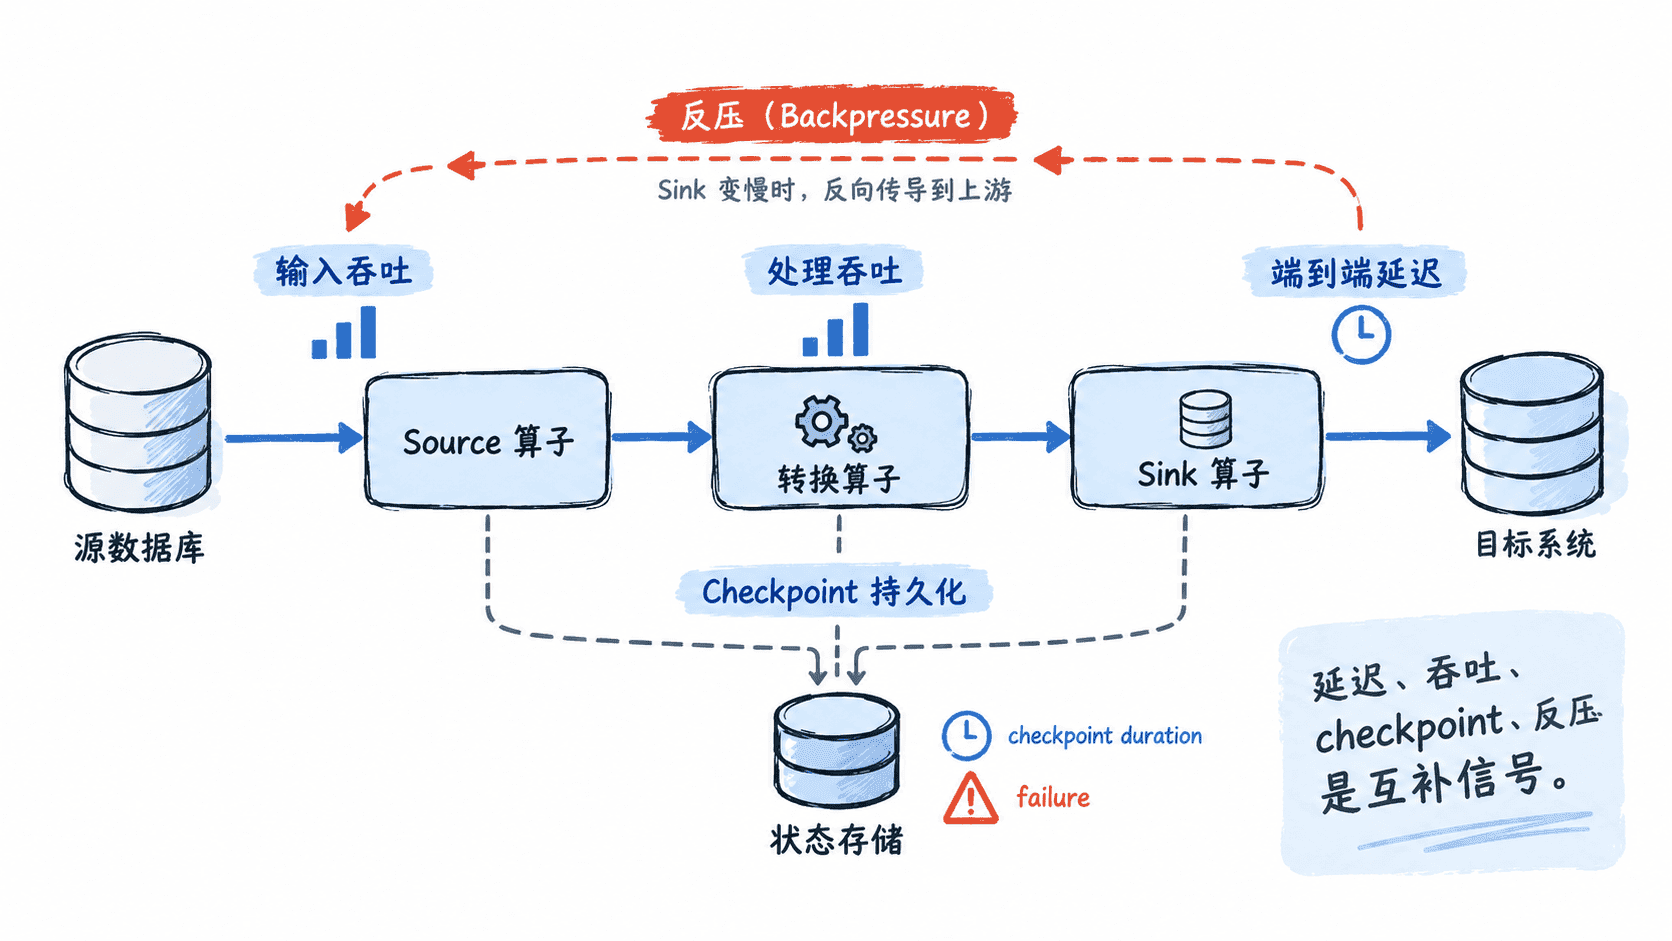
CDC 作业显示 RUNNING 并不代表同步链路健康。生产监控需要同时观察数据是否变慢、处理能力是否下降、checkpoint 是否恶化以及算子是否产生反压,才能区分流量增长、下游变慢和状态持久化异常。
学习目标
- 建立延迟、吞吐、checkpoint 与反压四类观察维度
- 理解指标之间的因果关系,避免只凭单一指标判断故障
- 使用 Flink REST API 获取作业指标并进行基础验证
从端到端健康度看指标
延迟回答“数据多久到达目标端”,吞吐回答“单位时间处理多少数据”。二者需要结合观察:吞吐升高且延迟稳定,通常意味着作业仍能跟上输入;输入持续高于处理能力时,积压扩大,端到端延迟会逐渐上升。
checkpoint 用来观察状态持久化是否稳定。持续变长或频繁失败可能与存储性能、状态规模、网络或反压有关。反压则说明某个下游算子的消费速度限制了上游,它更适合用于定位瓶颈位置,而不是单独代表业务同步延迟。
用 REST API 检查作业指标
Flink REST API 可以查询运行中作业的指标。先取得作业列表,再根据实际的 Job ID 查询具体指标。以下命令假设 JobManager REST 地址已经保存在 FLINK_REST 中。
set -eu

FLINK_REST="${FLINK_REST:-http://localhost:8081}"
curl -fsS "${FLINK_REST}/jobs/overview"预期输出的结构类似下面这样,<ID>、<TIME> 等动态值会因实际作业而不同:
{"jobs":[{"jid":"<ID>","name":"<JOB_NAME>","state":"RUNNING","start-time":"<TIME>","end-time":-1,"duration":"<DURATION>","last-modification":"<TIME>","tasks":{"total":<COUNT>,"created":0,"scheduled":0,"deploying":0,"running":<COUNT>,"finished":0,"canceling":0,"canceled":0,"failed":0,"reconciling":0,"initializing":0}}]}拿到 Job ID 后,可以继续查看 checkpoint 统计,也可以通过 /jobs/<ID>/vertices/<VERTEX_ID>/metrics 查询算子指标。指标名称会随 Flink 版本、连接器和算子而变化,因此应先请求可用指标列表,再选择要采集的指标,而不是在监控脚本中猜测名称。
用变化趋势判断瓶颈
监控的重点不是某个瞬时数值,而是多个信号在同一时间窗口中的变化关系。典型判断可以按以下顺序进行:
- 先确认业务端到端延迟是否持续上升,而不是一次短暂尖峰。
- 对比源端输入速率和各算子的处理速率,判断是否出现持续积压。
- 查看反压集中在哪个算子,确认瓶颈是否由下游向上游传播。
- 检查同一时间段的 checkpoint 时长、失败次数和完成间隔是否异常。
- 最后结合源数据库、网络和目标端的容量指标确认外部原因。
例如,Sink 处理能力下降时,常见链路是 Sink 先出现繁忙或反压,随后压力向上游传播,处理吞吐受限,积压继续增长,最终业务看到的同步延迟升高。若只盯着 Job 状态,就会错过这一过程。
为告警设置持续窗口
生产告警不宜把一次指标抖动直接判定为事故。更稳妥的方式是基于历史基线设置阈值,并要求异常持续一个合理窗口。例如端到端延迟连续多个采样周期超过业务目标,或 checkpoint 连续失败,再触发高优先级告警。
吞吐下降也不能脱离输入量判断:源端本身没有变更时,低吞吐完全正常。把延迟、输入速率、处理速率、checkpoint 和反压放到同一时间轴观察,才能从“作业还活着”提升到“同步链路确实健康”。