
单片机与物联网 / 系统课时
处理任务异常
处理任务异常
多任务程序一旦出现随机重启、某个任务长期无响应或看门狗复位,问题通常不在“任务数量太多”,而在栈空间、等待方式或让出 CPU 的策略。本课建立一条可重复的排查路径,并把任务改成可观测、可恢复的运行逻辑。
学习目标
- 根据串口现象区分栈溢出、任务阻塞与看门狗问题
- 使用栈高水位和任务运行节奏定位异常
- 通过有限等待、周期让出 CPU 和合理栈大小降低复位风险
先按症状缩小范围
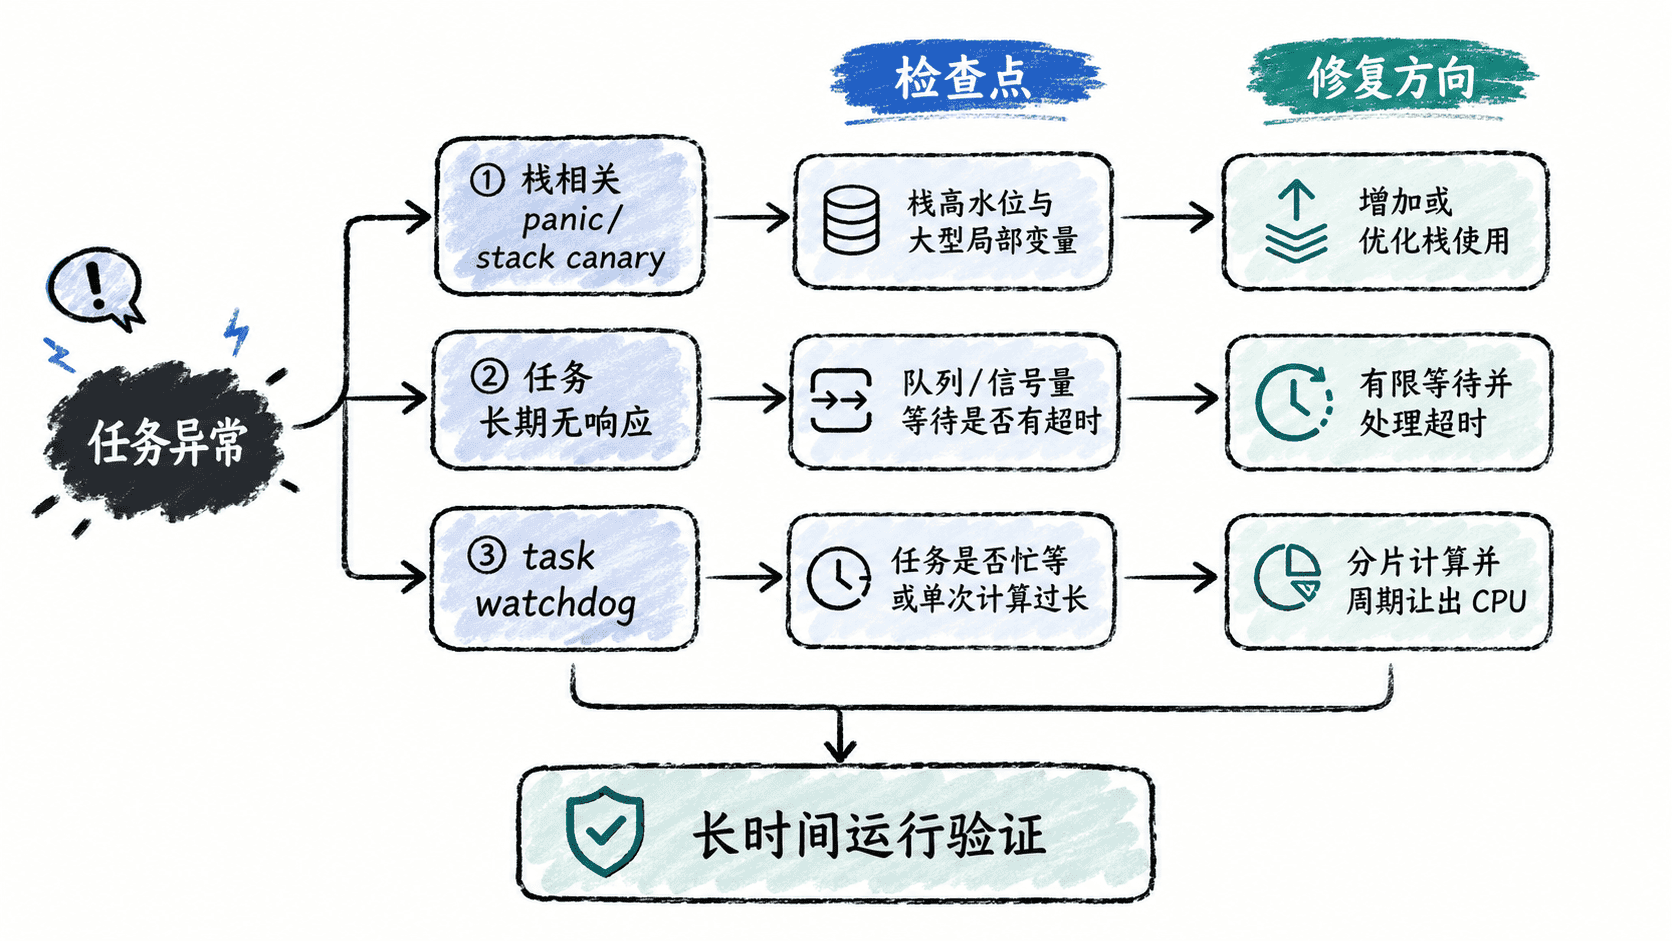
先不要急着增加栈或关闭看门狗。不同异常留下的线索不同,排查时应先确认“任务崩了、任务在等、还是任务一直占着 CPU”。
| 现象 | 优先怀疑 | 第一检查点 |
|---|---|---|
| 出现 stack canary、栈相关 panic 后重启 | 栈溢出 | 大型局部变量、递归、任务栈大小 |
| 某个功能不再推进,但系统仍能运行 | 无限等待或依赖未满足 | 队列、信号量、事件组的等待条件 |
| 运行一段时间后出现 task watchdog | 长时间忙等或单次计算过长 | 是否长期不阻塞、不延时、不让出 CPU |
用栈高水位观察风险
uxTaskGetStackHighWaterMark() 返回任务运行以来曾经出现过的最小剩余栈空间指标。这个值持续下降并接近零,说明任务的栈余量正在变得危险;如果只是盲目把栈改得很大,则可能掩盖大型局部数组、深层调用或递归等真正原因。
下面的完整 Arduino 示例创建一个工作任务,执行有界计算、打印栈高水位,并每秒主动阻塞一次。它同时提供“任务仍活着”和“栈余量是否稳定”两条观测信号。
#include <Arduino.h>

TaskHandle_t workerHandle = nullptr;

void workerTask(void *parameter) {
  for (;;) {
    uint32_t checksum = 0;

    // 把单次工作限制在可控范围内,避免长时间独占 CPU。
    for (uint32_t i = 0; i < 50000; ++i) {
      checksum += i;
    }

    UBaseType_t watermark = uxTaskGetStackHighWaterMark(nullptr);
    Serial.printf(
        "worker alive, watermark=%u, checksum=%lu\n",
        (unsigned)watermark,
        (unsigned long)checksum);

    // 周期性阻塞,让调度器和同核心的其他任务获得运行机会。
    vTaskDelay(pdMS_TO_TICKS(1000));
  }
}

void setup() {
  Serial.begin(115200);
  delay(500);

  BaseType_t created = xTaskCreatePinnedToCore(
      workerTask,
      "worker",
      4096,
      nullptr,
      1,
      &workerHandle,
      1);

  if (created != pdPASS) {
    Serial.println("task create failed");
  }
}

void loop() {
  vTaskDelay(pdMS_TO_TICKS(1000));
}
预期输出
worker alive, watermark=<VALUE>, checksum=1249975000
worker alive, watermark=<VALUE>, checksum=1249975000
<VALUE> 会随编译选项、调用路径和运行环境变化。关注的是它是否长期稳定且保有安全余量,而不是追求某个固定数字;如果不断逼近零,应先减少大对象的栈上分配或缩短调用深度,再评估是否需要增加任务栈。
区分阻塞与忙等
FreeRTOS 中“Blocked”本身并不是错误:调用 vTaskDelay(),或等待队列、信号量、事件组时,任务主动让出 CPU。真正危险的是等待条件永远不会发生,却使用无限等待;这会让业务逻辑看起来像“卡死”。对需要自恢复的链路,应优先设置有限超时,并在超时后记录状态、重试或回退。
另一类问题是忙等,例如任务在 for (;;) 中持续轮询条件却没有任何阻塞点。高优先级任务若长期占用某个核心,可能使同核心的系统任务或 Idle Task 得不到运行机会,最终触发任务看门狗。修复重点是缩短单次工作、把长计算拆成批次,并在合适位置使用 vTaskDelay()、队列等待或其他可阻塞机制,而不是单纯频繁“喂狗”。
验证修复是否真的有效
修复后应让设备覆盖原先最容易出问题的路径持续运行,并同时观察串口心跳、栈高水位和重启现象。若任务有队列或信号量依赖,还应主动制造“消息暂时不到达”的情况,确认超时分支能够恢复,而不是永久等待。
最终的判断标准不是“这次没有复位”,而是任务在压力和异常条件下仍会周期性让出 CPU、栈余量保持稳定、等待路径存在退出条件,并且设备能持续完成原本的业务工作。