
图形渲染与 Shader / 系统课时
渲染线程为何会堵住
渲染线程为何会堵住
渲染线程并不只是“调用一次 Draw”那么简单,它还要整理绘制命令、切换状态、准备资源,并把工作提交给图形驱动。当这些环节过多,或线程在同步点等待主线程、驱动甚至 GPU 时,渲染线程就会成为 CPU 侧瓶颈。本节目标是用时间线识别堵塞发生在哪一层。
学习目标
- 理解 Draw Call 提交、状态切换、资源准备对渲染线程的影响
- 能区分渲染线程自身计算慢与等待主线程、驱动或 GPU
- 能通过事件汇总快速定位最主要的渲染线程耗时类别
先看渲染线程的工作链
典型执行链可以概括为:主线程或任务系统准备可见对象,渲染线程组织并提交命令,驱动把命令转成 GPU 可执行工作,GPU 再异步消费队列。任意一层产生背压,时间线都可能在渲染线程上表现为长区块或等待。
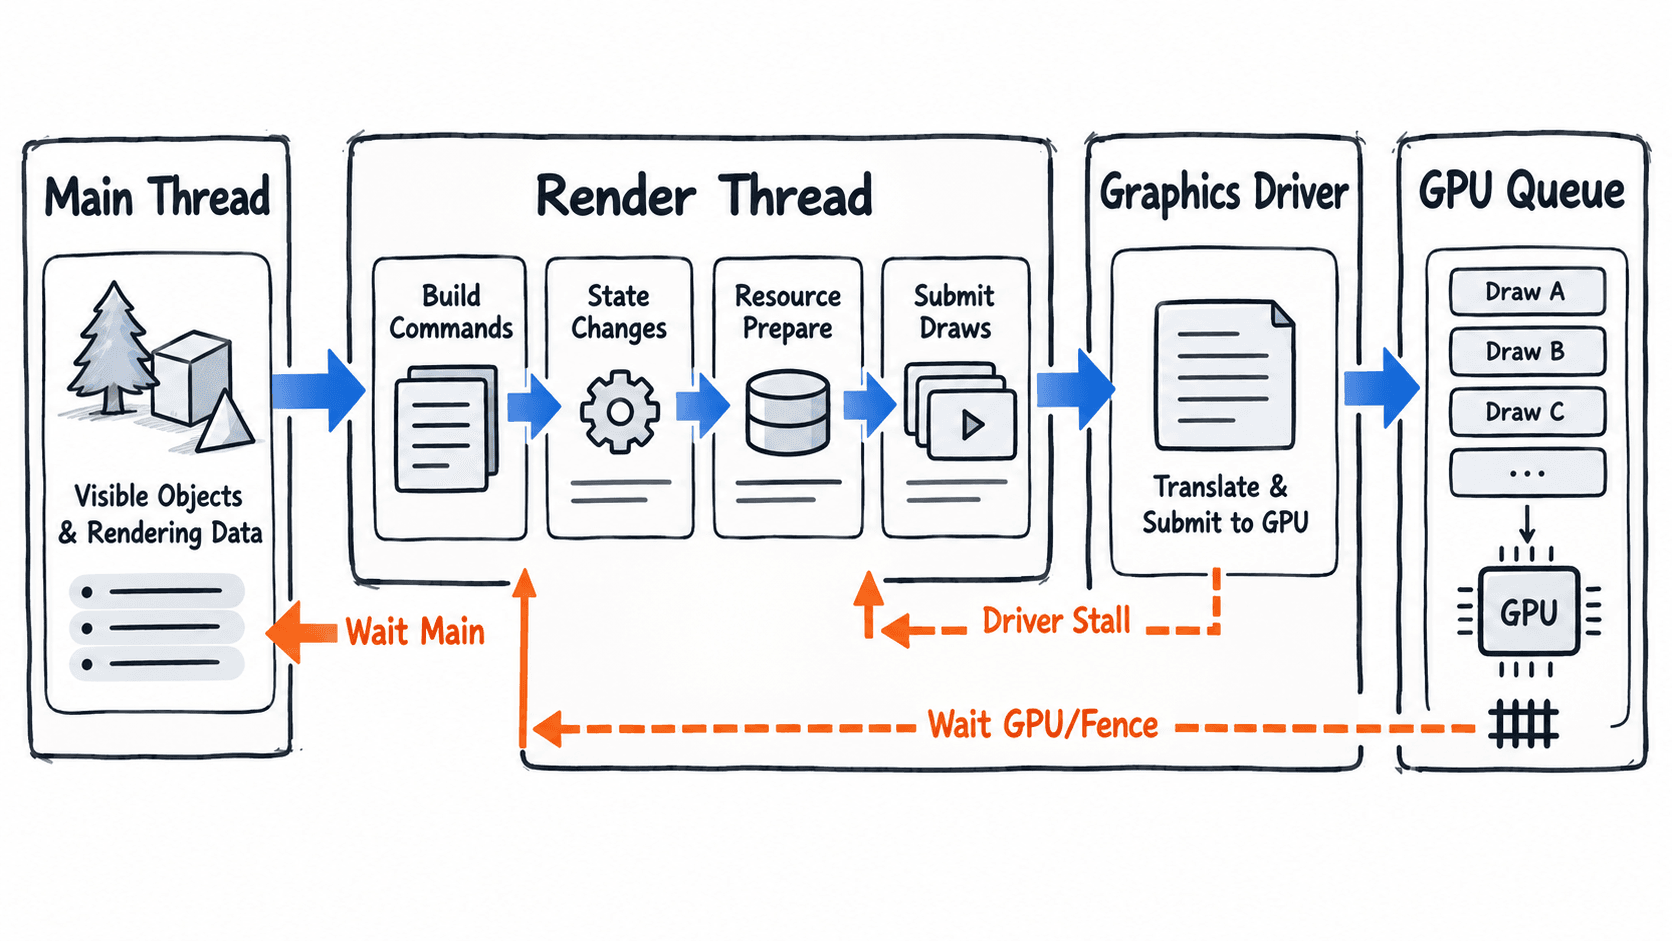
因此,看到渲染线程很长时,先判断它是在持续执行提交工作,还是大部分时间卡在等待。两者虽然都会拖慢 CPU 帧,但修复方向完全不同。
四类高频堵点
Draw Call 太多时,渲染线程会反复构建和提交命令,即使 GPU 每个 Draw 很快,CPU 侧的提交成本仍可能累计成明显热点。状态切换频繁则会增加管线、材质、纹理或绑定更新的管理成本,常见于排序不佳或对象材质过于碎片化的场景。
资源准备是另一类常见问题,例如在渲染关键路径上临时创建缓冲、上传纹理或触发资源转换。最后是同步:Fence、Present 前后的等待、资源可用性检查,或为了读取 GPU 结果而强制等待,都可能让渲染线程停止推进。
| 时间线现象 | 更可能的原因 | 验证方向 |
|---|---|---|
| Submit/Draw 区块持续很宽 | Draw Call 数量过多 | 降低可见对象数、合批后比较 CPU 渲染时间 |
| 状态设置区块碎且密集 | 材质、管线或资源切换过多 | 按材质或管线排序后比较切换次数 |
| 资源准备偶发尖峰 | 动态创建、上传或首次使用资源 | 预创建或异步准备后复测 |
| Wait/Fence 占据大段时间 | CPU-GPU 或线程间同步 | 查看等待对象和上游完成时间 |
不要只看 Draw Call 数量本身。两台机器、两个图形 API 或两种驱动的单次提交成本都可能不同,所以最终判断仍要回到“减少某类工作后,渲染线程总时长是否下降”。
用事件汇总确认最大耗时类别
当 Profiler 能导出事件名与持续时间时,可以先做一个最小汇总,避免被大量碎片事件干扰。下面脚本用一组示例事件演示如何统计各类别总耗时并找出最大项,可直接运行。
from collections import defaultdict

events = [
    ("SubmitDraws", 1.8),
    ("StateChanges", 0.9),
    ("ResourcePrepare", 0.6),
    ("SubmitDraws", 1.5),
    ("WaitGpuFence", 2.4),
]

totals = defaultdict(float)
for name, duration_ms in events:
    totals[name] += duration_ms

for name, duration_ms in sorted(totals.items(), key=lambda item: item[1], reverse=True):
    print(f"{name}: {duration_ms:.1f} ms")

hotspot = max(totals, key=totals.get)
print(f"hotspot: {hotspot}")
预期输出:
SubmitDraws: 3.3 ms
WaitGpuFence: 2.4 ms
StateChanges: 0.9 ms
ResourcePrepare: 0.6 ms
hotspot: SubmitDraws
真实项目中应把 events 替换为采集到的事件数据,并统一事件命名。这个汇总只能告诉你“哪类时间最多”,不能单独证明根因;例如 WaitGpuFence 很高时,根因通常在更早提交的 GPU 工作,而不是等待函数本身。
沿等待关系反查上游
如果渲染线程是执行型热点,就继续展开提交、状态设置和资源准备的子事件,观察累计次数与总耗时。如果它主要在等待,则应沿同步关系反查:等待主线程意味着渲染数据生产不及时;等待驱动可能与过量提交或资源操作有关;等待 GPU 则表示队列前方的 GPU 工作尚未完成。
验证修复时,一次只改变一个变量。例如先降低 Draw Call 数量,再比较相同场景下渲染线程的提交总时长;如果提交时间下降而等待 GPU 的时间上升,说明 CPU 侧压力减轻后,瓶颈已经转移到 GPU,应切换到 GPU 时间线继续分析。
渲染线程堵塞的本质不是“Draw Call 多”这一句话,而是命令提交、状态管理、资源准备和同步之间的累计成本。先用时间线区分执行与等待,再沿最长区块追到上游,才能把优化措施和真正的瓶颈对应起来。