
图形渲染与 Shader / 系统课时
GPU 时间到底怎么看
GPU 时间到底怎么看
GPU Profiler 往往同时展示 Frame Time、多个 Queue、Render Pass 和大量事件统计,如果直接寻找数字最大的项目,很容易把嵌套或并行执行误认为瓶颈。本节建立固定阅读顺序,从整帧 GPU 时间逐层下钻到真正占用执行窗口的 Pass 和事件。
学习目标
- 理解 GPU Frame Time 与 Queue、Pass、Event 的层级关系
- 正确处理队列并行、事件嵌套带来的统计差异
- 按固定顺序从整帧时间定位到值得继续分析的 GPU 工作
先确认 GPU Frame Time 测的是什么
GPU Frame Time 通常表示一帧相关 GPU 工作从开始执行到完成之间的时间跨度。最基本的理解可以写成 ,但具体起止点由分析工具和图形 API 的测量方式决定,因此比较数据前必须确认工具口径一致。
CPU 提交命令的时间不能直接当作 GPU 执行时间。CPU 可能快速把命令放入队列,而 GPU 仍在处理之前的工作;反过来,CPU 也可能因为等待 GPU 或帧同步而停顿。因此读 GPU 数据时,应首先看 GPU 自身的时间线,而不是只看 CPU 侧提交函数。
按 Queue、Pass、Event 逐层下钻
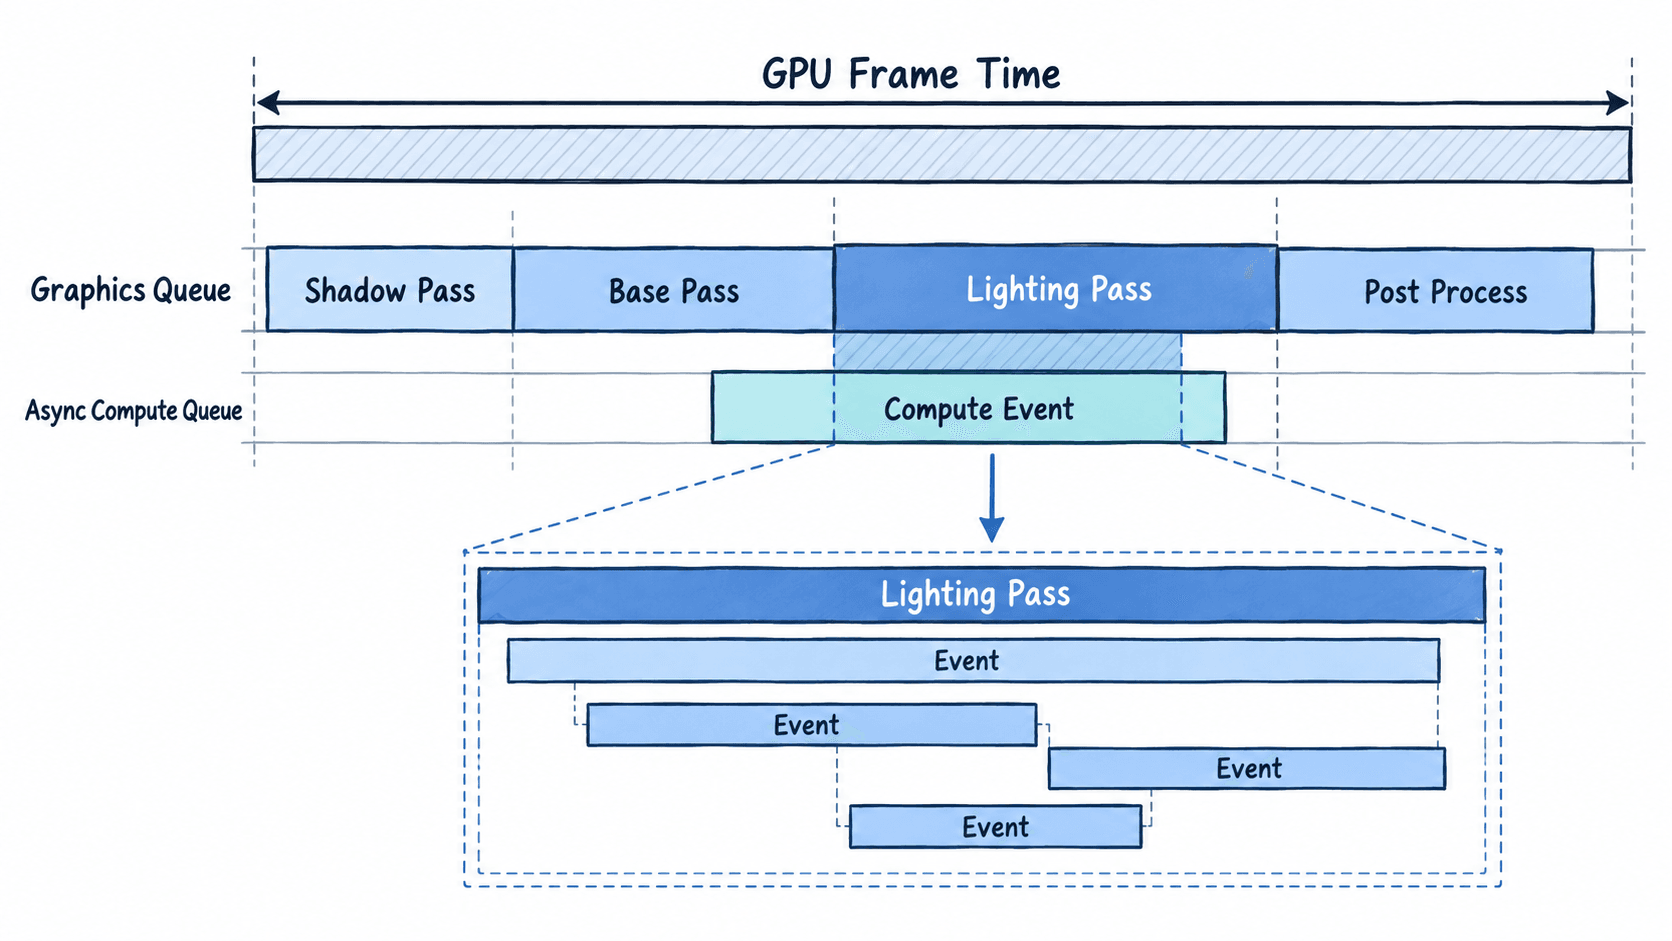
阅读 GPU 数据时,可以把它看成三个层级。Queue 表示提交到不同 GPU 队列的工作,Pass 表示一组具有明确渲染目的的工作,Event 则继续把 Pass 拆成更细的绘制、计算或资源处理操作。
下面是一份简化后的 Profiler 数据,它不是可执行代码,而是一帧 GPU 时间线的文本化快照。
GPU Frame                         16.7 ms
Graphics Queue                    15.9 ms
  Shadow Pass                      3.1 ms
  Base Pass                        5.8 ms
  Lighting Pass                    4.4 ms
  Post Process                     2.0 ms
Async Compute Queue                4.6 ms
  SSAO Compute                     4.1 ms
第一步看整帧 16.7 ms 是否已经超过目标预算。例如目标 60 FPS 时,一帧总预算约为 16.67 ms。第二步再看主要执行窗口落在哪个 Queue,随后进入耗时较长的 Pass,最后才展开内部 Event。这样可以避免一开始就在数百个绘制事件中迷失。
不要把所有事件时间直接相加
GPU 时间统计最常见的误区,是把屏幕上所有毫秒数相加后与 Frame Time 比较。事件可能存在父子嵌套,也可能在不同 Queue 上并行执行,所以它们的持续时间并不一定互斥。
假设 Lighting Pass 持续 4.4 ms,其中一个子事件持续 3.0 ms,这 3.0 ms 已经包含在父 Pass 的 4.4 ms 内,再次相加会重复计算。类似地,Async Compute 与 Graphics Queue 若有 3 ms 重叠,也不能直接用两个 Queue 的总时间相加得到整帧时间。
| 数据关系 | 是否可以直接相加 | 原因 |
|---|---|---|
| 同一 Queue 中前后串行的独立 Pass | 通常可以近似累加 | 执行区间互不重叠 |
| 父 Pass 与其子 Event | 不可以 | 子事件已包含在父事件中 |
| Graphics 与 Async Compute Queue | 不一定 | 两条队列可能并行执行 |
| 多次 Draw 的独立事件 | 需看时间线 | 还可能受到批次和嵌套统计影响 |
因此真正有价值的问题不是“这些事件加起来是多少”,而是“哪些工作实际占据了整帧关键执行窗口”。时间线位置和重叠关系通常比单个统计数字更重要。
用固定顺序读完一帧
面对一帧 GPU 数据时,可以按照同一条路径阅读。先确认 GPU Frame Time 是否异常,并与正常帧进行对比;随后观察各 Queue 的忙碌区间以及是否存在空洞、等待或重叠;再进入覆盖关键时间段的 Pass,最后展开其中最重的 Event。
如果一帧 GPU 时间为 18.2 ms,Graphics Queue 持续 17.5 ms,而 Async Compute 的 4 ms 完全位于 Graphics Queue 的执行窗口内,那么首先应研究 Graphics Queue,而不是把两者相加得到 21.5 ms。继续下钻后如果 Lighting Pass 占据 6.4 ms,它就成为更值得展开的区域。
先找执行窗口,再分析统计指标
GPU Profiler 中还可能出现调用次数、Primitive 数量、Dispatch 数量和各种硬件计数器。这些数据很重要,但阅读顺序不应颠倒。先通过 Frame、Queue、Pass 和 Event 找到时间真正集中在哪里,再用统计指标解释该区域为什么昂贵,定位效率会高得多。
同一个事件在 1080p 下耗时 2 ms、在 4K 下接近 8 ms,可能提示像素相关成本;一个 Pass 随 Draw Call 数增加明显变慢,则可能更接近提交批次、状态切换或几何处理问题。只有把这些统计放回时间线中的具体执行窗口,GPU 数据才会从一堆数字变成可以继续验证的性能线索。