
图形渲染与 Shader / 系统课时
主线程时间花在哪
主线程时间花在哪
主线程优化的第一步不是看到某个函数“很慢”就改代码,而是先把一帧拆成输入、逻辑、物理、动画和场景更新等阶段,确认时间真正消耗在哪一段。学完本节后,你可以用时间线从“帧超时”追到具体阶段,并区分持续热点、偶发尖峰与线程等待。
学习目标
- 能按一帧执行顺序识别主线程常见 CPU 热点
- 能从时间线区分计算耗时、等待与偶发尖峰
- 能用简单打点验证某个阶段是否真的是瓶颈
先从一帧时间线找最大块
分析主线程时,先选一帧明显超出目标预算的样本,再沿时间轴看主线程从帧开始到帧结束经历了什么。不要一上来就钻进最深的调用栈,因为父阶段的总耗时更适合回答“时间花在哪”,子函数则用于回答“为什么这里这么慢”。
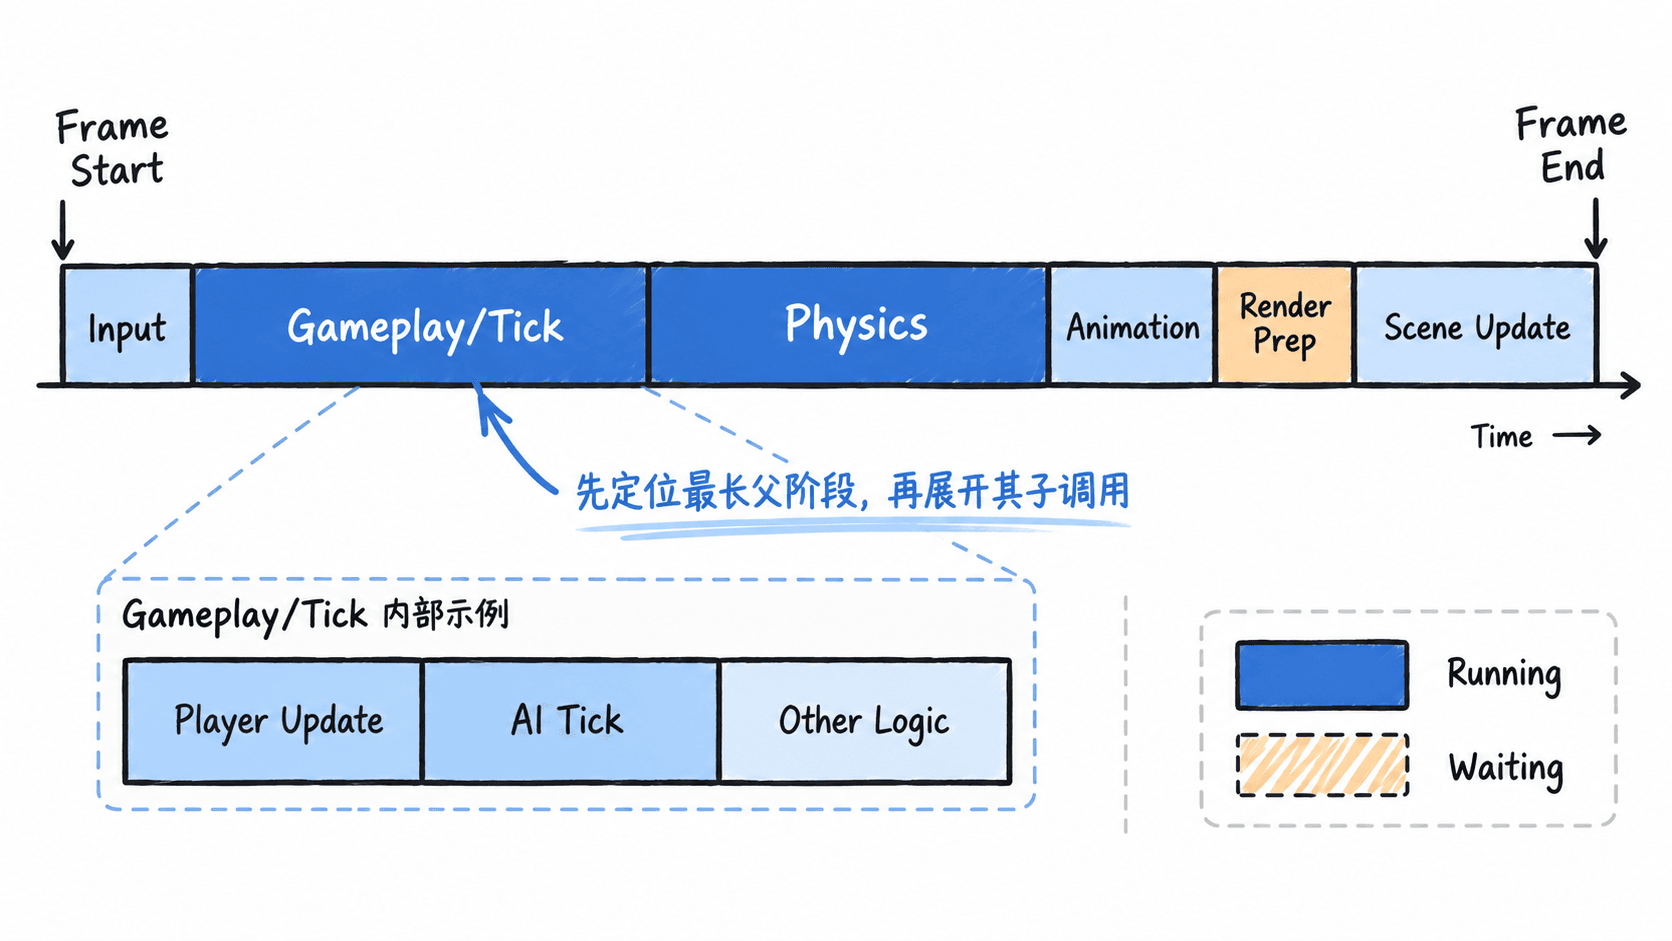
同一帧里最宽的区块通常是首要调查对象,但还要确认它是“正在执行”还是“在等别的线程”。如果主线程长时间处于等待,继续优化该线程上的普通函数往往没有效果,应转而检查任务系统、渲染线程或同步点。
常见阶段分别看什么
输入处理通常很短,如果它异常变长,要检查是否把设备扫描、手势识别或事件分发做成了高频遍历。游戏逻辑或 Tick 变长时,重点关注每帧遍历对象数量、脚本调用层级、AI 决策频率,以及本可降频却仍逐帧执行的系统。
| 阶段 | 时间线上的典型现象 | 下一步检查 |
|---|---|---|
| 游戏逻辑 / Tick | 每帧都有较宽区块 | 大量逐帧遍历、AI、脚本、组件更新 |
| 物理 | 碰撞密集场景突然放大 | 活跃刚体数、接触对、复杂碰撞体 |
| 动画 | 角色增多后近似线性上涨 | 骨骼数量、动画图求值、蒙皮前置计算 |
| 场景更新 | 大量对象创建或移动时升高 | Transform 传播、层级过深、批量增删对象 |
| 等待 | 区块本身没有持续执行 | Job、渲染线程、GPU 或锁同步 |
判断热点时要同时观察“宽度”和“出现频率”。某阶段偶尔一次 8 ms 尖峰与连续几百帧稳定占用 5 ms 的处理策略不同:前者通常查资源加载、对象回收或批量任务,后者更像持续性的算法或工作量问题。
用阶段打点验证判断
如果现有 Profiler 只能看到一个很大的业务阶段,可以在代码边界增加轻量计时。下面用标准 C++ 演示最小做法,示例可直接运行;真实项目中把 sleep_for 替换为对应阶段的实际调用即可。
#include <chrono>
#include <iostream>
#include <string>
#include <thread>
#include <utility>

class ScopedTimer {
public:
    explicit ScopedTimer(std::string name)
        : name_(std::move(name)), start_(Clock::now()) {}

    ~ScopedTimer() {
        const auto end = Clock::now();
        const auto us = std::chrono::duration_cast<std::chrono::microseconds>(end - start_).count();
        std::cout << name_ << ": " << us << " us\n";
    }

private:
    using Clock = std::chrono::steady_clock;
    std::string name_;
    Clock::time_point start_;
};

void updatePhysics() {
    ScopedTimer timer("Physics");
    std::this_thread::sleep_for(std::chrono::milliseconds(3));
}

void updateAnimation() {
    ScopedTimer timer("Animation");
    std::this_thread::sleep_for(std::chrono::milliseconds(1));
}

int main() {
    updatePhysics();
    updateAnimation();
    return 0;
}
预期输出如下,具体耗时会随操作系统调度而变化,因此用 <TIME> 表示动态值。
Physics: <TIME> us
Animation: <TIME> us
打点应围绕“一个可采取行动的阶段”展开,而不是给每个小函数都加计时。标记过细会增加分析噪声,也可能让你只盯着单次调用而忽略累计次数。
从父阶段继续追到根因
确定最宽的父阶段后,再展开调用树或火焰视图。此时重点看两个指标:单次调用是否很慢,以及同一函数是否被调用了过多次。一个函数每次只需 0.02 ms,但一帧调用 500 次,累计仍然是 10 ms;只看单次耗时会完全错过这种热点。
还要避免把“被阻塞时间”误判为计算热点。若主线程在等待 Job 完成、等待渲染线程消费命令或等待锁,时间线会表现为一段很长的空等区间。真正的修复方向通常是减少同步、提前并行任务或降低下游压力,而不是继续微优化等待点附近的代码。
什么时候可以下结论
至少比较多个相似帧,再决定某阶段是不是稳定瓶颈。稳定热点应在相同游戏状态下重复出现,并且优化后能让主线程总时长同步下降;如果只是某个子函数数字变小,但整帧时间没有变化,就说明瓶颈可能已经转移,或者原先看到的只是等待链上的表象。
主线程时间线的核心方法是先看一帧的整体执行链,再从最大父阶段逐层下钻。只要始终区分“正在算什么”和“正在等什么”,就能避免把精力花在对整帧几乎没有影响的局部函数上。