
图形渲染与 Shader / 系统课时
GPU Profiler 怎样找到大 Pass
GPU Profiler 怎样找到大 Pass
GPU Profiler 的价值不是告诉你“GPU 很忙”,而是把一帧时间逐层拆到 Render Pass、Draw 和 Dispatch,最终定位真正消耗预算的工作。本节建立一条可重复的下钻路径:先找最贵的 Pass,再判断它为什么贵,而不是直接盯着 Draw Call 数量猜问题。
学习目标
- 按 GPU Frame → Render Pass → Draw/Dispatch 的顺序定位主要耗时
- 区分“大 Pass”与“Pass 内单个异常调用”两类问题
- 用多帧数据验证热点,避免被单帧波动误导
先确认 GPU Frame 本身是否值得下钻
开始分析前,先观察连续多帧 GPU 时间,而不是只看某一帧。假设目标是 60 FPS,一帧总预算约为 16.67 ms;如果 CPU 已经明显限制帧率,而 GPU 只有 6 ms,那么此时继续深挖 GPU Pass 通常不是最高优先级。
GPU 确实接近或超过预算后,再进入 GPU 事件树。不同工具可能把顶层节点称为 Frame、Command Buffer、Queue Submission 或 GPU Work,但分析目标相同:找到占据帧时间主要比例的那组工作。
从 Frame 逐层找到最大的 Render Pass
第一轮不要展开所有 Draw。先比较较粗粒度的 Render Pass,例如阴影、深度预处理、GBuffer、光照、透明物体、后处理和 UI,快速判断时间集中在哪里。
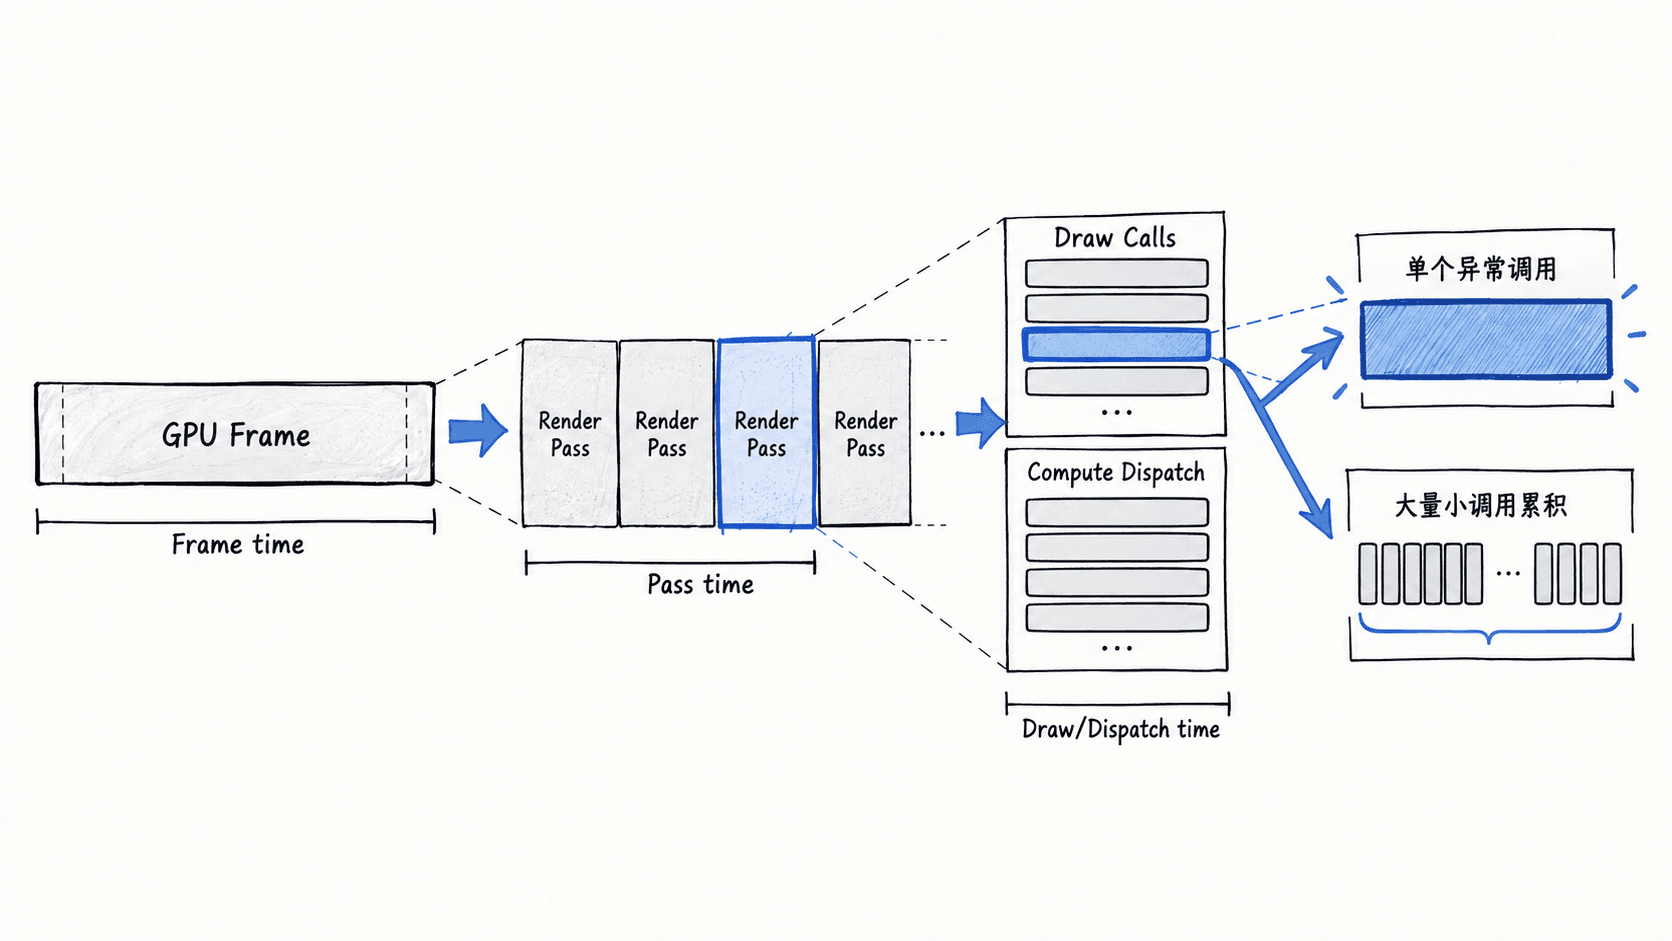
例如一帧 GPU 时间为 18 ms,其中后处理占 7 ms、阴影占 4 ms、其余 Pass 合计约 7 ms,那么后处理应当先分析。即使阴影包含更多 Draw Call,也不意味着它比后处理更值得先处理。
真正有用的排序依据通常是时间贡献,而不是事件数量。可以同时记录绝对耗时和占帧比例,例如 7 ms / 18 ms 约占 39%,这样更容易判断优化收益上限。
在大 Pass 里继续看 Draw 和 Dispatch
进入最贵 Pass 后,重点区分两种形态。第一种是某个 Draw 或 Dispatch 明显比周围调用贵,例如一个全屏后处理 Dispatch 占掉 3 ms;第二种是没有单个异常调用,但数百个较小 Draw 累积成很大的 Pass。
前者通常需要继续检查该调用对应的着色器、分辨率、采样次数、线程组规模、Render Target 或资源访问。后者则更可能涉及过度绘制、对象数量、状态切换、材质拆分、过多小批次或重复执行。
如果 Profiler 支持查看事件关联的 Pipeline、Shader、Render Target、Dispatch Size 或 Primitive Count,应把这些信息与耗时一起记录。它们是解释“为什么贵”的证据,而不是只保留一个毫秒数。
用导出数据快速排序热点
部分 Profiler 支持把事件时间导出成 CSV。下面的完整 Python 示例演示如何从一组已整理的 Pass 计时中按耗时排序,用于辅助确定下钻顺序;它不替代 Profiler 本身的 GPU 时间线。
passes = {
    "Shadow": 4.0,
    "GBuffer": 3.2,
    "Lighting": 2.1,
    "PostProcess": 7.0,
    "UI": 0.6,
}

total_ms = sum(passes.values())

for name, ms in sorted(passes.items(), key=lambda item: item[1], reverse=True):
    ratio = ms / total_ms * 100
    print(f"{name}: {ms:.1f} ms ({ratio:.1f}%)")
预期输出:
PostProcess: 7.0 ms (41.4%)
Shadow: 4.0 ms (23.7%)
GBuffer: 3.2 ms (18.9%)
Lighting: 2.1 ms (12.4%)
UI: 0.6 ms (3.6%)
这里的总和只是示例数据可以直接相加。真实 GPU 时间线可能存在异步计算、并行 Queue 或统计口径差异,因此不能把所有事件时长简单相加后当作真实 Frame Time。
最后用多帧验证热点是否稳定
一次捕获只能说明“这一帧发生了什么”。相机移动、粒子爆发、阴影更新、动态分辨率和资源流式加载都可能让某个 Pass 暂时变大,因此至少应在相同场景下观察多帧,并记录典型帧而不是只挑最差的一帧。
稳定的分析路径应保持一致:先确认 GPU Frame 是否超预算,再找贡献最大的 Pass,然后进入 Pass 查 Draw 或 Dispatch,最后结合 Shader、资源和工作量解释原因。这样得到的是可验证的热点,而不是由 Draw Call 数量或某个醒目的事件名称推导出的猜测。